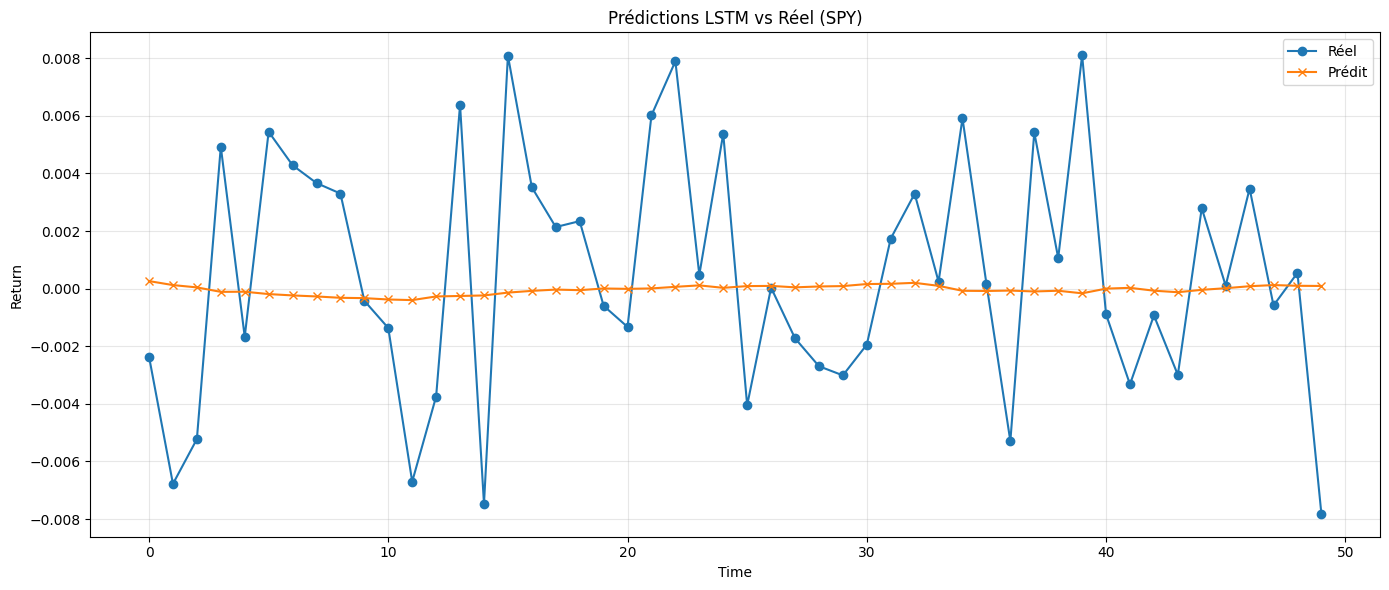
# VRAI LSTM via tensorflow/keras. tensorflow (2.19.1) + keras (3.13.0) sont installes
# dans le runtime quantconnect/research:latest -- la ou ce quantbook s'execute reellement.
# Ce notebook utilisait auparavant sklearn.Ridge comme "proxy LSTM" en aplatissant les
# sequences 3D -- une simplification qui detruisait precisement la dependance temporelle
# que un LSTM est cense modeliser. La lib reelle etant disponible, verdict RECOVERABLE-LOCAL
# (voir #8757, regle sota-not-workaround Prong-A).

import os
os.environ.setdefault("TF_CPP_MIN_LOG_LEVEL", "3")  # supprime INFO/WARNING/ERROR (NodeDef noise)
os.environ.setdefault("TF_ENABLE_ONEDNN_OPTS", "0")  # evite les FutureWarning oneDNN
os.environ.setdefault("GRPC_VERBOSITY", "ERROR")

import numpy as np
import tensorflow as tf
from tensorflow.keras.models import Sequential

# Reduire le bruit TF (NodeDef use_unbounded_threadpool + tf.function retracing) :
# messages de mismatch de version internes a TF, benins, mais nombreux dans les loops.
tf.get_logger().setLevel("FATAL")
import logging as _stdlib_logging
_stdlib_logging.getLogger("tensorflow").setLevel(_stdlib_logging.ERROR)
from tensorflow.keras.layers import LSTM, Dense, Dropout, Input

# Reproductibilite (C896) : un LSTM est stochastique (init des poids + dropout en train).
# On seed TF + numpy + python pour que la re-exec donne des metriques stables.
tf.keras.utils.set_random_seed(42)
tf.config.experimental.enable_op_determinism()

EPOCHS = 15      # borne pour runtime pedagogique raisonnable (Prong-B)
BATCH = 32


def build_lstm_model(input_shape):
    """Construit un modele LSTM (Keras).

    Architecture : 2 couches LSTM (64 puis 32 unites) avec dropout pour regulariser,
    suivies de 2 couches denses. input_shape = (timesteps, features).
    """
    model = Sequential([
        Input(shape=input_shape),
        LSTM(64, return_sequences=True),
        Dropout(0.2),
        LSTM(32, return_sequences=False),
        Dropout(0.2),
        Dense(16, activation="relu"),
        Dense(1),
    ])
    model.compile(optimizer="adam", loss="mse")
    return model


def train_model(X_train, y_train, X_test, y_test, epochs=EPOCHS, verbose=0):
    """Entrainne le LSTM sur les sequences 3D (samples, timesteps, features)."""
    model = build_lstm_model(input_shape=(X_train.shape[1], X_train.shape[2]))
    history = model.fit(
        X_train, y_train,
        validation_data=(X_test, y_test),
        epochs=epochs,
        batch_size=BATCH,
        verbose=verbose,
        shuffle=False,  # series temporelles : on preserve l'ordre
    )
    train_pred = model.predict(X_train, verbose=0).ravel()
    test_pred = model.predict(X_test, verbose=0).ravel()

    train_mse = float(((y_train - train_pred) ** 2).mean())
    test_mse = float(((y_test - test_pred) ** 2).mean())
    return model, train_mse, test_mse, history


# Split train/test
split_idx = int(len(X_normalized) * 0.8)

X_train, X_test = X_normalized[:split_idx], X_normalized[split_idx:]
y_train, y_test = y_normalized[:split_idx], y_normalized[split_idx:]

print(f"Build LSTM: input_shape=({X_train.shape[1]}, {X_train.shape[2]}) -- "
      f"{X_train.shape[0]} train seq / {X_test.shape[0]} test seq")

# Entrainner
model, train_mse, test_mse, history = train_model(X_train, y_train, X_test, y_test)

print(f"Train MSE: {train_mse:.6f}")
print(f"Test MSE: {test_mse:.6f}")
print(f"epochs={EPOCHS}, batch={BATCH}, seed=42")