Notebook de Recherche : Deep Learning LSTM pour la Prediction de Prix
Ce notebook accompagne QC-Py-22-Deep-Learning-LSTM et demontre le workflow complet d’entrainement d’un modèle LSTM avec PyTorch dans l’environnement QuantBook.
Objectifs d’apprentissage
Charger et preparer des données de prix avec MinMaxScaler
Créer des sequences temporelles pour l’entree LSTM
Définir et entrainer un modèle LSTM avec PyTorch
Evaluer les performances et visualiser les predictions
Sauvegarder le modèle via ObjectStore pour l’integration dans main.py
Duree estimee : 60 minutes
Prerequis : QC-Py-04-Research-Workflow, bases de PyTorch
1. Configuration et Imports
Import des librairies necessaires et configuration de l’environnement QuantBook.
# Imports QuantBookfrom QuantConnect.Research import QuantBookfrom QuantConnect import Resolution# Imports standardsimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.preprocessing import MinMaxScalerfrom sklearn.metrics import mean_squared_errorimport warningswarnings.filterwarnings('ignore')# Configuration matplotlibplt.rcParams['figure.figsize'] = (12, 6)plt.rcParams['axes.grid'] =Trueplt.style.use('seaborn-v0_8-whitegrid')print("Imports termines avec succes")
Imports termines avec succes
On charge ici les données historiques de marché nécessaires à l’entraînement du réseau de neurones LSTM.
# Import PyTorchimport torchimport torch.nn as nnfrom torch.utils.data import DataLoader, TensorDataset# Verification du device (CPU dans QuantBook)device = torch.device('cuda'if torch.cuda.is_available() else'cpu')print(f"PyTorch version: {torch.__version__}")print(f"Device utilise: {device}")
PyTorch version: 2.8.0+cu128
Device utilise: cpu
2. Chargement des Données
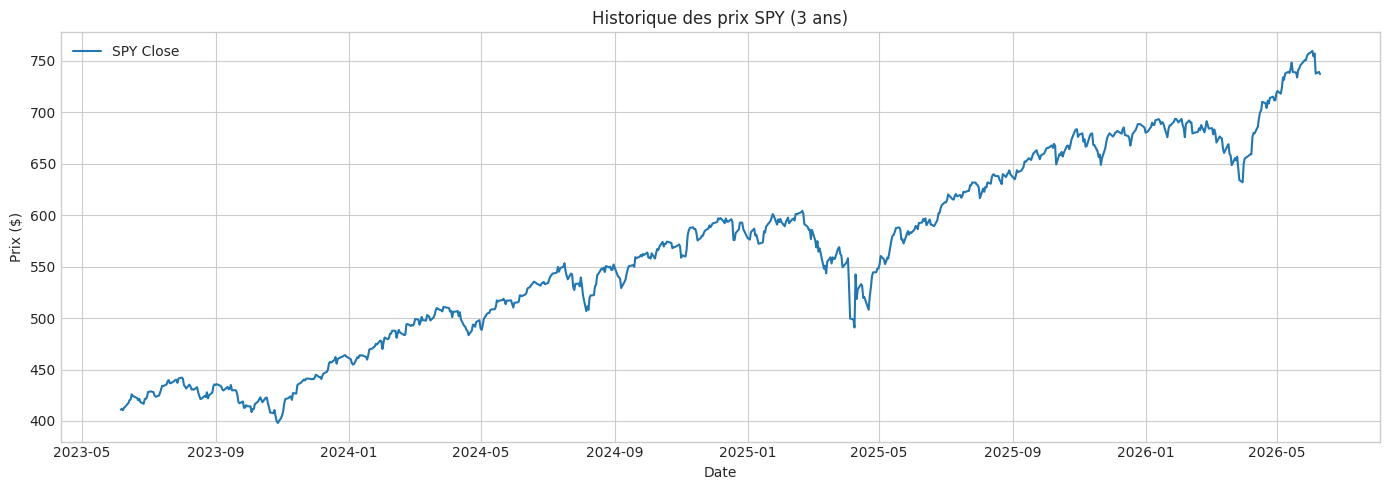
Utilisation de QuantBook pour recuperer l’historique des prix de SPY.
# Initialisation QuantBookqb = QuantBook()# Ajout de l'actifsymbol = qb.add_equity("SPY", Resolution.DAILY).symbol# Recuperation de l'historique (3 ans)history = qb.history(symbol, 252*3, Resolution.DAILY)# Extraction des prix de clotureifisinstance(history.index, pd.MultiIndex): prices = history['close'].xs(symbol, level=0)else: prices = history['close']prices = prices.sort_index()print(f"Donnees chargees: {len(prices)} jours")print(f"Periode: {prices.index[0].date()} a {prices.index[-1].date()}")prices.head()
Donnees chargees: 756 jours
Periode: 2023-06-05 a 2026-06-09
Forme des donnees normalisees: (756, 1)
Plage: [0.0000, 1.0000]
On construit l’architecture du réseau LSTM avec ses couches récurrentes et les couches denses de sortie.
def create_sequences(data, seq_length):""" Cree des sequences pour l'entree LSTM. Args: data: Donnees normalisees (n_samples, n_features) seq_length: Longueur de la sequence (fenetre) Returns: X: Sequences d'entree (n_samples, seq_length, n_features) y: Cibles (n_samples, n_features) """ X, y = [], []for i inrange(len(data) - seq_length): X.append(data[i:i+seq_length]) y.append(data[i+seq_length])return np.array(X), np.array(y)# ParametresSEQ_LENGTH =60# 60 jours de lookback# Creation des sequencesX, y = create_sequences(prices_scaled, SEQ_LENGTH)print(f"Forme X: {X.shape} (samples, sequence_length, features)")print(f"Forme y: {y.shape} (samples, features)")
Forme X: (696, 60, 1)  (samples, sequence_length, features)
Forme y: (696, 1)  (samples, features)
Comprendre la forme des données
Pour un LSTM, l’entree doit avoir 3 dimensions: - samples: Nombre de sequences d’entrainement - sequence_length: Nombre de pas de temps (jours) par sequence - features: Nombre de variables par pas de temps (1 = prix de cloture)
Avec 756 jours et seq_length=60, nous obtenons 696 sequences.
# Division temporelle (pas de shuffle pour series temporelles)train_size =int(len(X) *0.8)X_train, X_test = X[:train_size], X[train_size:]y_train, y_test = y[:train_size], y[train_size:]# Conversion en tenseurs PyTorchX_train_t = torch.FloatTensor(X_train).to(device)y_train_t = torch.FloatTensor(y_train).to(device)X_test_t = torch.FloatTensor(X_test).to(device)y_test_t = torch.FloatTensor(y_test).to(device)print(f"Train: {X_train_t.shape}, Test: {X_test_t.shape}")
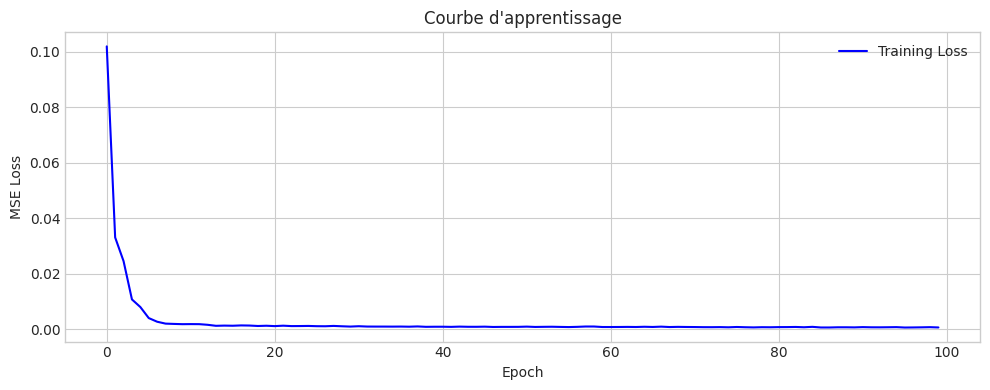
On évalue les prédictions du LSTM sur l’ensemble de validation pour mesurer la précision du modèle.
# Visualisation de la lossfig, ax = plt.subplots(figsize=(10, 4))ax.plot(train_losses, label='Training Loss', color='blue')ax.set_xlabel('Epoch')ax.set_ylabel('MSE Loss')ax.set_title("Courbe d'apprentissage")ax.legend()plt.tight_layout()plt.show()
6. Evaluation et Visualisation
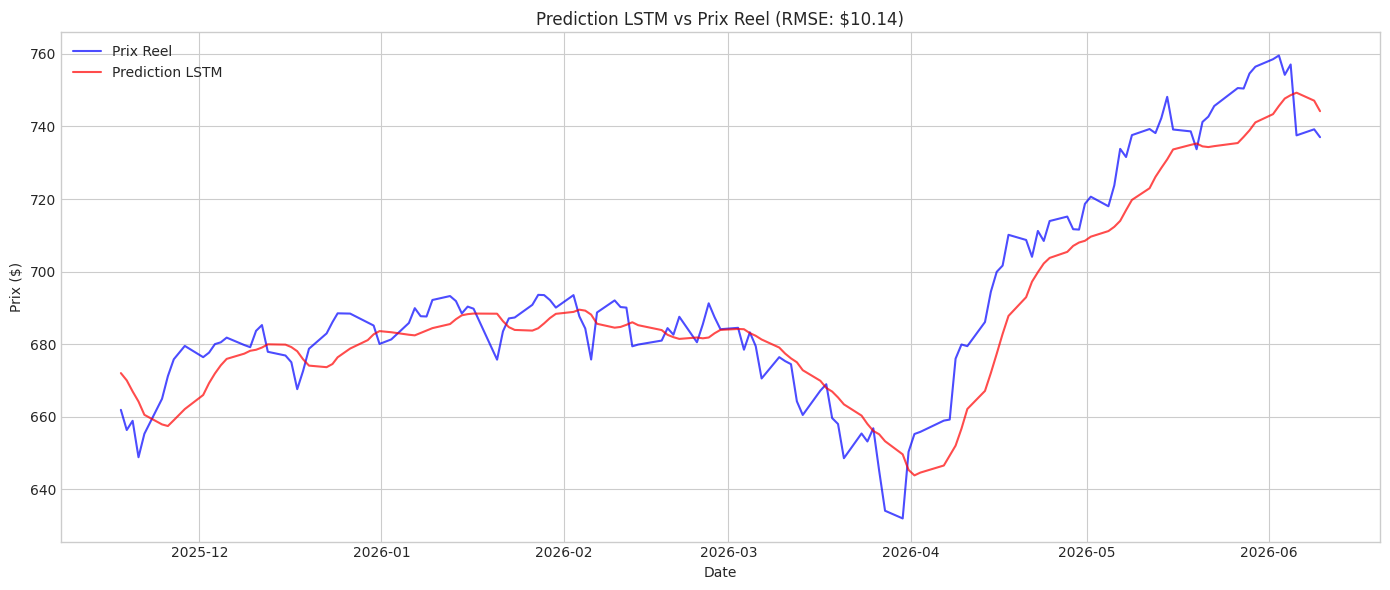
Prediction sur l’ensemble de test et calcul des metriques.
# Modele en mode evaluationmodel.eval()with torch.no_grad(): y_pred_scaled = model(X_test_t).cpu().numpy()# Inverse transformation pour obtenir les prix reelsy_pred = scaler.inverse_transform(y_pred_scaled)y_actual = scaler.inverse_transform(y_test)# Calcul du RMSErmse = np.sqrt(mean_squared_error(y_actual, y_pred))print(f"RMSE sur l'ensemble de test: ${rmse:.2f}")# Calcul du MAPEmape = np.mean(np.abs((y_actual - y_pred) / y_actual)) *100print(f"MAPE: {mape:.2f}%")
RMSE sur l'ensemble de test: $10.14
MAPE: 1.21%
On visualise les prédictions du modèle par rapport aux valeurs réelles pour analyser la qualité des signaux générés.
# Visualisation des predictionstest_dates = prices.index[train_size + SEQ_LENGTH:]fig, ax = plt.subplots(figsize=(14, 6))ax.plot(test_dates, y_actual, label='Prix Reel', color='blue', alpha=0.7)ax.plot(test_dates, y_pred, label='Prediction LSTM', color='red', alpha=0.7)ax.set_xlabel('Date')ax.set_ylabel('Prix ($)')ax.set_title(f'Prediction LSTM vs Prix Reel (RMSE: ${rmse:.2f})')ax.legend()plt.tight_layout()plt.show()
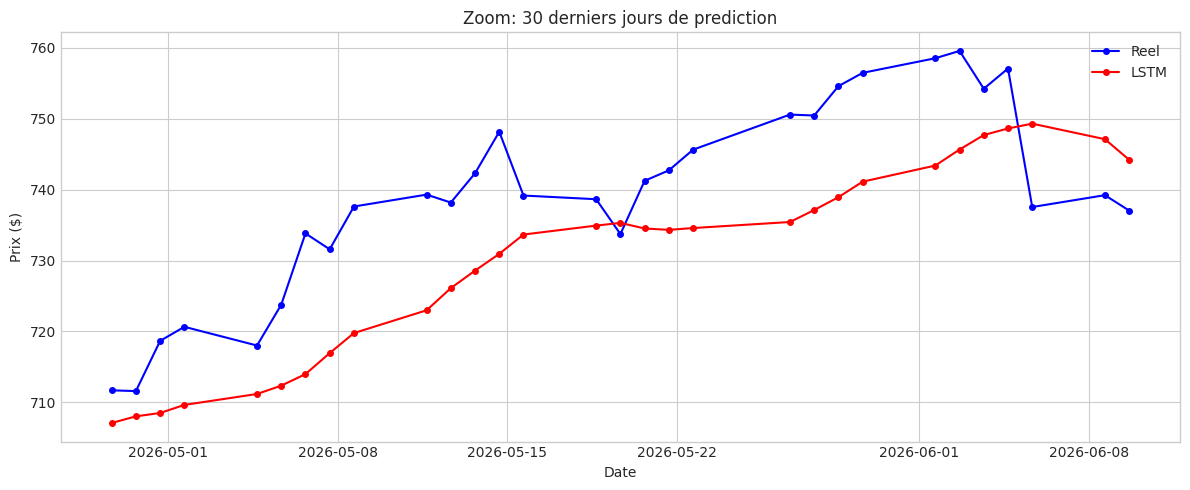
On génère les signaux de trading à partir des prédictions du LSTM et on les intègre dans la stratégie algorithmique.
# Zoom sur les 30 derniers jourszoom_days =30fig, ax = plt.subplots(figsize=(12, 5))ax.plot(test_dates[-zoom_days:], y_actual[-zoom_days:], 'o-', label='Reel', color='blue', markersize=4)ax.plot(test_dates[-zoom_days:], y_pred[-zoom_days:], 'o-', label='LSTM', color='red', markersize=4)ax.set_xlabel('Date')ax.set_ylabel('Prix ($)')ax.set_title('Zoom: 30 derniers jours de prediction')ax.legend()plt.tight_layout()plt.show()
7. Sauvegarde via ObjectStore
Le modèle est sauvegarde dans l’ObjectStore QuantConnect pour etre charge dans main.py.
import io# Sauvegarde du modele dans un bufferbuffer= io.BytesIO()torch.save({'model_state_dict': model.state_dict(),'hidden_size': 50,'num_layers': 2,'seq_length': SEQ_LENGTH,'scaler_min': scaler.data_min_[0],'scaler_max': scaler.data_max_[0]}, buffer)# Sauvegarde dans l'ObjectStoreqb.object_store.save_bytes('lstm_spy_model', buffer.getvalue())print("Modele sauvegarde dans l'ObjectStore: lstm_spy_model")print(f"Taille: {len(buffer.getvalue()) /1024:.1f} KB")
Modele sauvegarde dans l'ObjectStore: lstm_spy_model
Taille: 125.2 KB
On évalue les performances de la stratégie LSTM sur les données hors échantillon pour valider la robustesse du modèle.
# Verification de la sauvegardesaved_data = qb.object_store.read_bytes('lstm_spy_model')print(f"Verification: {len(saved_data)} bytes lus depuis l'ObjectStore")# Test de chargement# weights_only=False : requis depuis PyTorch 2.6 car le checkpoint contient# des scalaires numpy (scaler_min/max) en plus du state_dict ; source de# confiance puisque genere par la cellule precedente.test_buffer = io.BytesIO(saved_data)checkpoint = torch.load(test_buffer, map_location=device, weights_only=False)print(f"Checkpoint keys: {list(checkpoint.keys())}")
Code a copier dans votre algorithme pour utiliser le modèle.
# === CODE A COPIER DANS main.py ===# Dans Initialize():"""def Initialize(self): # ... configuration standard ... # Charger le modele LSTM depuis ObjectStore model_bytes = self.object_store.read_bytes('lstm_spy_model') buffer = io.BytesIO(model_bytes) checkpoint = torch.load(buffer, map_location='cpu') self.lstm_model = LSTMModel( hidden_size=checkpoint['hidden_size'], num_layers=checkpoint['num_layers'] ) self.lstm_model.load_state_dict(checkpoint['model_state_dict']) self.lstm_model.eval() self.seq_length = checkpoint['seq_length'] self.scaler_min = checkpoint['scaler_min'] self.scaler_max = checkpoint['scaler_max'] self.price_history = []"""# Dans OnData():"""def OnData(self, data): if "SPY" not in data: return # Ajouter le prix a l'historique self.price_history.append(data["SPY"].Close) if len(self.price_history) < self.seq_length: return # Preparer la sequence recent_prices = np.array(self.price_history[-self.seq_length:]) normalized = (recent_prices - self.scaler_min) / (self.scaler_max - self.scaler_min) X = torch.FloatTensor(normalized).unsqueeze(0).unsqueeze(2) # Prediction with torch.no_grad(): pred_normalized = self.lstm_model(X).item() # Denormaliser predicted_price = pred_normalized * (self.scaler_max - self.scaler_min) + self.scaler_min # Logique de trading basee sur la prediction current_price = data["SPY"].Close if predicted_price > current_price * 1.01: # +1% prediction self.SetHoldings("SPY", 1.0) elif predicted_price < current_price * 0.99: # -1% prediction self.Liquidate("SPY")"""print("Code d'integration affiche ci-dessus")
Code d'integration affiche ci-dessus
Conclusion et Prochaines Étapes
Resume
Dans ce notebook, vous avez appris a: - Preparer des données de prix pour un LSTM avec normalisation MinMax - Créer des sequences temporelles avec fenêtre glissante - Définir et entrainer un modèle LSTM bidimensionnel avec PyTorch - Evaluer les predictions avec RMSE et MAPE - Sauvegarder le modèle via ObjectStore pour l’integration dans main.py
Exercices suggeres
Ajouter des features: Inclure le volume, RSI, ou EMA comme entrees supplementaires
Optimiser les hyperparametres: Tester différentes valeurs de hidden_size, num_layers, learning_rate
Comparer avec un baseline: Comparer les predictions LSTM avec un simple modèle ARIMA
Multi-step prediction: Modifier le modèle pour predire plusieurs jours a l’avance