Utiliser QuantBook pour charger et explorer les données financieres
Créer des features techniques pour le Machine Learning (RSI, EMA, MACD)
Construire une variable cible pour la prediction de direction
Entrainer un RandomForestClassifier avec validation temporelle
Evaluer les performances avec metriques de classification
Persister le modèle via ObjectStore pour l’utiliser dans un algorithme
Prerequis
Notebook QC-Py-04 (Research Workflow) recommande
Connaissance de base sklearn (fit, predict, classification_report)
Compte QuantConnect avec acces Research
Duree estimee : 45 minutes
IMPORTANT - Mode d’emploi de ce notebook
Ce notebook est concu pour etre execute dans QuantConnect Research Environment (QuantBook). Il utilise l’API synchrone de QuantBook pour explorer les données et entrainer un modèle ML.
Workflow de développement ML sur QuantConnect : 1. Recherche (ce notebook) : Explorer, entrainer, evaluer en QuantBook 2. Persistance : Sauvegarder le modèle dans ObjectStore 3. Production : Charger le modèle dans main.py pour le trading
Voir le notebook QC-Py-19 pour la théorie complete sur la classification ML.
1. Setup QuantBook (5 min)
Imports et Configuration
Commencons par importer les modules necessaires et configurer l’environnement.
# Imports QuantConnectfrom QuantConnect import*from QuantConnect.Data import*from QuantConnect.Research import QuantBook# Imports pour analyse et MLimport pandas as pdimport numpy as npfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.model_selection import train_test_split, TimeSeriesSplitfrom sklearn.metrics import classification_report, confusion_matrix, accuracy_scoreimport matplotlib.pyplot as plt# Configuration matplotlib (compatible QuantBook - pas de magic commands)plt.rcParams['figure.figsize'] = (12, 6)plt.rcParams['axes.grid'] =Trueplt.rcParams['axes.facecolor'] ='#f8f8f8'plt.rcParams['font.size'] =10print("Imports reussis")
Imports reussis
Creation de l’Instance QuantBook
QuantBook est l’API de recherche synchrone de QuantConnect. Contrairement a QCAlgorithm qui est event-driven, QuantBook permet d’executer du code cellule par cellule dans un notebook Jupyter.
Securities ajoutees:
  SPY: SPY
  QQQ: QQQ

Total securities: 2
Recuperer les Données Historiques
Point cle : qb.History() retourne directement un DataFrame pandas avec MultiIndex (symbol, time), contrairement a self.History() dans QCAlgorithm qui retourne un objet Slice.
Cette API synchrone est ideale pour la recherche et le prototypage ML.
# Recuperer 2 ans de donnees (504 jours de trading)history = qb.History(qb.Securities.Keys, 504, Resolution.Daily)print(f"Type de history: {type(history)}")print(f"Shape: {history.shape}")print(f"\nPremieres lignes:")history.head()
Type de history: <class 'pandas.core.frame.DataFrame'>
Shape: (1008, 5)

Premieres lignes:
close
high
low
open
volume
symbol
time
SPY
2024-06-05 16:00:00
521.967684
521.967684
516.188328
518.150575
40587259.0
2024-06-06 16:00:00
521.957922
522.690104
520.024961
522.260557
27382947.0
2024-06-07 16:00:00
521.323364
524.134943
519.898050
521.020729
35375224.0
2024-06-10 16:00:00
522.934165
523.256325
519.927337
520.571657
32232296.0
2024-06-11 16:00:00
524.193518
524.252092
519.409929
521.401464
31617845.0
Extraire les Données SPY
Pour simplifier l’analyse, concentrons-nous sur SPY dans un premier temps.
Features creees. Colonnes: 20

Liste des features:
['close', 'high', 'low', 'open', 'volume', 'rsi_14', 'ema_10', 'ema_20', 'ema_50', 'macd_line', 'macd_signal', 'macd_histogram', 'returns_1d', 'returns_5d', 'returns_10d', 'price_ema10_ratio', 'price_ema20_ratio', 'price_ema50_ratio', 'volatility_10d', 'volatility_20d']
Creation de la Variable Cible (Target)
Pour la classification, nous devons définir ce que nous voulons predire. Ici, nous allons predire la direction du marche a J+1 : - 1 : Le prix monte le lendemain - 0 : Le prix baisse ou reste stable le lendemain
# Calculer le return du jour suivantdf['next_day_return'] = df['close'].pct_change().shift(-1)# Creer le label binaire (1 = hausse, 0 = baisse/flat)df['target'] = (df['next_day_return'] >0).astype(int)print("Variable cible creee")print(f"\nDistribution des classes:")print(df['target'].value_counts())print(f"\nProportion de hausses: {df['target'].mean():.2%}")
Variable cible creee

Distribution des classes:
target
1    290
0    214
Name: count, dtype: int64

Proportion de hausses: 57.54%
Nettoyage des Données
Les indicateurs rolling et les shifts generent des NaN. Supprimons les lignes incompletes.
# Definir les colonnes de features (exclure colonnes non-predictives)feature_cols = ['rsi_14', 'ema_10', 'ema_20', 'ema_50','macd_line', 'macd_signal', 'macd_histogram','returns_1d', 'returns_5d', 'returns_10d','price_ema10_ratio', 'price_ema20_ratio', 'price_ema50_ratio','volatility_10d', 'volatility_20d']# Dataset nettoydf_clean = df[feature_cols + ['target']].dropna()print(f"Dataset apres nettoyage: {df_clean.shape}")print(f"\nLignes supprimees: {len(df) -len(df_clean)}")print(f"\nApercu du dataset nettoy:")df_clean.head()
Point crucial : La variable cible utilise .shift(-1) pour regarder le return du jour suivant. C’est ce que nous voulons predire. Si nous oublions le shift, nous aurions un lookahead bias (tricher en voyant le futur).
4. Model Training (10 min)
Split Train/Test Temporel
RÈGLE D’OR : Pour les series temporelles, JAMAIS de random shuffle ! Nous devons respecter l’ordre chronologique pour eviter le lookahead bias.
Utilisons un split 70/30 chronologique : les 70% premiers jours pour l’entrainement, les 30% suivants pour le test.
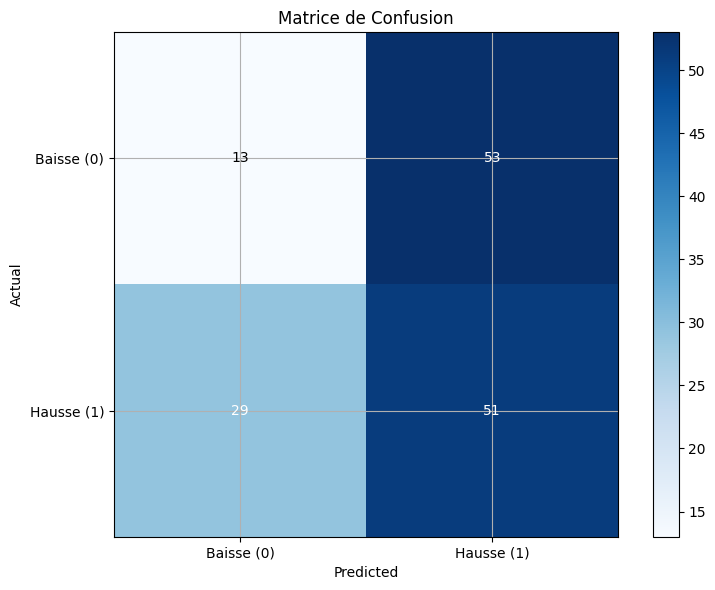
# Predictions sur le set de testy_pred = model.predict(X_test)y_pred_proba = model.predict_proba(X_test)[:, 1]# Accuracyaccuracy = accuracy_score(y_test, y_pred)print(f"Accuracy sur le set de test: {accuracy:.2%}")print(f"\nRapport de classification:")print(classification_report(y_test, y_pred, target_names=['Baisse', 'Hausse']))
Accuracy sur le set de test: 43.84%

Rapport de classification:
              precision    recall  f1-score   support

      Baisse       0.31      0.20      0.24        66
      Hausse       0.49      0.64      0.55        80

    accuracy                           0.44       146
   macro avg       0.40      0.42      0.40       146
weighted avg       0.41      0.44      0.41       146
Realite du trading : Une accuracy de 52-55% est typique pour la prediction de direction. Ce qui compte en trading, c’est le ratio gain/perte combine a l’accuracy. Un modèle avec 52% d’accuracy mais des gains 2x superieurs aux pertes peut etre très rentable.
Feature Importance
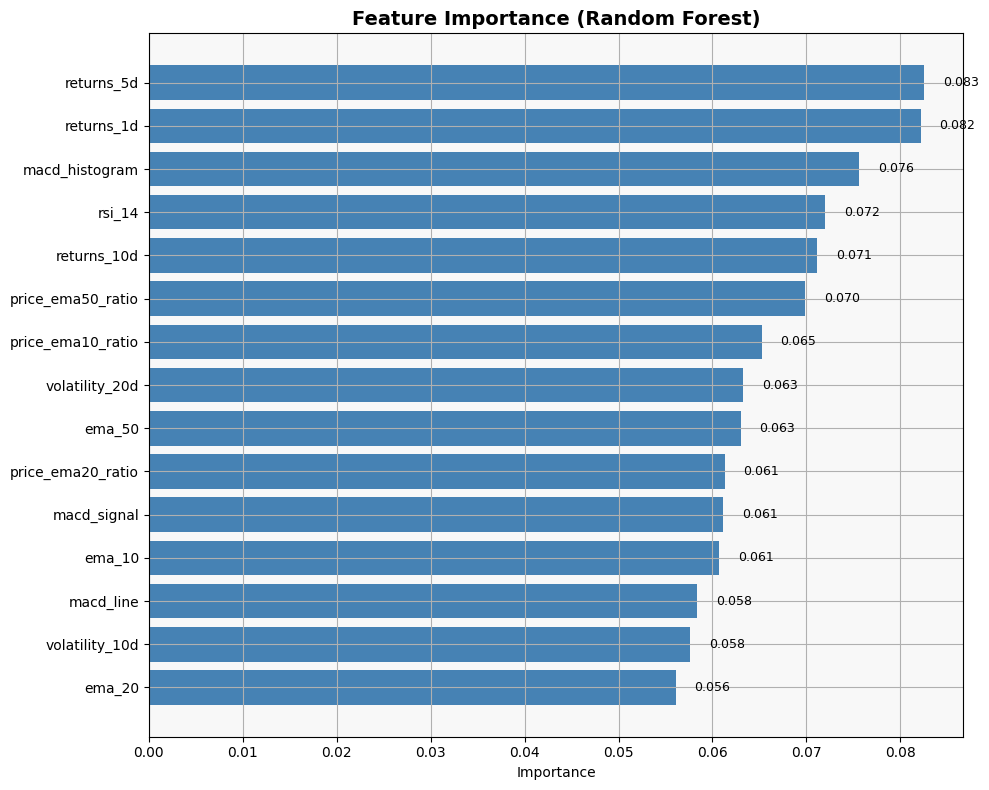
Le Random Forest nous donne l’importance de chaque feature pour la prediction.
# Feature importanceimportance_df = pd.DataFrame({'feature': feature_cols,'importance': model.feature_importances_}).sort_values('importance', ascending=False)# Visualisationfig, ax = plt.subplots(figsize=(10, 8))bars = ax.barh(importance_df['feature'], importance_df['importance'], color='steelblue')ax.set_xlabel('Importance')ax.set_title('Feature Importance (Random Forest)', fontsize=14, fontweight='bold')ax.invert_yaxis()# Ajouter les valeurs sur les barresfor bar, val inzip(bars, importance_df['importance']): ax.text(val +0.002, bar.get_y() + bar.get_height()/2, f'{val:.3f}', va='center', fontsize=9)plt.tight_layout()plt.show()print("\nTop 5 features les plus importantes:")print(importance_df.head().to_string(index=False))
Top 5 features les plus importantes:
       feature  importance
    returns_5d    0.082554
    returns_1d    0.082155
macd_histogram    0.075621
        rsi_14    0.072003
   returns_10d    0.071125
Interpretation : Feature Importance
Les features les plus importantes revelent ce que le modèle a appris :
Returns passes : Le modèle detecte potentiellement des patterns de mean-reversion ou momentum
RSI : Les niveaux de survente/surachat sont informatifs
Ratios prix/EMA : La position relative par rapport aux moyennes indique la tendance
Note : L’importance des features ne signifie pas causalite. Le modèle peut capturer des correlations spurious.
6. ObjectStore Pattern (5 min)
Persistance du Modèle
Le ObjectStore de QuantConnect permet de sauvegarder des objets (modèles, paramètres, données) pour les reutiliser dans un algorithme de production.
C’est le pattern standard pour deployer du ML en production sur QuantConnect.
import joblibimport io# Serialiser le modele en bytes (joblib.dump vers un buffer memoire)buffer= io.BytesIO()joblib.dump(model, buffer)model_bytes =buffer.getvalue()# Sauvegarder dans ObjectStoreqb.object_store.save_bytes('classification_model', model_bytes)print("Modele sauvegarde dans ObjectStore!")print(f"\nTaille du modele: {len(model_bytes) /1024:.2f} KB")
Modele sauvegarde dans ObjectStore!

Taille du modele: 701.87 KB
Sauvegarder les Noms des Features
Il est important de sauvegarder également les noms des features pour garantir la coherence lors du chargement.
import json# Sauvegarder la liste des featuresfeature_config = {'feature_cols': feature_cols,'model_type': 'RandomForestClassifier','train_date': str(X_train.index.max().date()),'accuracy_test': accuracy}qb.object_store.save('classification_config', json.dumps(feature_config))print("Configuration sauvegardee:")print(json.dumps(feature_config, indent=2))
Voici le code a utiliser dans votre main.py (algorithme de production) pour charger le modèle :
# CODE A COPIER DANS main.pyfrom AlgorithmImports import*import joblibimport jsonclass MLClassificationStrategy(QCAlgorithm):""" Strategie ML utilisant un modele de classification pre-entraine. Le modele est entraine dans research_classification.ipynb et sauvegarde via ObjectStore. """def Initialize(self):self.SetStartDate(2023, 1, 1)self.SetCash(100000)# Ajouter le symboleself.symbol =self.AddEquity("SPY", Resolution.Daily).Symbol# Charger le modele depuis ObjectStore model_bytes =self.object_store.read_bytes('classification_model')self.model = joblib.loads(model_bytes)# Charger la configuration config_json =self.object_store.read('classification_config')self.config = json.loads(config_json)self.feature_cols =self.config['feature_cols']self.Debug(f"Modele charge: {self.config['model_type']}")self.Debug(f"Accuracy test: {self.config['accuracy_test']:.2%}")# Indicateurs pour generer les featuresself.rsi =self.RSI(self.symbol, 14)self.ema10 =self.EMA(self.symbol, 10)self.ema20 =self.EMA(self.symbol, 20)self.ema50 =self.EMA(self.symbol, 50)self.macd =self.MACD(self.symbol, 12, 26, 9)# Warm-upself.SetWarmup(50)def OnData(self, data):ifself.IsWarmingUp:return# Construire le vecteur de features features =self.BuildFeatures()if features isnotNone:# Prediction prediction =self.model.predict([features])[0]# Trading logicif prediction ==1andnotself.Portfolio.Invested:self.SetHoldings(self.symbol, 1.0)self.Debug(f"{self.Time}: Signal HAUSSE - Long")elif prediction ==0andself.Portfolio.Invested:self.Liquidate(self.symbol)self.Debug(f"{self.Time}: Signal BAISSE - Liquidate")def BuildFeatures(self):"""Construire le vecteur de features a partir des indicateurs."""# Cette methode doit correspondre exactement aux features du notebook# TODO: Implementer la logique de construction des features# en utilisant self.History() pour les returns et volatilitereturnNone# Placeholderprint("\nCode pret a etre copie dans main.py")
Code pret a etre copie dans main.py
Workflow ObjectStore Resume
RESEARCH (ce notebook)           PRODUCTION (main.py)
======================           ====================
1. Explorer données              4. Charger modèle
2. Entrainer modèle     ------>  5. Construire features
3. Sauvegarder ObjectStore       6. Generer signaux
                                 7. Executer trades
Important : Les features calculees dans l’algorithme doivent etre identiques a celles du notebook. Toute différence entrainera des predictions incorrectes.
Conclusion et Prochaines Étapes
Recapitulatif
Dans ce notebook, nous avons :
Utilise QuantBook pour charger des données financieres via l’API synchrone
Créé 15 features techniques (RSI, EMA, MACD, returns, volatilite)
Défini une variable cible binaire pour la prediction de direction
Entraine un RandomForestClassifier avec split temporel
Evalue les performances avec metriques de classification
Sauvegarde le modèle via ObjectStore pour la production
Points Cles a Retenir
Concept
Description
QuantBook
API synchrone pour la recherche, retourne DataFrame pandas
Split temporel
Toujours respecter la chronologie, jamais de shuffle
Variable cible
Utiliser .shift(-1) pour predire le futur
ObjectStore
Mécanisme de persistance pour partager modèle Research -> Algorithm
Accuracy ~52-55%
Typique pour la prediction de direction, le ratio gain/perte compte aussi
Prochaines Étapes
QC-Py-19-ML-Supervised-Classification : Approfondir la théorie et les metriques
QC-Py-20-ML-Regression-Prediction : Predire des valeurs continues (returns)
projects/ML-Classification : Voir un exemple complet deployable
Exercices Suggeres
Essayer d’autres modèles : XGBoost, LightGBM, SVM
Ajouter des features : sentiment, volume, volatility skew
Implementer une validation croisee temporelle (TimeSeriesSplit)
Comment Charger le Modèle dans un Algorithme
Voici le code a utiliser dans votre
main.py(algorithme de production) pour charger le modèle :