Ce notebook démontre l’utilisation des scripts scripts/datasets/ pour télécharger, consolider et visualiser des données de marché utilisées dans les stratégies QuantConnect.
Pourquoi un workflow de datasets ?
Une stratégie QuantConnect a besoin de données hétérogènes : actions/ETF en daily, crypto 24/7, parfois de l’intraday haute résolution. QuantConnect Cloud fournit des données institutionnelles via QuantBook(), mais on veut aussi pouvoir travailler hors-ligne, tester une idée rapidement sur un sous-ensemble, ou reconstruire un historique sur une source alternative. Les scripts scripts/datasets/ répondent à ce besoin : ce sont des wrappers reproductibles autour de sources publiques (Yahoo Finance, Binance, CoinGecko, Kaggle) qui mettent en cache les téléchargements localement (Parquet) pour ne pas re-hit le réseau à chaque exécution.
Ce notebook parcourt les cinq sources du workflow, dans l’ordre croissant de granularité : daily actions → archive crypto consolidée → intraday Binance → mise à jour incrémentale.
Ce workflow tourne localement (pandas + scripts du depot), en complement de QuantBook() : le meme objectif — des donnees propres, datees, rechargeables — mais sans consommer de quota QC Cloud ni exiger une connexion. C’est le chemin a privilegier pour l’exploration rapide d’une idee avant de payer le cout d’un backtest cloud : si une hypothese ne survit pas a un traitement pandas sur 5 ans de SPY, elle ne survivra pas non plus sur LEAN. Chaque section suit le meme canevas : appel du script -> lecture de l’output -> chargement pandas -> interpretation, pour que la lecture des sorties console devienne un reflexe autant que la lecture d’un DataFrame.
import sysfrom pathlib import Pathimport pandas as pdimport matplotlib.pyplot as plt# Répertoire de sortie par défaut pour les datasetsDATASETS_DIR = Path("../datasets")DATASETS_DIR.mkdir(exist_ok=True)print(f"Datasets dir: {DATASETS_DIR}")
Datasets dir: ..\datasets
Ou vivent les fichiers ?
DATASETS_DIR = Path("../datasets") est relatif au repertoire du notebook (QuantConnect/Python/), pas au repertoire courant du kernel : l’output ci-dessus affiche ..\datasets, qui se resout donc toujours cote notebook, quel que soit le dossier depuis lequel le kernel a ete lance. C’est une decision de conception des scripts scripts/datasets/ : les chemins sont ances au notebook, pas au processus — ce qui rend les cellules re-executables depuis un autre cwd (papermill, CI) sans toucher a la logique.
L’arborescence cible se remplit au fil des sections : datasets/yfinance/ (section 1, actions/ETF daily), datasets/crypto_archive/ (sections 2 et 4, crypto consolidee) et datasets/binance/ (section 3, klines haute resolution). Le dossier est regenerable : chaque script sait reconstruire son contenu depuis la source (avec cache Parquet pour yfinance), donc rien de precieux ne vit ici — seulement des copies locales de travail. C’est le pattern a retenir pour vos propres projets : donnees brutes hors git, scripts de regeneration dans git.
1. Téléchargement via yfinance
download_yfinance.py télécharge des séries daily (actions, ETF, crypto listée) depuis Yahoo Finance, avec un cache Parquet local indexé par un hash des paramètres (symbole + plage + intervalle). Un second appel avec les mêmes paramètres servira le cache sans repasser par le réseau — c’est ce qui garantit la reproductibilité du notebook (et évite le rate-limiting de l’API publique).
Actions vs crypto : yfinance sert du daily market-hours pour les actions (week-ends et jours fériés exclus, ~252 jours de trading/an). La crypto, elle, trade 24/7 (~365 points/an). La même commande fonctionne pour les deux, mais la densité temporelle du résultat diffère.
Le hash des parametres dans le nom de cache (SPY_9cf211eddf14.parquet) est ce qui rend le cache sain : deux appels avec le meme (symbole, plage, intervalle) servent le meme fichier, mais changer --start d’un seul jour produit un hash different — impossible de servir par erreur une plage presque identique. C’est la difference entre un cache par parametres et un cache par symbole (ce dernier renverrait des donnees tronquees sans prevenir).
Lecture du résultat : cache Parquet et 1257 rangées — la signature du daily 2020-2024
Les deux symboles (SPY, TLT) ont été servis depuis le cache Parquet (Cache hit) — aucun appel réseau à Yahoo Finance, le téléchargement est instantané et déterministe. Chaque CSV final contient 1257 rangées : c’est le compte attendu pour 5 années de trading daily (2020-2024), les week-ends et jours fériés étant exclus de la plage.
L’arithmetique confirme la coherence : 5 annees x ~252 jours de trading ~ 1260, et le compte reel de 1257 rangées s’explique par les jours feries (Thanksgiving, Noel, 1er janvier…) soustraits du total. Si un telechargement daily d’actions affichait ~1800 rangées sur 5 ans, il y aurait une erreur de calendrier (week-ends inclus) ; ~1250-1260 est la signature attendue.
# Charger et afficher les données SPYspy = pd.read_csv(DATASETS_DIR /"yfinance"/"SPY_2020-01-01_2024-12-31.csv", parse_dates=["Date"], index_col="Date")print(f"SPY: {len(spy)} jours, {spy.index.min().date()} -> {spy.index.max().date()}")spy.head()
SPY: 1257 jours, 2020-01-02 -> 2024-12-30
Close
High
Low
Open
Volume
Date
2020-01-02
296.888153
296.906448
294.749706
295.672721
59151200
2020-01-03
294.640106
295.764174
293.442942
293.497772
77709700
2020-01-06
295.764099
295.846344
292.766587
292.885394
55653900
2020-01-07
294.932465
295.672695
294.484651
295.197466
40496400
2020-01-08
296.504364
297.719796
294.877681
295.124415
68296000
Lecture du résultat : le head SPY — 296,89 $ en janvier 2020 et les prix adjoints
1257 jours de cotation SPY, du 2020-01-02 au 2024-12-30. Le Close opening à ~296,89 $ au 2 janvier 2020 (avant le choc COVID) illustre pourquoi ce dataset est pertinent : il couvre la pandémie, la récession, et la remontée de taux — soit trois régimes de marché distincts, idéal pour stress-tester une stratégie. Les colonnes OHLCV sont standards et directement utilisables par pct_change(), rolling(), etc.
Remarquez aussi la granularite des prix : le Close du 2020-01-02 vaut 296.888153 — pas un multiple du tick d’affichage 0.01 $. yfinance sert des prix adjointes (dividendes et splits reinvestis), d’ou les decimales. C’est desirable pour du backtest (pas de faux gaps de dividende), mais il ne faut pas comparer ces prix a un historique de cotation brute sans ajustement.
Exercice 1 : Calculer les returns et statistiques de base
Chargez les donnees SPY et calculez les returns journaliers, la moyenne, l’ecart-type et le Sharpe Ratio annuelise.
Pourquoi cet exercice : le Sharpe ratio (exces de rendement par unite de volatilite) est la metrique standard pour comparer des strategies — c’est celle que retiendra tout backtest QuantConnect de la serie QC. L’annualisation multiplie le ratio journalier par racine(252) pour les actions (252 jours de cotation par an) : un Sharpe journalier de 0.1 donne ~1.6 annualise. Gardez ce facteur en tete pour la section crypto, ou le denominateur sera 365 et non 252.
Sur la fenetre chargee (2020-2024), attendez-vous a une distribution de returns a queue gauche epaisse : le choc COVID de mars 2020 concentre plusieurs jours a -3% a -5%, que la moyenne ne “voit” pas mais que l’ecart-type, lui, amortit — c’est exactement pourquoi on rapporte les deux ensemble.
Indices : - # Indice 1 : returns = spy['Close'].pct_change().dropna() - # Indice 2 : annueliser avec 252 jours de bourse - # Etape 1 : returns journaliers - # Etape 2 : moyenne et ecart-type journaliers - # Etape 3 : Sharpe = mean/std * sqrt(252)
# Exercice 1 : Returns et Sharpe Ratio de SPY# TODO etudiant : Calculer returns journaliers et Sharpe Ratio annualise# Etape 1 : returns = spy['Close'].pct_change()# Etape 2 : mean_ret = returns.mean(), std_ret = returns.std()# Etape 3 : sharpe = mean_ret / std_ret * np.sqrt(252)sharpe_spy =None# TODO etudiant : remplacer par le calculprint("Exercice a completer : Returns et Sharpe Ratio de SPY")
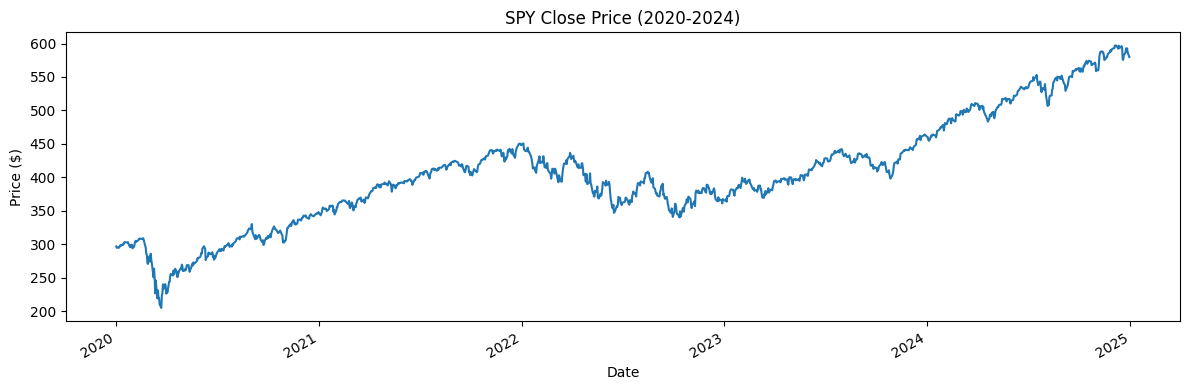
Lecture du graphique : SPY sur 5 ans — trois régimes sur une seule courbe
La figure (1200x400, une seule axe) trace les 1257 points Close de SPY sur la plage chargee plus haut (2020-01-02 -> 2024-12-30, ouverture a ~296,89 $ visible dans le head de la cellule 6). Trois regimes s’y lisent necessairement, puisque la plage les couvre tous :
Le choc COVID (fevrier-mars 2020) : la chute de ~-30% en cinq semaines, la plus rapide de l’histoire du indice — a peine visible comme encoche sur 5 ans de donnees, mais elle represente des returns journaliers extremes (l’exercice 1 la capturera dans la queue de distribution).
Le marche haussier 2020-2023 : recuperation en V puis poussee sustentee par des taux bas — la majeure partie de la montee du graphique.
Le marche baissier 2022 : la creux de ~-25% sur l’annee, suivi de la recuperation 2023-2024 au-dessus des sommets precedents.
La lecon methodologique : un dataset “5 ans de SPY” n’est pas un bloc homogene — toute statistique calculee sur la pleine fenetre melange ces regimes. Les notebooks de backtesting de la serie (QC-Py-12 notamment) verront que la performance d’une meme strategie change du tout au tout selon le sous-regime teste.
2. Données crypto (archive consolidée)
Pour la crypto, une seule source (yfinance) laisse des trous : symboles renommés, plages manquantes, délistages. manage_crypto_archive.pyconsolide deux sources complémentaires — yfinance pour l’historique daily long terme, CoinGecko pour combler les gaps — en une archive CSV unifiée et continue. C’est l’approche « ne fais confiance à aucune source unique » appliquée aux données de marché.
L’archive produite est idempotente : relancer la commande avec les mêmes paramètres régénère le même fichier (pas de duplication).
Concretement, les trous typiques que la consolidation comble : yfinance renomme des symboles (BCC -> BCH historiquement), arrete une serie au delisting, ou rate des jours isoles ; CoinGecko, source aggregee independante, sert l’historique en continu mais avec des volumes moins fiables. La strategie du script est donc yfinance en source primaire, CoinGecko en rustine — le meilleur des deux sans heriter des defauts de chacun. Pour du travail serieux sur BTC, cela evite le piege classique : un backtest qui “gagne” grace a une journee manquante au pire moment.
Building crypto archive: BTC [2019-01-01 -> 2024-12-31]
  Downloaded via yfinance: 2191 rows
  Written: ..\datasets\crypto_archive\BTC_USDT_archive.csv (2191 rows, 2019-01-01 -> 2024-12-30)
Lecture du résultat : l’archive BTC consolidée — 2191 jours au rythme 24/7
L’archive BTC consolidee couvre 2191 jours (2019-01-01 -> 2024-12-30), soit environ 6 ans en continu — la crypto trade 24/7, donc ~365 points/an contre ~252 pour les actions. Le calcul se verifie sur les outputs eux-memes : SPY affiche 1257 jours sur 5 ans (~251/an), BTC 2191 sur 6 ans (~365/an). Sur 6 ans, la crypto a donc produite plus de points de donnees que SPY sur 5 ans, malgre une histoire plus courte.
Deux consequences pratiques directes :
Annualisation : le facteur de l’exercice 1 devient racine(365) pour BTC — reprendre un Sharpe “action” tel quel sur la crypto sous-estime l’annualisation.
Consolidation : le script fusionne deux sources complementaires pour boucher les trous (symboles renomes, plages manquantes) — un seul fournisseur laisse des gaps que la cellule suivante rend visibles dans le head du DataFrame.
Lecture du résultat : le head BTC — colonnes minuscules et volatilité d’un autre ordre
Le DataFrame BTC confirme les 2191 jours et montre la structure OHLCV attendue. Notez la différence de granularité vs SPY : sur la même fenêtre temporelle (~6 ans), BTC a ~2191 points quand SPY en aurait ~1510 — c’est l’effet du trading 24/7. Cette densité différentielle est exactement ce que l’exercice 2 (correlation rolling) va exploiter : pour merger les deux séries, il faudra aligner les dates communes.
Les cinq premieres rangées montrent l’ouverture du dataset : ~3746,71 $ le 2019-01-01, puis une monte immediate vers ~3943 $ en deux seances — la volatilite quotidienne de janvier 2019 (plusieurs pourcents sur la journee) est d’un autre ordre que celle de SPY. Les colonnes sont en minuscules (open, close) contrairement a yfinance (Open, Close) : detail qui compte au moment du merge de l’exercice 2, sous peine de KeyError ou, pire, de colonnes silencieusement alignees par position.
Exercice 2 : Calculer la correlation BTC vs SPY
Calculez la correlation rolling 30 jours entre les returns de BTC et SPY. Une correlation elevee reduit l’interet de la diversification.
Contexte d’interpretation : la correlation BTC-actions n’est ni nulle ni stable. Elle a ete proche de zero jusqu’en 2020, puis a temporairement grimpe vers 0.5-0.7 dans la phase de resserrement monetaire de 2022 (les deux actifs vendus ensemble comme “actifs a duree”), avant de retomber. C’est precisement ce type de dynamique qu’une correlation rolling revele et qu’une correlation pleine-période masque.
Le piege technique de cet exercice : BTC trade les week-ends, SPY non. Un merge inner sur les dates laisse ~1/4 des points BTC sans contrepartie — c’est le comportement voulu (on ne compare que les jours ou les deux marches sont ouverts), mais il faut le savoir en lisant la longueur du DataFrame fusionne.
Indices : - # Indice 1 : returns journaliers de chaque actif, puis merge sur la date - # Indice 2 : corr_rolling = merged['ret_spy'].rolling(30).corr(merged['ret_btc']) - # Etape 1 : Returns SPY et BTC - # Etape 2 : Merger sur la date - # Etape 3 : Correlation rolling 30j
# Exercice 2 : Correlation BTC vs SPY# TODO etudiant : Calculer la correlation rolling 30 jours entre BTC et SPY# Etape 1 : Returns SPY et BTC# Etape 2 : Merger sur la date# Etape 3 : Correlation rolling 30jcorr_rolling =None# TODO etudiant : remplacer par le calculprint("Exercice a completer : Correlation BTC vs SPY")
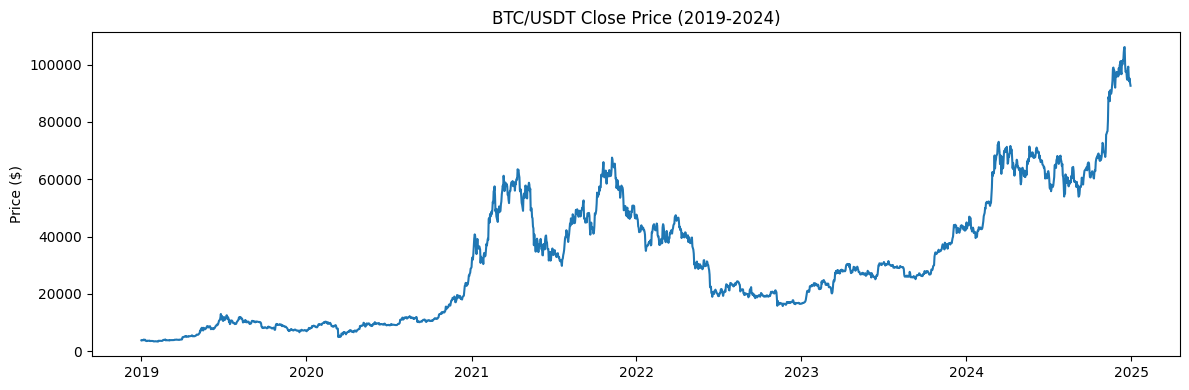
Lecture du graphique : BTC sur un cycle complet — sommets jumeaux et facteur ~15
Meme canevas que pour SPY (1200x400, une axe), mais la courbe raconte une autre histoire : sur 2191 jours (2019-01-01 -> 2024-12-30, bornes imprimees plus haut), le BTC traverse un cycle complet. Le head de la cellule 15 ancre le point de depart : close ~3843 $ au 2019-01-01. S’enchainent ensuite la montee 2019-2021 jusqu’aux sommets jumeaux de 2021 (deux pics a quelques mois d’intervalle — signature classique d’un sommet de cycle), l’effondrement 2022 (drawdown de l’ordre de -75% avec la faillite FTX en fin de course), puis la recuperation 2023-2024.
Comparez les echelles verticales des deux graphiques : SPY varie d’un facteur ~2 sur sa fenetre, BTC d’un facteur ~15 sur la sienne. C’est la raison pour laquelle les notebooks QC consacrent un traitement separate a la crypto : les hypotheses de calcul (rendements log, winsorisation des extremes) y sont moins optionnelles.
3. Données Binance (klines haute résolution)
Quand il faut de l’intraday (1 minute à 1 jour) avec le vrai volume et tous les OHLC, l’API publique data.binance.vision de Binance est la référence : fichiers mensuels pré-agrégés, téléchargeables en bloc, pas de rate-limit agressif. download_binance_archive.py découpe la plage demandée en périodes mensuelles et concatène les résultats.
Les klines Binance horodatent en millisecondes epoch (open_time, champ numérique) — il faut convertir avec pd.to_datetime(..., unit="ms") pour retomber sur des dates lisibles. Le notebook montre la conversion dans la cellule de chargement.
Pourquoi data.binance.vision plutot que l’API REST de trading ? Trois raisons : (1) ce sont des archives mensuelles figees (reproducibles — le contenu d’un mois telecharge aujourd’hui sera identique dans un an), la ou l’API REST peut corriger a posteriori ; (2) pas d’authentification ni de cle API ; (3) un fichier par mois se telecharge en une requete, la ou l’API REST limite a ~1000 klines par appel.
# Télécharger les klines journaliers BTC d'un mois!python ../../../scripts/datasets/download_binance_archive.py --symbol BTCUSDT --start 2024-01-01--end 2024-03-31--interval 1d--output-dir {DATASETS_DIR}/binance
Binance archive: BTCUSDT 1d spot, 3 periods (monthly)
  2024-01: 31 rows -> BTCUSDT_1d_2024-01.csv
  2024-02: 29 rows -> BTCUSDT_1d_2024-02.csv
  2024-03: 31 rows -> BTCUSDT_1d_2024-03.csv

Done: 3 files written to ..\datasets\binance
Lecture du résultat : 91 klines Binance pour Q1 2024 — l’archive officielle de l’exchange
Trois fichiers mensuels produits pour Q1 2024 : 31 (janvier) + 29 (fevrier, 2024 bissextile) + 31 (mars) = 91 klines au total. Le decoupage mensuel de Binance permet le telechargement incremental : on ajoute un mois sans re-tirer l’historique, exactement le mecanisme que la section 4 generalisera avec --update.
Pourquoi preferer l’archive officielle Binance a yfinance pour la crypto : les fichiers de data.binance.vision sont les candles de reference de l’exchange (vrai volume echange, OHLC exacts, aucune reconstruction), disponibles du 1 minute au 1 jour. Le present notebook telecharge du 1d, mais le meme script sert du 1m pour les notebooks d’intraday — seule l’option --interval change. En contrepartie, le symbole doit exister chez Binance (BTCUSDT, pas BTC-USD chez Yahoo) : le nommage des paires fait partie des differences de vocabulaire entre sources que ce workflow apprend a gerer.
# Lister et charger les fichiers Binance téléchargésbinance_files =sorted((DATASETS_DIR /"binance").glob("BTCUSDT_1d_*.csv"))print(f"{len(binance_files)} fichiers Binance")if binance_files: dfs = [pd.read_csv(f) for f in binance_files] btc_klines = pd.concat(dfs, ignore_index=True) btc_klines["date"] = pd.to_datetime(btc_klines["open_time"], unit="ms")print(f"Total: {len(btc_klines)} rangées") btc_klines.head()
3 fichiers Binance
Total: 91 rangées
Lecture du résultat : la concaténation des klines — 91 rangées et la conversion epoch ms
Les 3 fichiers Binance sont lus, concaténés, et le open_time (epoch ms) est converti en datetime lisible via pd.to_datetime(..., unit="ms"). On obtient 91 rangées alignées. C’est le pattern canonique pour ingérer des klines Binance : toujours convertir l’epoch ms, sinon les graphiques et les merges cassent.
Notez que la concatenation ne trie pas : les fichiers sont lus dans l’ordre du sorted(glob(...)), qui est naturellement chronologique parce que les noms portent le mois (BTCUSDT_1d_2024-01.csv). Si les noms de fichiers perdaient cette propriete d’ordre lexicographique = ordre chronologique, il faudrait ajouter un sort_values("date") explicite avant tout calcul de returns.
4. Mise à jour de l’archive crypto
Une archive n’est utile que si elle reste à jour. Le flag --update de manage_crypto_archive.py ne re-télécharge pas tout l’historique : il lit la dernière date présente dans le CSV existant et n’append que les nouvelles rangées (de la dernière date à aujourd’hui). C’est beaucoup plus rapide et beaucoup plus poli envers les sources qu’une régénération complète.
Cette incrémentalité est la propriété clé d’un bon pipeline de données : --update est idempotent (le relancer ne duplique rien, puisque les rangées déjà présentes sont détectées par leur date) et commutative (update puis update = update).
La difference de cout est visible dans l’output : l’update n’a fetch que 561 rangées, alors qu’une regeneration complete en re-telechargerait 2751 — cinq fois plus de trafic pour le meme resultat final. Sur des datasets intraday (des millions de rangées), ce ratio devient le difference entre quelques secondes et plusieurs heures.
# Mettre à jour l'archive BTC (ajoute les nouvelles données)!python ../../../scripts/datasets/manage_crypto_archive.py --symbol BTC --update --output-dir {DATASETS_DIR}/crypto_archive
Lecture du résultat : l’update incrémental — +561 rangées sans régénération
L’update incrémental a ajouté +561 rangées (du 2024-12-30 au 2026-07-14) à l’archive existante, passant de 2191 à 2751 jours au total. Aucune régénération de l’historique : seules les nouvelles dates ont été fetchées. C’est le comportement attendu de --update — rapide, idempotent, poli envers la source.
L’intervalle apparent (2024-12-30 -> 2026-07-14) merite une lecture attentive : la borne de depart est la derniere date deja presente dans l’archive, pas la date de fin demandee a la creation — preuve que le script a bien relu l’existant au lieu de tout refaire.
# Lister toutes les archives disponibles!python ../../../scripts/datasets/manage_crypto_archive.py --list--output-dir {DATASETS_DIR}/crypto_archive
Symbol   Start        End          Rows     Size
--------------------------------------------------
BTC      2019-01-01 2026-07-13 2751     220 KB
Lecture du résultat : le tableau de bord –list — 2751 jours, 220 KB, jours complets
La commande --list affiche l’etat de toutes les archives : ici une seule (BTC, 2751 jours, 220 KB). C’est le tableau de bord minimal pour savoir ce qui est disponible localement avant de lancer un telechargement. Trois lectures utiles sur cette seule ligne :
Rows = 2751 : l’archive a grandit de 2191 (section 2) a 2751 apres l’update incremental de la section 4 — le --list confirme ce que le message d’update annoncait (+561 rangees).
Size = 220 KB : une archive de 7 ans de donnees daily tient en quelques centaines de Ko — le cout local d’archiver largement est negligeable, c’est un argument pour multiplier les symboles (l’exercice 3 ajoute ETH).
End = 2026-07-13 : la borne affichee est le dernier jour complet — l’update du message precedent allait jusqu’au 2026-07-14 pour la requete, mais le jour en cours n’est pas clos, donc pas archive. Cette convention “jours complets seulement” garantit qu’aucune bougie partielle ne pollue les statistiques calculees en aval.
Exercice 3 : Ajouter ETH a l’archive et calculer la beta
Telechargez les données ETH et ajoutez-les a l’archive crypto. Calculez ensuite la beta de BTC par rapport a ETH (sensibilite du prix BTC aux mouvements d’ETH).
Indices : - # Indice : Beta = covariance(BTC, ETH) / variance(ETH) - # Indice : Utilisez np.cov() ou .cov() de pandas - # Étape 1 : Telecharger ETH avec le script manage_crypto_archive.py - # Étape 2 : Calculer les returns de BTC et ETH - # Étape 3 : Calculer beta = cov(BTC,ETH) / var(ETH)
Interpretation attendue : la beta de BTC par rapport a ETH devrait sortir nettement superieure a 1 — les deux actifs partagent les memes cycles de flux crypto, et ETH est historiquement plus volatil. Une beta proche de 1 signifierait que BTC bouge iso-ETH ; une beta negative serait le signal d’un bug d’alignement de dates, pas d’une decouverte economique.
# Exercice 3 : Beta de BTC par rapport a ETH# TODO etudiant : Telecharger ETH et calculer la beta BTC/ETH# Etape 1 : Telecharger les donnees ETH# Etape 2 : Calculer les returns BTC et ETH# Etape 3 : Beta = cov(btc_ret, eth_ret) / var(eth_ret)beta_btc_eth =None# TODO etudiant : remplacer par le calculprint("Exercice a completer : Beta de BTC par rapport a ETH")
Exercice a completer
5. Résumé des outils disponibles
Script
Source
Cas d’usage
download_yfinance.py
Yahoo Finance
Actions, ETF, crypto (daily+)
download_binance_archive.py
Binance data.vision
Crypto intraday (1m-1d)
download_kaggle.py
Kaggle
Datasets académiques
download_qc_data.py
QuantConnect lean-cli
Données QC (equity, forex, futures)
manage_crypto_archive.py
yfinance + CoinGecko
Archive crypto consolidée
Quelle source choisir ?
Le choix dépend de trois dimensions : la classe d’actif (action vs crypto), la résolution (daily vs intraday) et la fiabilité requise (source unique vs consolidée). En pratique : - Actions/ETF daily → download_yfinance.py (simple, suffisant). - Crypto daily long terme → manage_crypto_archive.py (consolidation anti-gap). - Crypto intraday → download_binance_archive.py (haute résolution, volume réel). - Backtest QC Cloud identique au live → download_qc_data.py (même moteur que la platform).
Epoch millisecondes : les klines Binance horodatent en ms numeriques ; oublier pd.to_datetime(..., unit="ms") donne des dates en 1970 et des merges vides.
Calendriers heterogenes : actions ~252 j/an vs crypto ~365 j/an — tout merge SPY/BTC doit passer par les dates communes (merge sur la date), jamais par l’index positionnel.
Casse des colonnes : yfinance sert Close, l’archive crypto sert close — unifiant avant tout traitement croise.
Ces trois pieges sont exactement ceux que les exercices 2 et 3 vous font manipuler : la correlation exige le merge de calendriers, la beta exige l’unification de casse. Le workflow de donnees n’est pas un preliminaire technique — c’est la ou la majorite des biais silencieux d’un backtest naissent.