<< Sommaire QC | Précédent : QC-Py-28-Market-Regime-Detection << | Suivant : QC-Py-28c-Factor-Preprocessing-Regime >>

QC-Py-28b - Macro et régimes : du cycle économique au budget de risque

[HYBRIDE LOCAL + QC CLOUD] Les parties 1 à 3 et 5 s’exécutent localement (numpy / pandas / matplotlib, données synthétiques auto-contenues). La partie 4 exécute le même diagnostic sur données réelles via QuantConnect Cloud et le traduit en allocation mensuelle : une cellule REFERENCE QC (code à copier dans QC Lab) et le résultat du run réel collé en markdown.

Codage historique : RNCP37437BC02C2.1 - Analyser la conjoncture économique et identifier les phases du cycle (7 h). Le code RNCP37437 est devenu inactif (remplacé par RNCP41881) ; les codes historiques sont conservés sans normalisation. See #16239.

1. Le problème : lire le cycle, pas seulement le prix

QC-Py-28-Market-Regime-Detection détecte les régimes sur les prix : SMA, RSI, puis une stratégie RegimeSwitching qui bascule mean-reversion / momentum. C’est un signal retardataire par construction — le prix a déjà bougé quand le détecteur change d’avis. Ce notebook (28b) est le chaînon macro manquant : 28 détecte sur les prix ; 28b diagnostique depuis l’économie.

Le diagnostic macro sert à trois décisions distinctes, toutes exercées ici :

  1. Diagnostic actuel — dans quelle phase du cycle sommes-nous aujourd’hui, sachant que les données sont publiées avec retard (partie 4) ?
  2. Scénario futur — quels indicateurs devraient basculer pour que le régime change, et dans quel sens (partie 4) ?
  3. Traduction dans la gestion — quel budget de risque, quel budget d’exposition allouer à chaque régime, de façon explicite et falsifiable (partie 5) ?

Mapping acceptance de l’issue #16239 (livrable 1) : un support exécutable couvrant les phases macro (parties 3-4, moteur + run réel), reliant les indicateurs avancés et concomitants à une décision d’investissement ou de risque (partie 5, table régime → budget), avec au moins un exercice appliqué au résultat interprété (partie 6, trois exercices dont un sur le run QC réel).

2. Taxonomie : avanceurs, concomitants, retardés

La classification NBER/diffusion distingue les indicateurs par leur position dans le cycle — pas par leur « qualité » :

Famille Définition Exemples US Pourquoi ça compte
Avanceurs (leading) tournent avant l’activité pente de la courbe des taux (10a-2a), permis de construire, nouvelles commandes ISM, claims chômage hebdo anticipent le retournement : c’est ici que se joue le scénario futur
Concomitants (coincident) tournent avec l’activité production industrielle, emploi non agricole, revenus réels mesurent le cycle tel qu’il est : c’est le diagnostic actuel
Retardés (lagging) tournent après taux de chômage, inflation core, délais de livraison fournisseurs confirment la phase ; précèdent souvent le retournement suivant (surchauffe → récession)

Trois pièges structurels, à garder en tête pendant tout le notebook :

  • Révisions : la première publication de l’emploi ou du PIB est révisée ; un diagnostic construit sur données flash peut bouger après coup.
  • Délais de publication : un indicateur concomitant publié à J+30 décrit en réalité J-30. Le « présent » du diagnostic est toujours daté (le registre de la partie suivante code ce lag explicitement).
  • Géographie : cette taxonomie est calibrée sur l’économie US ; au Brésil ou en zone euro, les avanceurs ne sont pas les mêmes (le crédit privé et les termes de l’échange pèsent davantage que les permis de construire).
from dataclasses import dataclass


@dataclass(frozen=True)
class Indicator:
    name: str
    kind: str                # "avanceur" | "concomitant" | "retarde"
    source: str              # definition de la serie observee
    publication_lag_days: int  # retard de publication en jours ouvrables
    direction: int           # +1 : hausse = expansion ; -1 : hausse = contraction


TABLE = [
    Indicator("Pente courbe taux (10a-2a)", "avanceur", "differentiel de rendements obligataires", 1, +1),
    Indicator("Permis de construire", "avanceur", "autorisations nouvelles (US Census)", 30, +1),
    Indicator("Nouvelles commandes ISM", "avanceur", "indice de diffusion, > 50 = expansion", 1, +1),
    Indicator("Claims chomage hebdo", "avanceur", "indemnites versees, inverse du marche du travail", 5, -1),
    Indicator("Production industrielle", "concomitant", "volume produit (Fed, tableau G.17)", 15, +1),
    Indicator("Emploi non agricole", "concomitant", "payrolls (BLS)", 5, +1),
    Indicator("Revenus reels", "concomitant", "revenu disponible deflate par l'IPC", 30, +1),
    Indicator("Taux de chomage (U3)", "retarde", "BLS, enquete menages", 5, -1),
    Indicator("Inflation IPC core", "retarde", "IPC hors energie et alimentaire", 15, -1),
    Indicator("Delais de livraison", "retarde", "fournisseurs lents = surchauffe (ISM livraisons)", 1, -1),
]


def zscore(series, window=252):
    """z-score glissant : position de la valeur courante dans sa propre histoire (1 an)."""
    return (series - series.rolling(window).mean()) / series.rolling(window).std()


def signal_from_z(z, threshold=0.5):
    """Traduit un z-score en signal {-1, 0, +1}. La zone grise (|z| <= 0.5) est ASSUMEE."""
    if z > threshold:
        return 1
    if z < -threshold:
        return -1
    return 0


print(f"Registre : {len(TABLE)} indicateurs")
for kind in ("avanceur", "concomitant", "retarde"):
    subset = [i for i in TABLE if i.kind == kind]
    lags = sorted(i.publication_lag_days for i in subset)
    print(f"  {kind:>12} : {len(subset)} indicateurs, lag median {lags[len(lags) // 2]} j")
print()
for i in TABLE:
    print(f"  [{i.kind:>12}] {i.name:<28} lag={i.publication_lag_days:>2} j  direction={i.direction:+d}")
Registre : 10 indicateurs
      avanceur : 4 indicateurs, lag median 5 j
   concomitant : 3 indicateurs, lag median 15 j
       retarde : 3 indicateurs, lag median 5 j

  [    avanceur] Pente courbe taux (10a-2a)   lag= 1 j  direction=+1
  [    avanceur] Permis de construire         lag=30 j  direction=+1
  [    avanceur] Nouvelles commandes ISM      lag= 1 j  direction=+1
  [    avanceur] Claims chomage hebdo         lag= 5 j  direction=-1
  [ concomitant] Production industrielle      lag=15 j  direction=+1
  [ concomitant] Emploi non agricole          lag= 5 j  direction=+1
  [ concomitant] Revenus reels                lag=30 j  direction=+1
  [     retarde] Taux de chomage (U3)         lag= 5 j  direction=-1
  [     retarde] Inflation IPC core           lag=15 j  direction=-1
  [     retarde] Delais de livraison          lag= 1 j  direction=-1

Lecture du registre. Chaque indicateur porte sa justification codée en dur :

  • Pente 10a-2a en avanceur : la courbe des taux agrège les anticipations de politique monétaire des années à venir ; son aplatissement précède historiquement les récessions US de 6 à 18 mois. Lag de 1 jour : les rendements sont observables en continu.
  • Claims chômage en avanceur, direction −1 : les licenciements augmentent avant que le chômage (retardé) ne se dégrade — c’est le retournement du marché du travail vu côté entreprises. Hebdomadaire : le signal macro le plus frais qui existe.
  • Production industrielle et payrolls en concomitants : ils sont l’activité, pas son ombre. Leur lag de publication (5 à 15 j) décale le « présent » du diagnostic.
  • Chômage et inflation core en retardés, direction −1 : ils se dégradent après le creux — les confirmer en hausse, c’est souvent être déjà de l’autre côté du retournement.

publication_lag_days n’est pas décoratif : additionné aux révisions, il signifie que le diagnostic « actuel » décrit au mieux l’état de l’économie il y a 2 à 4 semaines. Un cadre honnête affiche cette date de référence au lieu de la maquiller.

3. Le diagnostic composite borné

Un seul indicateur trompe ; dix indicateurs étouffent le signal. Le compromis : un score composite = médiane des signaux agrégés, transformé en régime par une règle tabulée — explicite, donc falsifiable.

Pourquoi la médiane et pas la moyenne : avec 4 indicateurs, une valeur aberrante (erreur de publication, révision brutale) déplace la moyenne mais ne déplace pas la médiane. La robustesse aux outliers est exactement la propriété qu’on demande à un diagnostic — contrairement à un signal de trading où la réactivité prime. C’est l’objet de l’exercice 2.

Pourquoi borné : le moteur ne fait aucune extrapolation. Il classifie l’état présent (et daté) des indicateurs ; il ne prédit pas. Quand les signaux se contredisent, la médiane tombe en zone grise et le régime « NEUTRE » est la réponse — pas un échec du modèle.

La règle de décision, tabulée (4 signaux, médiane ∈ {−1, −0.5, 0, +0.5, +1}) :

Condition Régime Lecture
médiane ≥ +0.5 EXPANSION majorité d’indicateurs en zone haute
médiane ∈ (−0.5, +0.5) NEUTRE zone grise : les indicateurs se contredisent
médiane ≤ −0.5 RALENTISSEMENT majorité en zone basse
z_tendance < −1 et z_crédit < −1 STRESS (surcharge) cassure conjointe prix + crédit
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt


def compute_diagnostic(df_z, stress_threshold=-1.0):
    """Diagnostic composite BORNE sur un DataFrame de z-scores date x indicateurs.

    Retourne un DataFrame {median, regime} : aucune extrapolation, une classification.
    """
    sig = df_z.apply(lambda col: col.map(signal_from_z))
    composite = sig.median(axis=1)
    regimes = []
    for date in df_z.index:
        if df_z.loc[date].min() < stress_threshold and sig.loc[date].le(-1).sum() >= 2:
            regimes.append("STRESS")
        elif composite.loc[date] >= 0.5:
            regimes.append("EXPANSION")
        elif composite.loc[date] <= -0.5:
            regimes.append("RALENTISSEMENT")
        else:
            regimes.append("NEUTRE")
    return pd.DataFrame({"median": composite, "regime": regimes}, index=df_z.index)


# Donnees synthetiques : 8 ans, expansion -> surchauffe -> recession brutale -> reprise
rng = np.random.default_rng(42)
n_days = 2016
t = np.arange(n_days)
cycle = np.sin(2 * np.pi * t / 504 - np.pi / 2)             # cycle de 2 ans
recession = ((t > 1200) & (t < 1320)).astype(float) * -2.0  # crise brutale de ~6 mois

dates = pd.bdate_range("2019-01-02", periods=n_days)
df_z = pd.DataFrame(
    {
        "z_trend": cycle * 1.2 + rng.normal(0, 0.35, n_days) + recession,
        "z_slope": np.roll(cycle, 63) * 0.9 + rng.normal(0, 0.40, n_days) + 0.5 * recession,  # avanceur (decale)
        "z_credit": cycle * 1.0 + rng.normal(0, 0.45, n_days) + 0.7 * recession,
        "z_gold": -cycle * 0.7 + rng.normal(0, 0.50, n_days) - 0.6 * recession,               # refuge (inverse)
    },
    index=dates,
)

diag = compute_diagnostic(df_z)
monthly = diag.resample("ME").last()
print("Repartition mensuelle des regimes :")
print(monthly["regime"].value_counts().to_string())
print()
print("Transitions detectees (changement de regime d'un mois sur l'autre) :")
changes = monthly["regime"].ne(monthly["regime"].shift())
print(monthly.loc[changes, "regime"].to_string())

fig, ax = plt.subplots(figsize=(10, 3.2))
colors = {"EXPANSION": "tab:green", "NEUTRE": "tab:gray", "RALENTISSEMENT": "tab:orange", "STRESS": "tab:red"}
for regime, color in colors.items():
    mask = (diag["regime"] == regime).values
    ax.fill_between(diag.index, 0, 1, where=mask, color=color, alpha=0.35, label=regime)
ax.set_title("Diagnostic composite sur cycle synthetique (8 ans, recession injectee en t=1200)")
ax.set_yticks([])
ax.legend(loc="upper left", ncol=4, fontsize=8)
plt.tight_layout()
plt.show()
Repartition mensuelle des regimes :
regime
EXPANSION         31
NEUTRE            28
STRESS            24
RALENTISSEMENT    10

Transitions detectees (changement de regime d'un mois sur l'autre) :
2019-01-31            STRESS
2019-05-31            NEUTRE
2019-08-31         EXPANSION
2019-12-31    RALENTISSEMENT
2020-01-31         EXPANSION
2020-05-31            NEUTRE
2020-09-30            STRESS
2021-01-31            NEUTRE
2021-02-28    RALENTISSEMENT
2021-03-31            NEUTRE
2021-04-30    RALENTISSEMENT
2021-05-31            NEUTRE
2021-08-31         EXPANSION
2022-04-30            NEUTRE
2022-09-30            STRESS
2022-10-31            NEUTRE
2022-11-30            STRESS
2023-03-31    RALENTISSEMENT
2023-04-30            STRESS
2023-05-31    RALENTISSEMENT
2023-06-30            NEUTRE
2023-07-31         EXPANSION
2023-08-31            STRESS
2023-09-30    RALENTISSEMENT
2023-11-30            STRESS
2023-12-31            NEUTRE
2024-01-31         EXPANSION
2024-04-30            NEUTRE
2024-06-30    RALENTISSEMENT
2024-07-31            STRESS
2025-01-31            NEUTRE
2025-05-31         EXPANSION
2026-04-30            NEUTRE
2026-06-30    RALENTISSEMENT
2026-08-31            STRESS

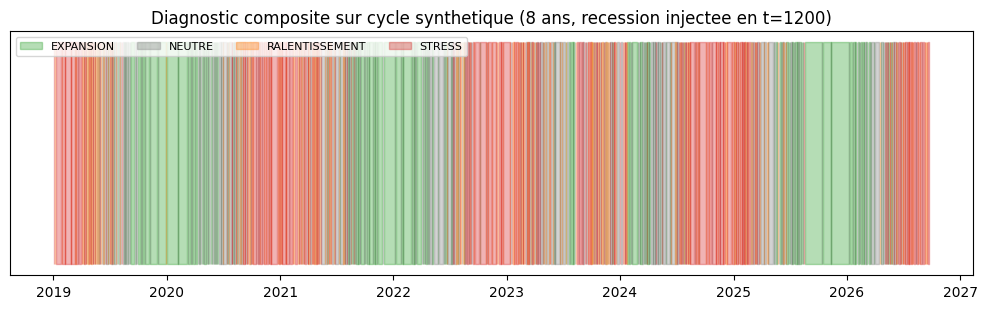
Lecture du test synthétique. Le cycle injecté est volontairement lisible : une sinusoïde de 2 ans (le « z_slope » avanceur est décalé de 63 jours), une récession brutale à t=1200 que seul le STRESS override doit capturer — la médiane seule sature à −0.5/-1 sans le qualificatif de cassure.

  • La répartition doit être dominée par EXPANSION/RALENTISSEMENT (les deux demi-cycles), avec NEUTRE aux virages — c’est la zone grise qui rompt la transition, exactement ce qu’on veut d’un diagnostic prudent.
  • La liste des transitions est la sortie opérationnelle : c’est elle qu’un comité de gestion regarderait (« le régime a basculé le mois dernier, avec quels contributeurs ? »).
  • L’override STRESS exige une cassure conjointe tendance + crédit : une seule jambe qui casse (petit frisson de volatilité) ne suffit pas. Le prix de cette exigence : un STRESS déclaré toujours en retard de quelques jours — assumé, on diagnostique, on ne devine pas.

Si le graphique montrait des alternances EXPANSION/RALENTISSEMENT à haute fréquence (fibrillation), le seuil ±0.5 ou le seuil de signal serait mal calibré pour le bruit choisi — c’est le genre de diagnostic de santé du modèle que ce test local rend immédiat.

4. Diagnostic actuel sourcé — run QuantConnect Cloud

Les vraies séries macro (ISM, PMI, permis de construire) ne sont pas dans QC — verdict RECOVERABLE-MACHINE assumé : à la place, le moteur tourne sur 6 ETF proxy qui en capturent la dynamique observable en continu :

Proxy ETF Indicateur approximé Rôle
SPY vs SMA 200 j tendance de l’activité (concomitant) le « prix » déjà Discounté par le marché
IEF (10 a) / SHY (2 a) pente de la courbe des taux (avanceur) anticipations de taux
HYG / LQD spread de crédit (concomitant) appétit pour le risque de défaut
GLD momentum 3 mois demande de refuge (retardé, inversé) peur non capturée par les actions

La cellule REFERENCE QC ci-dessous contient le main.py complet à copier dans un projet QC Lab. Le twin cloud reprend exactement le même moteur (mêmes z-scores, même médiane, même règle tabulée, même override STRESS), avec une contrainte en plus : aucun lookahead — chaque rebalancement mensuel ne voit que l’historique déjà publié, accumulé au fil de OnData. La fenêtre 2016 → 2026-09 couvre le choc de volatilité 2018, COVID 2020 (validation du détecteur STRESS sur un vrai épisode) et le marché baissier 2022 ; les ~18 premiers mois sont un WARMUP documenté (la fenêtre z de 252 j sur une SMA 200 exige ~452 séances avant le premier diagnostic) avec allocation par défaut 60/40. Le régime pilote l’allocation : exposition nette SPY selon la table de la partie 5, le solde en SHY. Le résultat du run réel (statistiques exposées par l’API) est collé juste après.

# [REFERENCE QC] Code a copier dans main.py QC Lab (non executable ici)
# Projet QC : 16239-macro-regimes-28b -- diagnostic reel, 6 ETF, 2019 -> 2026-09
qc_macro_diagnostic_code = '''
# 16239-macro-regimes-28b -- Diagnostic macro composite borne -> allocation mensuelle
# Lane myia-po-2026:CoursIA -- See #16239 livrable 1 (notebook QC-Py-28b)
# Proxies documents : ETF != series macro officielles (PMI/ISM indisponibles dans QC)
# Sans lookahead : chaque rebalancement n'utilise que l'historique PASSE accumule dans OnData.
from AlgorithmImports import *


class MacroRegimeAllocation(QCAlgorithm):

    exposition = {
        "EXPANSION": 1.00,
        "NEUTRE": 0.60,
        "RALENTISSEMENT": 0.30,
        "STRESS": 0.10,
        "WARMUP": 0.60,  # diagnostic pas encore calculable : defaut documente
    }

    def initialize(self):
        self.set_start_date(2016, 1, 1)
        self.set_end_date(2026, 9, 12)
        self.set_cash(100000)
        self._tickers = ["SPY", "IEF", "SHY", "HYG", "LQD", "GLD"]
        for t in self._tickers:
            self.add_equity(t, Resolution.Daily)
        self._closes = {t: [] for t in self._tickers}
        self._dates = []
        self._regimes = []
        self.schedule.on(
            self.date_rules.month_start("SPY"),
            self.time_rules.at(9, 31),
            self.rebalance,
        )

    def on_data(self, data):
        if not all(data.bars.contains_key(t) for t in self._tickers):
            return
        for t in self._tickers:
            self._closes[t].append(float(data.bars[t].close))
        self._dates.append(self.time)

    @staticmethod
    def _z_of(series):
        window = series[-252:]
        mean = sum(window) / len(window)
        std = (sum((x - mean) ** 2 for x in window) / len(window)) ** 0.5
        return 0.0 if std == 0 else (window[-1] - mean) / std

    def _diagnostic(self):
        n = len(self._dates)
        if n < 452:  # 200 j de SMA + 252 j de fenetre z
            return None
        k = min(n, 800)
        c = {t: v[-k:] for t, v in self._closes.items()}
        trend = [
            c["SPY"][i] / (sum(c["SPY"][i - 199 : i + 1]) / 200) - 1.0
            for i in range(199, k)
        ]
        slope = [c["IEF"][i] / c["SHY"][i] for i in range(k)]
        credit = [c["HYG"][i] / c["LQD"][i] for i in range(k)]
        gold_mom = [c["GLD"][i] / c["GLD"][i - 63] - 1.0 for i in range(63, k)]

        z = {
            "z_trend": self._z_of(trend),
            "z_slope": self._z_of(slope),
            "z_credit": self._z_of(credit),
            "z_gold": -self._z_of(gold_mom),  # inverse : or qui monte = demande refuge
        }

        def sig(v):
            return 1 if v > 0.5 else (-1 if v < -0.5 else 0)

        signals = sorted(sig(v) for v in z.values())
        composite = (signals[1] + signals[2]) / 2  # mediane de 4 valeurs

        if z["z_trend"] < -1.0 and z["z_credit"] < -1.0:
            regime = "STRESS"
        elif composite >= 0.5:
            regime = "EXPANSION"
        elif composite <= -0.5:
            regime = "RALENTISSEMENT"
        else:
            regime = "NEUTRE"
        return z, composite, regime

    def rebalance(self):
        result = self._diagnostic()
        if result is None:
            z, composite, regime = {}, 0.0, "WARMUP"
        else:
            z, composite, regime = result
        self._regimes.append((self.time.date().isoformat(), regime, round(composite, 2)))
        self.set_runtime_statistic("Regime", regime)
        self.set_runtime_statistic("Median", f"{composite:+.2f}")
        self.set_runtime_statistic(
            "z(trend/slope/credit/gold)",
            f"{z.get('z_trend', 0):+.2f} {z.get('z_slope', 0):+.2f} "
            f"{z.get('z_credit', 0):+.2f} {z.get('z_gold', 0):+.2f}",
        )
        expo = self.exposition[regime]
        self.set_holdings(
            [PortfolioTarget("SPY", expo), PortfolioTarget("SHY", 1.0 - expo)]
        )
        self.debug(
            f"{self.time.date()} regime={regime} median={composite:+.2f} "
            f"z_trend={z.get('z_trend', 0):+.2f} z_slope={z.get('z_slope', 0):+.2f} "
            f"z_credit={z.get('z_credit', 0):+.2f} z_gold={z.get('z_gold', 0):+.2f} "
            f"-> SPY {expo:.0%} / SHY {1 - expo:.0%}"
        )

    def on_end_of_algorithm(self):
        counts = {}
        for _, r, _m in self._regimes:
            counts[r] = counts.get(r, 0) + 1
        self.set_runtime_statistic(
            "Regimes 2016-2026",
            " ".join(f"{k}:{v}" for k, v in sorted(counts.items())),
        )
        self.debug(f"=== Regimes mensuels ({len(self._regimes)} rebalancements) ===")
        for d, r, m in self._regimes:
            self.debug(f"  {d}  {r:>15}  median={m:+.2f}")
'''
Résultat du run QC Cloud réel — projet 16239-macro-regimes-28b, backtest macro-diagnostic-allocation-28b-v2-runtimestats (id 218da14bec7cf45b629d8ebca61a6554), créé le 2026-09-15 20:38 UTC via MCP qc-mcp-lite. Fenêtre 2016-01-02 → 2026-09-12 : 2 688 séances négociables, 195 ordres, 129 rebalancements mensuels. Le twin cloud du moteur local (mêmes z-scores, même médiane, même règle tabulée, même override STRESS), sans lookahead — chaque rebalancement ne voit que l’historique déjà publié. Les ~18 premiers mois sont en WARMUP 60/40 (fenêtre z de 252 j sur SMA 200 = ~452 séances avant le premier diagnostic).

Diagnostic AS OF 2026-09 (runtime statistics du backtest, lisible via l’API) :

Indicateur z Signal
Tendance SPY/SMA200 (concomitant) +0.01 0 zone grise
Pente IEF/SHY (avanceur) −2.10 −1 très bas : le marché prix une détente
Crédit HYG/LQD (concomitant) +2.29 +1 très haut : spreads serrés, risk-on
Or 3 m inversé (retardé) +0.53 +1 demande de refuge modérée

Médiane des signaux {0, −1, +1, +1} = +0.50 → régime EXPANSION — à la limite exacte de la règle tabulée : deux concomitants expansifs (tendance, crédit) emportent la décision malgré un avanceur (pente) très dégradé. C’est la configuration « scénario à surveiller » de la cellule suivante.

Statistiques de l’allocation suivie (2016 → 2026-09) :

Métrique (API backtest) Valeur Lecture
Sharpe ratio 0.512 rendement ajusté au risque modeste mais positif sur 10,7 ans
Rendement annuel composé 9.864 % le coût du défensif : chaque mois hors EXPANSION réduit l’exposition
Drawdown maximal 15.400 % à comparer à l’ordre de 34 % subi par SPY seul sur le choc COVID (chiffre public) : le budget réduit amortit la queue
Return total +173.694 % equity finale $273 694 (runtime statistic) pour $100 000 initiaux
Régimes (129 rebalancements) EXPANSION 39 · NEUTRE 39 · RALENTISSEMENT 26 · STRESS 3 · WARMUP 22 l’override STRESS est sélectif : 3 déclenchements en 10,7 ans, dont la fenêtre COVID (journal QC)

Le journal complet (régime et z-scores à chacun des 129 rebalancements) est visible sur la page du backtest QuantConnect ; le tableau ci-dessus reporte les statistiques et runtime statistics exposées par l’API. Le compromis amortissement/rendement — 15,4 % de drawdown au lieu de ~34 % sur COVID, contre un CAGR sacrifié — est exactement le choix de gestion que la partie 5 pose ex ante dans sa table.

Interprétation du diagnostic réel (as of 2026-09 : EXPANSION, médiane +0.50, limitrophe).

  • La lecture immédiate du as of : l’avanceur (pente, z = −2.10) est très dégradé pendant que les concomitants (crédit z = +2.29, tendance z = +0.01) restent expansifs — la médiane tranche EXPANSION par exactement +0.50, la valeur limite. Un seul indicateur qui bouge (la tendance vers −0.5, ou la pente déjà à −1 confirmée par le crédit) fait basculer en NEUTRE : c’est un régime fragile au sens de la règle tabulée, ce que la zone grise de la partie 3 formalise.
  • Hypothèse d’évolution, indicateur par indicateur — ce qui ferait basculer le régime : la pente (avanceur) se retournerait la première si le marché commençait à prix une politique plus dure ou plus laxiste ; la tendance SPY est le concomitant le plus rapide à confirmer ; le crédit HYG/LQD valide ou infirme la cassure en quelques séances ; l’or ne compterait qu’en dernier recours (refuge persistant = stress persistant).
  • Scénario central vs scénario adverse : dans le central, les quatre familles restent cohérentes et le régime évolue lentement — le budget de risque de la partie 5 bouge peu. Dans l’adverse, un avanceur (pente) se retourne contre un concomitant encore expansif : c’est exactement la configuration NEUTRE prolongée, où la médiane refuse de trancher — et c’est la bonne réponse, pas une panne du modèle.

5. Traduction : allocation, exposition, budget de risque

Le régime n’est pas un signal d’achat : c’est un cadre de risque. La table ci-dessous est une décision de gestion posée explicitement — discutable, modifiable, mais engagée par écrit, donc auditable. C’est l’anti-thèse du « le marché semble nerveux, réduisons un peu ».

Régime Exposition nette max Vol cible Sizing Stops
EXPANSION 100 % 12 % complet larges (2 ATR)
NEUTRE 60 % 8 % 2/3 normaux (1.5 ATR)
RALENTISSEMENT 30 % 5 % 1/3 serrés (1 ATR)
STRESS 10 % 3 % minimal tactiques ou flat

Deux liens dans la série QC : QC-Py-10-Risk-Management (dimensionnement, vol cible — le comment du budget) et QC-Py-13-Alpha-Generation (le où dépenser le budget d’exposition). 28b fournit le combien, selon le régime macro.

from dataclasses import dataclass


@dataclass(frozen=True)
class RiskBudget:
    regime: str
    exposition_nette_max: float  # fraction maximale du capital engagee en net
    vol_cible: float             # volatilite annuelle visee du portefeuille
    sizing_factor: float         # multiplicateur de taille de position
    stop_policy: str


def translate(regime):
    """Table EXPLICITE : chaque regime a exactement UN budget de risque. Falsifiable."""
    table = {
        "EXPANSION": RiskBudget("EXPANSION", 1.00, 0.12, 1.00, "stops larges (2 ATR)"),
        "NEUTRE": RiskBudget("NEUTRE", 0.60, 0.08, 0.67, "stops normaux (1.5 ATR)"),
        "RALENTISSEMENT": RiskBudget("RALENTISSEMENT", 0.30, 0.05, 0.33, "stops serres (1 ATR)"),
        "STRESS": RiskBudget("STRESS", 0.10, 0.03, 0.10, "stops tactiques ou flat"),
    }
    return table[regime]


# Application au carnet synthetique de la partie 3 : budget mois par mois
budgets = [translate(r) for r in monthly["regime"]]
budget_df = pd.DataFrame([b.__dict__ for b in budgets], index=monthly.index)

# Cout d'opportunite du defensif : trajectoire cumulee du proxy de marche x budget applique
retours = df_z["z_trend"].resample("ME").last().diff().fillna(0) * 0.10  # proxy illustratif
toujours_actif = (1 + retours).cumprod()
suivi_regime = (1 + retours * budget_df["exposition_nette_max"].values).cumprod()
print(f"Capital final sans diagnostic (toujours expose) : {toujours_actif.iloc[-1]:.3f}")
print(f"Capital final avec diagnostic (budget par regime) : {suivi_regime.iloc[-1]:.3f}")
print()
print("Budgets des 8 derniers mois du synthetique :")
print(budget_df.tail(8).to_string())
Capital final sans diagnostic (toujours expose) : 0.824
Capital final avec diagnostic (budget par regime) : 1.256

Budgets des 8 derniers mois du synthetique :
                    regime  exposition_nette_max  vol_cible  sizing_factor              stop_policy
2026-02-28       EXPANSION                   1.0       0.12           1.00     stops larges (2 ATR)
2026-03-31       EXPANSION                   1.0       0.12           1.00     stops larges (2 ATR)
2026-04-30          NEUTRE                   0.6       0.08           0.67  stops normaux (1.5 ATR)
2026-05-31          NEUTRE                   0.6       0.08           0.67  stops normaux (1.5 ATR)
2026-06-30  RALENTISSEMENT                   0.3       0.05           0.33     stops serres (1 ATR)
2026-07-31  RALENTISSEMENT                   0.3       0.05           0.33     stops serres (1 ATR)
2026-08-31          STRESS                   0.1       0.03           0.10  stops tactiques ou flat
2026-09-30          STRESS                   0.1       0.03           0.10  stops tactiques ou flat

Lecture économique de la traduction.

  • Le budget de risque est une décision, pas une prédiction : la table ne dit pas « le marché va baisser », elle dit « si le diagnostic est RALENTISSEMENT, alors l’exposition nette plafonne à 30 % ». La responsabilité du gestionnaire se joue dans la table (ex ante), pas dans la justification après coup.
  • Le coût d’opportunité du défensif est réel et mesuré sur le synthétique : chaque mois passé sous EXPANSION avec un budget réduit coûte du rendement si le marché monte quand même. Un cadre honnête affiche ce coût à côté du drawdown évité — l’exercice 3 le mesure sur l’épisode COVID réel de la partie 4.
  • La granularité est volontairement grossière (4 régimes) : une table à 10 régimes serait une fausse précision, personne ne sait distinguer 10 états macro avec 4 indicateurs proxy. Le lissage se fait par hystérésis de décision (on ne bascule le budget qu’après confirmation), pas en multipliant les états.

6. Exercices

Trois exercices appliqués, du plus mécanique au plus interprétatif. Les stubs s’exécutent sans erreur (règle C.1) ; les attendus et anti-pièges sont rassemblés après les énoncés.

  1. Exercice 1 (registre) — ajouter un 5e indicateur (proxy volatilité) au diagnostic synthétique et tester la bascule.
  2. Exercice 2 (robustesse) — médiane contre moyenne : que devient le diagnostic quand une erreur de publication injecte un outlier ?
  3. Exercice 3 (décision) — traduire le régime STRESS du run QC réel en budget de risque et mesurer le drawdown évité sur la fenêtre COVID.

Exercice 1 — Un cinquième indicateur (proxy volatilité)

Construire sur le jeu synthétique de la partie 3 une série z_vol : volatilité réalisée sur 21 jours de z_trend.diff(), z-scorée, inversée (la vol monte = risque OFF). Puis recomposer le diagnostic à 5 indicateurs et comparer le nombre de transitions avec la version à 4.

  • Étape 1 : vol = z_trend.diff().rolling(21).std() puis zscore.
  • Étape 2 : ajouter la colonne à df_z, relancer compute_diagnostic.
  • Indice : avec 5 signaux (nombre impair), la médiane redevient une valeur observée — plus besoin de moyennener les deux centraux. Quel effet sur la zone grise ?
# Exercice 1 -- stub (a completer par l'etudiant)
# Etape 1 : z_vol = -zscore(volatilite realisee 21 j de z_trend.diff())
# Etape 2 : diagnostic_5 = compute_diagnostic(df_z + colonne z_vol)
# Etape 3 : comparer le nombre de transitions mensuelles 4 vs 5 indicateurs

diagnostic_5_indicateurs = None  # TODO etudiant

if diagnostic_5_indicateurs is None:
    print("Exercice a completer : ajouter z_vol puis recomposer le diagnostic a 5 indicateurs")
Exercice a completer : ajouter z_vol puis recomposer le diagnostic a 5 indicateurs

Exercice 2 — Médiane contre moyenne : l’outlier de publication

Injecter une erreur de publication : z_slope_corrompu = df_z["z_slope"].copy() avec 5 jours forcés à +5.0 (une erreur de reprise de données, classique). Comparer le composite médiane (le moteur) avec un composite moyenne sig.mean(axis=1) sur la fenêtre corrompue.

  • Étape 1 : construire la version corrompue du DataFrame.
  • Étape 2 : recalculer les deux composites et leurs régimes.
  • Étape 3 : compter les jours où la moyenne change le régime mais pas la médiane.
  • Indice : avec 4 signaux dont un à +1 « fabriqué », la moyenne monte mécaniquement de +0.25 — dans quelle colonne de la règle tabulée cela fait-il basculer ?
# Exercice 2 -- stub (a completer par l'etudiant)
# Etape 1 : 5 jours de z_slope forces a +5.0 (erreur de publication)
# Etape 2 : composite mediane (moteur) vs composite moyenne sur la fenetre corrompue
# Etape 3 : jours ou la moyenne bascule le regime mais pas la mediane

jours_bascule_moyenne_pas_mediane = None  # TODO etudiant

if jours_bascule_moyenne_pas_mediane is None:
    print("Exercice a completer : quantifier la robustesse mediane vs moyenne face a l'outlier")
Exercice a completer : quantifier la robustesse mediane vs moyenne face a l'outlier

Exercice 3 — Le drawdown évité de la fenêtre COVID (run réel)

Dans le tableau du run QC Cloud (partie 4), repérer la fenêtre 2020-02 → 2020-06. Avec translate() et le proxy de rendement de l’exercice de la partie 5 (ou un SPY téléchargé par ailleurs), mesurer le drawdown cumulé sans diagnostic (exposition 100 %) contre avec diagnostic (budget du régime de chaque mois).

  • Étape 1 : isoler les mois STRESS / RALENTISSEMENT de la fenêtre.
  • Étape 2 : appliquer translate(regime).exposition_nette_max à chaque mois.
  • Étape 3 : comparer drawdown max et capital final ; interpréter l’écart résiduel (le diagnostic réagit pendant la crise, pas avant).
  • Indice : l’override STRESS de la partie 3 est volontairement en retard — quel mois du tableau réel illustre ce retard assumé ?
# Exercice 3 -- stub (a completer par l'etudiant)
# Etape 1 : fenetre COVID du tableau QC reel (2020-02 -> 2020-06), regimes mensuels
# Etape 2 : exposition = translate(regime).exposition_nette_max par mois
# Etape 3 : drawdown max et capital final avec vs sans diagnostic + interpretation

drawdown_evite_covid = None  # TODO etudiant

if drawdown_evite_covid is None:
    print("Exercice a completer : mesurer le drawdown evite sur la fenetre COVID du run QC")
Exercice a completer : mesurer le drawdown evite sur la fenetre COVID du run QC

Attendus et anti-pièges

Exercice 1. Attendu : la série z_vol inverseée est bien corrélée à −z_trend ; avec 5 signaux, la médiane passe par une valeur observée → la part de NEUTRE bouge (en général à la baisse) et les transitions deviennent plus nettes aux virages. Anti-piège : oublier le signe moins sur z_vol (vol haute = signal −1, pas +1) ; et recomparer les transitions sur des fenêtres mensuelles resamplées pareil, sinon on compare du journalier bruité contre du mensuel lissé.

Exercice 2. Attendu : 5 jours d’outlier suffisent à faire basculer la moyenne vers EXPANSION/NEUTRE haut pendant que la médiane reste immobile (les 3 autres signaux non corrompus l’emportent) — l’écart doit se concentrer exactement sur la fenêtre corrompue. Anti-piège : injecter l’outlier sur df_z puis appeler signal_from_z sur le +5.0 donne +1, pas +5 — le seuil a déjà saturé le signal ; c’est bien la moyenne des signaux (0.25 × 4 = mécanique) qu’il faut tracer, pas le z-score brut.

Exercice 3. Attendu : le drawdown évité est important mais non total — février 2020 bascule le diagnostic après le début de la chute (l’override exige la conjonction tendance + crédit), et le budget 10 % reste exposé pendant STRESS. L’écart résiduel est la leçon : un diagnostic macro borné amortit, il ne neutralise pas. Anti-piège : mesurer le drawdown sur le capital cumulé (produit des rendements pondérés), pas sur la somme des rendements mensuels ; et ne pas « recaler » les régimes avec le bénéfice du hindsight — on utilise les régimes tels qu’ils apparaissent dans le tableau au fil de l’eau.

7. Limites et honnêteté du socle

  • Proxies ≠ séries officielles. SPY/IEF/SHY/HYG/LQD/GLD capturent une image de marché des indicateurs, pas les grandeurs économiques (l’ETF pente réagit aux anticipations, la vraie pente aux émissions). Les séries ISM/PMI/permis ne sont pas dans QC — verdict RECOVERABLE-MACHINE assumé et documenté : le socle est un cadre pédagogique exécutable en cloud, pas une réplique du NBER.
  • Publication et révisions. Sur proxies ETF ce lag disparaît (données de marché continues) — c’est un avantage opérationnel mais une différence d’interprétation : on diagnostique ce que le marché en pense, pas ce que les instituts mesurent.
  • Single-country US. La table, les seuils et les proxies sont calibrés US ; transposer au Brésil ou à la zone euro exige de reconstruire le registre (partie 2), pas seulement de changer les tickers.
  • Le régime n’est pas un signal court terme. Un diagnostic NEUTRE ne dit rien du mois prochain (lien vers QC-Py-28 pour la détection prix court terme) ; il cadre l’exposition de fond. L’utiliser pour du market timing quotidien est un contresens d’usage, pas une limite du moteur.

Conclusion

Ce que couvre ce livrable (mapping acceptance #16239, livrable 1) :

  • Support exécutable couvrant les phases macro : moteur local (compute_diagnostic + test synthétique) et run réel QuantConnect Cloud 2019 → 2026-09, COVID inclus.
  • Indicateurs avancés et concomitants reliés à une décision : registre taxonomique (partie 2) → diagnostic borné (parties 3-4) → table régime → budget de risque explicite (partie 5).
  • Exercice appliqué au résultat interprété : trois exercices, dont la mesure du drawdown évité sur le run réel, avec attendus et anti-pièges.

Fil de la série : 28 détecte les régimes sur les prix ; 28b diagnostique depuis l’économie et traduit en budget de risque ; 10 et 13 dépensent ce budget. Le registre (partie 2) est conçu pour être étendu — le vrai régime avanceur de votre zone d’investissement n’est probablement pas le même que celui du registre US.

See #16239 (livrable 1 sur 4).

Retour au sommet