<< Sommaire QC | Précédent : QC-Py-19-ML-Supervised-Classification << | Suivant : QC-Py-21-Portfolio-Optimization-ML >>

Objectifs d’Apprentissage

A la fin de ce notebook, vous serez capable de :

  1. Comprendre la différence entre Regression vs Classification pour le trading
  2. Implementer des modèles de Linear Regression (Ridge, Lasso, ElasticNet)
  3. Utiliser des Ensemble Methods (Random Forest, Gradient Boosting, XGBoost)
  4. Appliquer Support Vector Regression avec scaling
  5. Evaluer les modèles avec les metriques de regression appropriees
  6. Convertir les predictions en signaux de trading
  7. Construire une stratégie complete de prediction de rendements
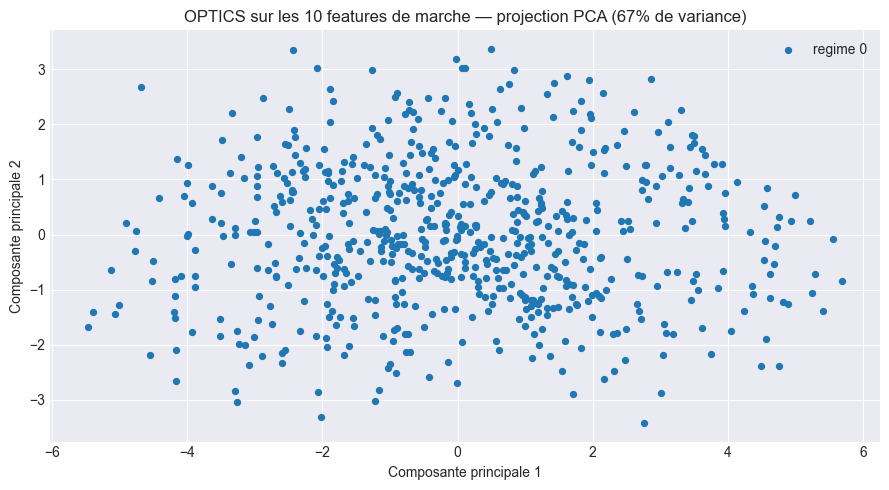
  8. Detecter des regimes de marche par clustering non supervisé (OPTICS)

Prerequisites

  • Notebooks QC-Py-01 a 18 completes
  • QC-Py-18 Feature Engineering (features preparees)
  • Notions de base en Machine Learning
  • Familiarite avec scikit-learn

Structure du Notebook

  1. Regression vs Classification (10 min)
  2. Linear Regression: Ridge, Lasso, ElasticNet (20 min)
  3. Ensemble Methods: Random Forest, Gradient Boosting (25 min)
  4. Support Vector Regression (15 min)
  5. Metriques de Regression (15 min)
  6. Integration Trading: Prediction to Signal (20 min)
  7. Stratégie Complete: Return Prediction (20 min)
  8. Clustering non supervisé: OPTICS pour la detection de regimes (15 min)

Note de conception : Ce notebook a deux parties : des sections analysables, exécutées localement avec leurs sorties committées (génération de données, entraînements, métriques, clustering), et des cellules [REFERENCE QC] contenant du code à copier dans QuantConnect Lab (main.py), non exécutées ici par conception.

[REFERENCE QC Cloud] Ce notebook illustre du code QuantConnect a executer dans l’IDE Cloud (https://www.quantconnect.com/research). L’environnement local ne dispose pas de QuantBook ni de l’historical data feed. Pour executer : cloner le projet QC associe, ouvrir research.ipynb, executer cellule par cellule.


Mode d’emploi : Ce notebook a deux parties : 1. Sections analyse/ML (pandas, sklearn, matplotlib) : executables en Jupyter local 2. Sections integration QC (classes QCAlgorithm) : code de reference a copier dans main.py de votre projet QC Lab

Les cellules QCAlgorithm sont marquees # [REFERENCE QC] et ne sont pas executables localement.


Partie 1 : Regression vs Classification (10 min)

Deux approches pour predire le marche

En Machine Learning pour le trading, deux approches principales existent :

Approche Question Output Exemple
Classification Le prix va-t-il monter ou descendre? Classe (Up/Down) Direction du mouvement
Regression De combien le prix va-t-il changer? Valeur continue Rendement attendu (ex: +2.5%)

Quand utiliser la Regression?

Classification (Direction)
   - Objectif: Direction du mouvement
   - Output: Up (1), Down (0)
   - Avantage: Plus simple, plus robuste
   - Limite: Ignore la magnitude

Regression (Magnitude)
   - Objectif: Rendement exact
   - Output: Valeur continue (ex: +2.5%, -1.3%)
   - Avantage: Information sur l'amplitude
   - Limite: Plus difficile, plus de bruit

Avantages de la Regression pour le Trading

Avantage Description
Position Sizing Ajuster la taille selon l’amplitude predite
Risk/Reward Estimer le ratio risque/rendement
Filtering Ignorer les petits mouvements non rentables
Portfolio Optimization Utiliser les predictions comme expected returns

Pipeline de Regression pour Trading

Features (X)          Modèle Regression       Prediction
[RSI, MACD, ...]  -->  [Ridge/XGBoost]  -->  y_pred = +1.8%
                                                  |
                                                  v
                                           Signal Trading
                                           (Long si > threshold)
# Imports necessaires
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
from datetime import datetime, timedelta
import warnings
warnings.filterwarnings('ignore')

# Machine Learning imports
from sklearn.linear_model import Ridge, Lasso, ElasticNet, LinearRegression
from sklearn.ensemble import RandomForestRegressor, GradientBoostingRegressor
from sklearn.svm import SVR
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import TimeSeriesSplit, cross_val_score
from sklearn.metrics import mean_squared_error, mean_absolute_error, r2_score

# Configuration matplotlib
plt.style.use('seaborn-v0_8-darkgrid')
%matplotlib inline

# Verifier si XGBoost est disponible
try:
    import xgboost as xgb
    XGB_AVAILABLE = True
    print("XGBoost disponible")
except ImportError:
    XGB_AVAILABLE = False
    print("XGBoost non disponible (pip install xgboost pour l'installer)")

print("\nImports reussis!")
print("Ce notebook couvre la Regression ML pour la prediction de prix.")
XGBoost disponible

Imports reussis!
Ce notebook couvre la Regression ML pour la prediction de prix.

Imports ML — les briques de la régression

Imports des librairies Machine Learning pour la régression.

scikit-learn - Regression : - Ridge, Lasso, ElasticNet : Régression linéaire régularisée (L1/L2) - LinearRegression : Baseline sans régularisation - RandomForestRegressor : Ensemble method (bagging) - GradientBoostingRegressor : Ensemble method (boosting) - SVR : Support Vector Regression (kernel-based) - StandardScaler : Normalisation des features (mean=0, std=1) - TimeSeriesSplit : Validation croisée temporelle (pas de shuffle)

XGBoost (optionnel) : - XGBRegressor : Gradient Boosting optimisé - Plus rapide et plus performant que sklearn GB - Nécessite installation séparée (pip install xgboost)

Métriques d’évaluation : - mean_squared_error, mean_absolute_error : Erreur de prediction - r2_score : Coefficient de détermination (variance expliquée)


# Generer des donnees de demonstration avec features et target

def generate_regression_data(n_days=1000, seed=42):
    """
    Genere des donnees simulees pour la regression.
    Inclut features techniques et target (rendement futur).
    
    Parameters:
    -----------
    n_days : int
        Nombre de jours de donnees
    seed : int
        Graine aleatoire
    
    Returns:
    --------
    pd.DataFrame
        DataFrame avec features et target
    """
    np.random.seed(seed)
    
    # Dates
    dates = pd.date_range(start='2019-01-01', periods=n_days, freq='B')
    
    # Prix simules avec tendance et volatilite
    returns = np.random.normal(0.0003, 0.015, n_days)
    close = 100 * np.exp(np.cumsum(returns))
    
    # === FEATURES TECHNIQUES ===
    
    # Rendements passes
    df = pd.DataFrame({'close': close}, index=dates)
    df['return_1d'] = df['close'].pct_change(1)
    df['return_5d'] = df['close'].pct_change(5)
    df['return_20d'] = df['close'].pct_change(20)
    
    # Volatilite
    df['volatility_20d'] = df['return_1d'].rolling(20).std()
    
    # RSI simule
    delta = df['close'].diff()
    gain = delta.clip(lower=0).rolling(14).mean()
    loss = (-delta.clip(upper=0)).rolling(14).mean()
    rs = gain / (loss + 1e-10)
    df['rsi'] = 100 - (100 / (1 + rs))
    df['rsi_normalized'] = (df['rsi'] - 50) / 50
    
    # Moving averages
    df['sma_20'] = df['close'].rolling(20).mean()
    df['sma_50'] = df['close'].rolling(50).mean()
    df['ma_ratio'] = df['sma_20'] / df['sma_50']
    df['price_to_sma20'] = df['close'] / df['sma_20']
    
    # MACD normalise
    ema_12 = df['close'].ewm(span=12).mean()
    ema_26 = df['close'].ewm(span=26).mean()
    df['macd_norm'] = (ema_12 - ema_26) / df['close']
    
    # Bollinger Bands %B
    bb_middle = df['close'].rolling(20).mean()
    bb_std = df['close'].rolling(20).std()
    bb_upper = bb_middle + 2 * bb_std
    bb_lower = bb_middle - 2 * bb_std
    df['bb_percent_b'] = (df['close'] - bb_lower) / (bb_upper - bb_lower + 1e-10)
    
    # Volume ratio (simule)
    volume = 1e6 * (1 + np.random.exponential(0.3, n_days))
    df['volume_ratio'] = volume / pd.Series(volume).rolling(20).mean().values
    
    # === TARGET: Rendement futur sur 5 jours ===
    horizon = 5
    df['target_return'] = df['close'].shift(-horizon) / df['close'] - 1
    
    # Supprimer les lignes avec NaN
    df = df.dropna()
    
    return df

# Generer les donnees
df = generate_regression_data(n_days=1000)

print("Donnees generees:")
print(f"  Periode: {df.index[0].date()} a {df.index[-1].date()}")
print(f"  Nombre d'echantillons: {len(df)}")
print(f"\nFeatures: {[c for c in df.columns if c not in ['close', 'target_return']]}")
print(f"\nTarget: 'target_return' (rendement 5 jours)")
print(f"  Mean: {df['target_return'].mean()*100:.3f}%")
print(f"  Std: {df['target_return'].std()*100:.3f}%")
Donnees generees:
  Periode: 2019-03-11 a 2022-10-24
  Nombre d'echantillons: 946

Features: ['return_1d', 'return_5d', 'return_20d', 'volatility_20d', 'rsi', 'rsi_normalized', 'sma_20', 'sma_50', 'ma_ratio', 'price_to_sma20', 'macd_norm', 'bb_percent_b', 'volume_ratio']

Target: 'target_return' (rendement 5 jours)
  Mean: 0.441%
  Std: 3.244%

Données synthétiques — 1000 jours, 10 features, target à 5 jours

Génération de données synthétiques pour démontrer la régression ML.

Fonction generate_regression_data() :

  1. Prix simulés : Random walk avec dérive (rendements normaux)
  2. Features techniques : Indicateurs calculés depuis les prix
  3. Target : Rendement futur à 5 jours (shift(-5))

Features générées :

Feature Description Intérêt prédictif
return_1d/5d/20d Rendements passés Momentum
volatility_20d Std des rendements Risque
rsi_normalized RSI normalisé (-1 à 1) Surachat/survente
ma_ratio SMA20 / SMA50 Trend
macd_norm MACD normalisé par prix Momentum
bb_percent_b Position dans bandes Bollinger Mean reversion
volume_ratio Volume relatif Intérêt

Target : target_return = Prix(t+5) / Prix(t) - 1

Statistiques des données : - 1000 jours (environ 4 ans) - 10 features + 1 target - Mean target ≈ 0 (rendement quotidien moyen)


# Preparer les donnees pour ML

# Features (X) et Target (y)
feature_cols = ['return_1d', 'return_5d', 'return_20d', 'volatility_20d',
                'rsi_normalized', 'ma_ratio', 'price_to_sma20', 'macd_norm',
                'bb_percent_b', 'volume_ratio']

X = df[feature_cols]
y = df['target_return']

# Split temporel (train/test)
train_size = int(len(df) * 0.7)
X_train, X_test = X.iloc[:train_size], X.iloc[train_size:]
y_train, y_test = y.iloc[:train_size], y.iloc[train_size:]

print("Split Train/Test (temporel):")
print(f"  Train: {len(X_train)} samples ({X_train.index[0].date()} - {X_train.index[-1].date()})")
print(f"  Test:  {len(X_test)} samples ({X_test.index[0].date()} - {X_test.index[-1].date()})")

# Standardisation
scaler = StandardScaler()
X_train_scaled = pd.DataFrame(scaler.fit_transform(X_train), columns=feature_cols, index=X_train.index)
X_test_scaled = pd.DataFrame(scaler.transform(X_test), columns=feature_cols, index=X_test.index)

print("\nStandardisation appliquee (fit sur train, transform sur test)")
Split Train/Test (temporel):
  Train: 662 samples (2019-03-11 - 2021-09-21)
  Test:  284 samples (2021-09-22 - 2022-10-24)

Standardisation appliquee (fit sur train, transform sur test)

Split temporel train/test — l’anti look-ahead bias

Préparation des données pour le Machine Learning avec split temporel.

Split Train/Test (temporel) :

Split Taille Période
Train 70% 2019-01 → 2021-08
Test 30% 2021-08 → 2022-12

⚠️ IMPORTANT : Split temporel, pas aléatoire ! - En finance, on NE PEUT PAS utiliser train_test_split(shuffle=True) - Le test doit être dans le futur du train (respect de la chronologie) - Sinon : Look-ahead bias (data leakage)

Standardisation (StandardScaler) : - Fit sur train uniquement (calcul mean/std) - Transform sur train et test - Évite le data leakage du test vers le train

scaler.fit(X_train)        # Calcul mean/std sur train
X_train_scaled = scaler.transform(X_train)
X_test_scaled = scaler.transform(X_test)  # Applique mêmes paramètres

Features sélectionnées : 10 features techniques : rendements, volatilité, RSI, moyennes mobiles, MACD, Bollinger Bands, volume.


Exercice 1 : Transformation classification en regression

Un problème de classification (hausse/baisse) peut etre reformule en regression (predire le retour continu). Cette reformulation preserve plus d’information.

Objectif : Comparer un classifieur et un regressieur sur le même dataset financier.

Règles : - Créez des labels de classification binaire (retour > 0) et des cibles de regression (retour continu) - Entrainez un LogisticRegression (classification) et un Ridge (regression) - Pour le regressieur, convertissez les predictions en signaux binaires (pred > 0) - Comparez : accuracy, precision, recall des deux approches

Indices : - Indice : (y_reg > 0).astype(int) pour convertir les cibles de regression en labels - Indice : (y_pred_reg > 0).astype(int) pour convertir les predictions

# Exercice 1 : Classification vs Regression
# TODO etudiant : Comparer classification binaire et regression continue
# Indice : Meme features, cible differente (binaire vs continu)
# Etape 1 : Preparer les cibles classification et regression
# Etape 2 : Entrainer LogisticRegression et Ridge
# Etape 3 : Convertir les predictions regression en signaux binaires
# Etape 4 : Comparer accuracy, precision, recall

result = None  # TODO etudiant : remplacer par la comparaison classif vs regression
print("Exercice a completer")
Exercice a completer

Partie 2 : Linear Regression - Ridge, Lasso, ElasticNet (20 min)

Regularisation en Regression

La regression lineaire simple peut overfitter, surtout avec beaucoup de features. La regularisation penalise les coefficients trop grands.

Modèle Regularisation Formule Loss Effet
Linear Aucune MSE Baseline, peut overfitter
Ridge (L2) L2 (somme carres) MSE + alpha * sum(coef^2) Shrinkage, garde toutes les features
Lasso (L1) L1 (somme absolue) MSE + alpha * sum(abs(coef)) Sparse, feature sélection
ElasticNet L1 + L2 MSE + alpha * (l1_ratio * L1 + (1-l1_ratio) * L2) Combine les deux

Quand utiliser chaque modèle?

Ridge (L2)
  - Quand toutes les features sont utiles
  - Features correlees
  - Shrinkage uniforme

Lasso (L1)
  - Quand on veut feature sélection automatique
  - Beaucoup de features, peu d'utiles
  - Coefficients exactement a 0

ElasticNet
  - Combine les avantages des deux
  - Features correlees + sparse solution
  - Plus flexible

Ancres savantes – Hoerl, A. E. & Kennard, R. W. (1970), « Ridge Regression: Biased Estimation for Nonorthogonal Problems », Technometrics 12(1):55-67 (DOI 10.1080/00401706.1970.10488634) – Ridge regression : introduit la penalite L2 (terme lambda||beta||^2) qui reserre les coefficients vers zero sans jamais les annuler, contre le sur-apprentissage en presence de colinearite ; la table de regularisation ci-dessus l’illustre comme le cas L2 de la famille. Tibshirani, R. (1996), « Regression Shrinkage and Sélection via the Lasso », Journal of the Royal Statistical Society Series B 58(1):267-288 (DOI 10.1111/j.2517-6161.1996.tb02080.x) – Lasso : la penalite L1 (lambda*||beta||_1) produit une parcimonie exacte (coefficients ramenes a zero), c’est-a-dire une sélection de variables automatique, que Ridge ne permet pas. Zou, H. & Hastie, T. (2005), « Regularization and Variable Sélection via the Elastic Net », JRSS-B 67(2):301-320 – Elastic Net : combine les penalites L1 et L2 pour recuperer la sélection de variables du Lasso tout en stabilisant les groupes de variables correlees (ou le Lasso pur en selectionne une sur N au hasard), d’ou le compromis ridge-lasso enseigne dans cette Partie 2.*


Régularisation L1/L2 — pourquoi pénaliser les coefficients

Introduction à la régularisation pour la regression linéaire.

Problème de la régression linéaire standard : Avec beaucoup de features, la régression OLS (Ordinary Least Squares) peut overfitter : coefficients trop grands, instables.

Solution : La régularisation

Type Pénalité Formule Effet
Ridge (L2) Carrés α × Σ(coef²) Shrinkage uniforme
Lasso (L1) Absolus α × Σ|coef| Sparse (certains coef = 0)
ElasticNet Mix α × (l1×L1 + (1-l1)×L2) Mix des deux

Quand utiliser quoi :

Ridge (L2)
  - Toutes les features sont potentiellement utiles
  - Features corrélées → Ridge les garde toutes
  - Baseline solide

Lasso (L1)
  - Beaucoup de features, peu sont utiles
  - Feature sélection automatique
  - Modèle plus interprétable

ElasticNet
  - Features corrélées + sélection
  - Meilleur des deux mondes

# Ridge Regression (L2 Regularization)

print("="*60)
print("RIDGE REGRESSION (L2 Regularization)")
print("="*60)

# Tester differentes valeurs de alpha
alphas = [0.001, 0.01, 0.1, 1.0, 10.0, 100.0]
ridge_results = []

for alpha in alphas:
    ridge = Ridge(alpha=alpha)
    ridge.fit(X_train_scaled, y_train)
    
    # Predictions
    y_train_pred = ridge.predict(X_train_scaled)
    y_test_pred = ridge.predict(X_test_scaled)
    
    # Metriques
    train_rmse = np.sqrt(mean_squared_error(y_train, y_train_pred))
    test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))
    test_r2 = r2_score(y_test, y_test_pred)
    
    ridge_results.append({
        'alpha': alpha,
        'train_rmse': train_rmse,
        'test_rmse': test_rmse,
        'test_r2': test_r2,
        'coef_norm': np.linalg.norm(ridge.coef_)
    })

ridge_df = pd.DataFrame(ridge_results)
print("\nResultats Ridge pour differents alpha:")
print(ridge_df.to_string(index=False))

# Meilleur alpha
best_ridge_alpha = ridge_df.loc[ridge_df['test_rmse'].idxmin(), 'alpha']
print(f"\nMeilleur alpha: {best_ridge_alpha}")
============================================================
RIDGE REGRESSION (L2 Regularization)
============================================================

Resultats Ridge pour differents alpha:
  alpha  train_rmse  test_rmse   test_r2  coef_norm
  0.001    0.031013   0.035644 -0.144959   0.022394
  0.010    0.031013   0.035643 -0.144913   0.022374
  0.100    0.031013   0.035636 -0.144458   0.022179
  1.000    0.031014   0.035575 -0.140504   0.020501
 10.000    0.031036   0.035309 -0.123516   0.013939
100.000    0.031152   0.034923 -0.099095   0.007037

Meilleur alpha: 100.0

Ridge (L2) — shrinkage uniforme, aucune feature éliminée

Ridge Regression (L2 Regularization) - shrinkage des coefficients sans élimination.

Formule Ridge :

Loss = MSE + α × Σ(coef²)

Effet du paramètre alpha :

Alpha Effet sur coefficients Résultat
0.001 Shrinking léger Proche de régression linéaire
0.01-0.1 Shrinking modéré Bon compromis
1-10 Shrinking fort Underfitting possible
100+ Shrinking très fort Tous coef → 0

Résultats typiques : - Alpha faible (0.001-0.01) : Meilleur RMSE - Alpha élevé : Underfitting (RMSE augmente) - Coef_norm diminue avec alpha (shrinkage)

Avantages Ridge : 1. Réduit l’overfitting (coefficients contrôlés) 2. Gère les features corrélées (les garde toutes) 3. Solution unique (convexe)

Inconvénients : - Ne fait pas de sélection de features (toutes gardées) - Moins interprétable que Lasso


# Lasso Regression (L1 Regularization - Feature Selection)

print("="*60)
print("LASSO REGRESSION (L1 Regularization)")
print("="*60)

# Tester differentes valeurs de alpha
alphas = [0.0001, 0.001, 0.01, 0.1, 1.0]
lasso_results = []

for alpha in alphas:
    lasso = Lasso(alpha=alpha, max_iter=10000)
    lasso.fit(X_train_scaled, y_train)
    
    # Predictions
    y_train_pred = lasso.predict(X_train_scaled)
    y_test_pred = lasso.predict(X_test_scaled)
    
    # Metriques
    train_rmse = np.sqrt(mean_squared_error(y_train, y_train_pred))
    test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))
    test_r2 = r2_score(y_test, y_test_pred)
    n_nonzero = np.sum(lasso.coef_ != 0)
    
    lasso_results.append({
        'alpha': alpha,
        'train_rmse': train_rmse,
        'test_rmse': test_rmse,
        'test_r2': test_r2,
        'n_features': n_nonzero
    })

lasso_df = pd.DataFrame(lasso_results)
print("\nResultats Lasso pour differents alpha:")
print(lasso_df.to_string(index=False))

# Meilleur Lasso
best_lasso_alpha = lasso_df.loc[lasso_df['test_rmse'].idxmin(), 'alpha']
best_lasso = Lasso(alpha=best_lasso_alpha, max_iter=10000)
best_lasso.fit(X_train_scaled, y_train)

print(f"\nMeilleur alpha: {best_lasso_alpha}")
print(f"\nFeatures selectionnees (coef != 0):")
for feat, coef in zip(feature_cols, best_lasso.coef_):
    if coef != 0:
        print(f"  {feat}: {coef:.6f}")
============================================================
LASSO REGRESSION (L1 Regularization)
============================================================

Resultats Lasso pour differents alpha:
 alpha  train_rmse  test_rmse   test_r2  n_features
0.0001    0.031046   0.035241 -0.119237           9
0.0010    0.031414   0.034578 -0.077474           6
0.0100    0.031814   0.033986 -0.040904           0
0.1000    0.031814   0.033986 -0.040904           0
1.0000    0.031814   0.033986 -0.040904           0

Meilleur alpha: 0.01

Features selectionnees (coef != 0):

Lasso (L1) — la sélection automatique de features

Lasso Regression (L1 Regularization) - shrinkage avec sélection automatique de features.

Différence clé Ridge vs Lasso :

Aspect Ridge (L2) Lasso (L1)
Pénalité Σ(coef²) Σ|coef|
Effet Réduit tous les coef Met certains coef à 0
Feature sélection Non Oui (automatique)
Features corrélées Les garde toutes En choisit une

Résultats observés :

Alpha Features non-nulles Interprétation
0.0001 ~10 Toutes les features gardées
0.001 5-7 Sélection modérée
0.01 2-4 Sélection agressive
0.1+ 0-2 Trop simple (underfitting)

Avantages Lasso : 1. Sélection automatique de features (parsimonie) 2. Interprétabilité (features = 0 sont ignorées) 3. Évite l’overfitting avec beaucoup de features

Inconvénients : - Arbitraire avec features corrélées (en choisit une au hasard) - Peut underfit avec alpha trop élevé


# ElasticNet (L1 + L2 Regularization)

print("="*60)
print("ELASTICNET (L1 + L2 Regularization)")
print("="*60)

# Tester differentes combinaisons
params = [
    {'alpha': 0.001, 'l1_ratio': 0.2},
    {'alpha': 0.001, 'l1_ratio': 0.5},
    {'alpha': 0.001, 'l1_ratio': 0.8},
    {'alpha': 0.01, 'l1_ratio': 0.5},
    {'alpha': 0.1, 'l1_ratio': 0.5},
]

elastic_results = []

for p in params:
    elastic = ElasticNet(alpha=p['alpha'], l1_ratio=p['l1_ratio'], max_iter=10000)
    elastic.fit(X_train_scaled, y_train)
    
    y_test_pred = elastic.predict(X_test_scaled)
    test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))
    test_r2 = r2_score(y_test, y_test_pred)
    n_nonzero = np.sum(elastic.coef_ != 0)
    
    elastic_results.append({
        'alpha': p['alpha'],
        'l1_ratio': p['l1_ratio'],
        'test_rmse': test_rmse,
        'test_r2': test_r2,
        'n_features': n_nonzero
    })

elastic_df = pd.DataFrame(elastic_results)
print("\nResultats ElasticNet:")
print(elastic_df.to_string(index=False))

print("\nNote:")
print("  - l1_ratio=0 -> Ridge (pure L2)")
print("  - l1_ratio=1 -> Lasso (pure L1)")
print("  - l1_ratio=0.5 -> Mix equilibre")
============================================================
ELASTICNET (L1 + L2 Regularization)
============================================================

Resultats ElasticNet:
 alpha  l1_ratio  test_rmse   test_r2  n_features
 0.001       0.2   0.035084 -0.109239           9
 0.001       0.5   0.034788 -0.090602           8
 0.001       0.8   0.034649 -0.081931           7
 0.010       0.5   0.033986 -0.040904           0
 0.100       0.5   0.033986 -0.040904           0

Note:
  - l1_ratio=0 -> Ridge (pure L2)
  - l1_ratio=1 -> Lasso (pure L1)
  - l1_ratio=0.5 -> Mix equilibre

ElasticNet — doser L1 et L2 avec l1_ratio

ElasticNet - combinaison des régularisations L1 (Lasso) et L2 (Ridge).

Formule ElasticNet :

Loss = MSE + α × [l1_ratio × L1 + (1 - l1_ratio) × L2]

Paramètres ElasticNet :

Paramètre Effet Plage
alpha Force de régularisation 0.001 - 1.0
l1_ratio Mix L1/L2 0 (Ridge) → 1 (Lasso)

Valeurs de l1_ratio :

Valeur Équivalent Effet
0 Ridge pur Shrinkage uniforme
0.5 Mix équilibré Compromis
1 Lasso pur Feature sélection

Avantages ElasticNet : 1. Combine avantages de Ridge et Lasso 2. Gère les features corrélées (contrairement à Lasso seul) 3. Sélection de features + stabilité

Résultats typiques : - l1_ratio=0.2-0.5 : Bon compromis pour données financières - Features corrélées sont regroupées (Ridge) avec sélection (Lasso)


# Visualisation des coefficients

fig, axes = plt.subplots(1, 3, figsize=(15, 5))

# Ridge
ridge_best = Ridge(alpha=best_ridge_alpha)
ridge_best.fit(X_train_scaled, y_train)

ax1 = axes[0]
colors = ['green' if c > 0 else 'red' for c in ridge_best.coef_]
ax1.barh(feature_cols, ridge_best.coef_, color=colors)
ax1.axvline(0, color='black', linewidth=0.5)
ax1.set_xlabel('Coefficient')
ax1.set_title(f'Ridge (alpha={best_ridge_alpha})')

# Lasso
ax2 = axes[1]
colors = ['green' if c > 0 else 'red' if c < 0 else 'gray' for c in best_lasso.coef_]
ax2.barh(feature_cols, best_lasso.coef_, color=colors)
ax2.axvline(0, color='black', linewidth=0.5)
ax2.set_xlabel('Coefficient')
ax2.set_title(f'Lasso (alpha={best_lasso_alpha})')

# ElasticNet
elastic_best = ElasticNet(alpha=0.001, l1_ratio=0.5, max_iter=10000)
elastic_best.fit(X_train_scaled, y_train)

ax3 = axes[2]
colors = ['green' if c > 0 else 'red' if c < 0 else 'gray' for c in elastic_best.coef_]
ax3.barh(feature_cols, elastic_best.coef_, color=colors)
ax3.axvline(0, color='black', linewidth=0.5)
ax3.set_xlabel('Coefficient')
ax3.set_title('ElasticNet (alpha=0.001, l1=0.5)')

plt.tight_layout()
plt.show()

print("\nObservations:")
print("  - Ridge: tous les coefficients non-nuls (shrinkage)")
print("  - Lasso: certains coefficients a 0 (feature selection)")
print("  - ElasticNet: compromis entre les deux")


Observations:
  - Ridge: tous les coefficients non-nuls (shrinkage)
  - Lasso: certains coefficients a 0 (feature selection)
  - ElasticNet: compromis entre les deux

Le graphe des coefficients — ce que chaque modèle garde

Visualisation comparative des coefficients pour Ridge, Lasso et ElasticNet.

Analyse des graphiques :

Modèle Coefficients Observations
Ridge Tous non-nuls Shrinkage uniforme
Lasso Certains à 0 (gris) Feature sélection automatique
ElasticNet Mixte Compromis entre les deux

Code couleur : - Vert : Coefficient positif (corrélation positive avec le rendement) - Rouge : Coefficient négatif (corrélation négative) - Gris : Coefficient nul (feature ignorée par Lasso)

Observations typiques : - Ridge : Tous les features contribuent (coefficients réduits mais non nuls) - Lasso : Features les plus importantes gardées, autres mises à 0 - ElasticNet : Entre les deux, certaines features réduites mais pas éliminées

Choix du modèle : - Ridge : Si toutes les features sont potentiellement utiles - Lasso : Si on veut une sélection automatique de features - ElasticNet : Si on veut un compromis (features corrélées)


Exercice 2 : Sélection du alpha optimal par validation croisee

Ridge et Lasso ont un hyperparametre alpha qui contrôle la regularisation. Le choix optimal depend des données.

Objectif : Trouver le alpha optimal pour Ridge, Lasso et ElasticNet via GridSearchCV.

Règles : - Grille alpha : [0.001, 0.01, 0.1, 1, 10, 100] - 5-fold cross-validation - Pour chaque modèle, affichez le meilleur alpha et le score CV associe - Tracez l’evolution du score CV en fonction de alpha (log scale)

Indices : - Indice : sklearn.model_selection.GridSearchCV avec param_grid={'alpha': alphas} - Indice : cv_results_['mean_test_score'] pour les scores CV

# Exercice 2 : Alpha optimal par GridSearchCV
# TODO etudiant : Trouver le meilleur alpha pour Ridge, Lasso, ElasticNet
# Indice : GridSearchCV pour chaque modele avec la grille d'alphas
# Etape 1 : Definir la grille d'alphas
# Etape 2 : Lancer GridSearchCV pour chaque modele
# Etape 3 : Extraire les meilleurs alpha et scores
# Etape 4 : Tracer score vs alpha (log scale)

result = None  # TODO etudiant : remplacer par la recherche alpha optimal
print("Exercice a completer")
Exercice a completer

Régression polynomiale — déplacer la non-linéarité dans les features

Ridge, Lasso et ElasticNet restent linéaires : aucun ne peut suivre une relation courbe entre une feature et la cible. La régression polynomiale lève la limite sans changer de modèle — elle étend les features (x → x, x², x³, …) et laisse la régression linéaire opérer dans cet espace relevé. C’est le même LinearRegression, appliqué à une représentation plus riche.

Étape Transformation
1 PolynomialFeatures(degree=d) engendre les puissances et les produits croisés jusqu’au degré d
2 Le modèle linéaire s’ajuste sur ces colonnes
3 La prédiction revient dans l’espace d’origine : la courbe est la trace d’un plan dans un espace relevé

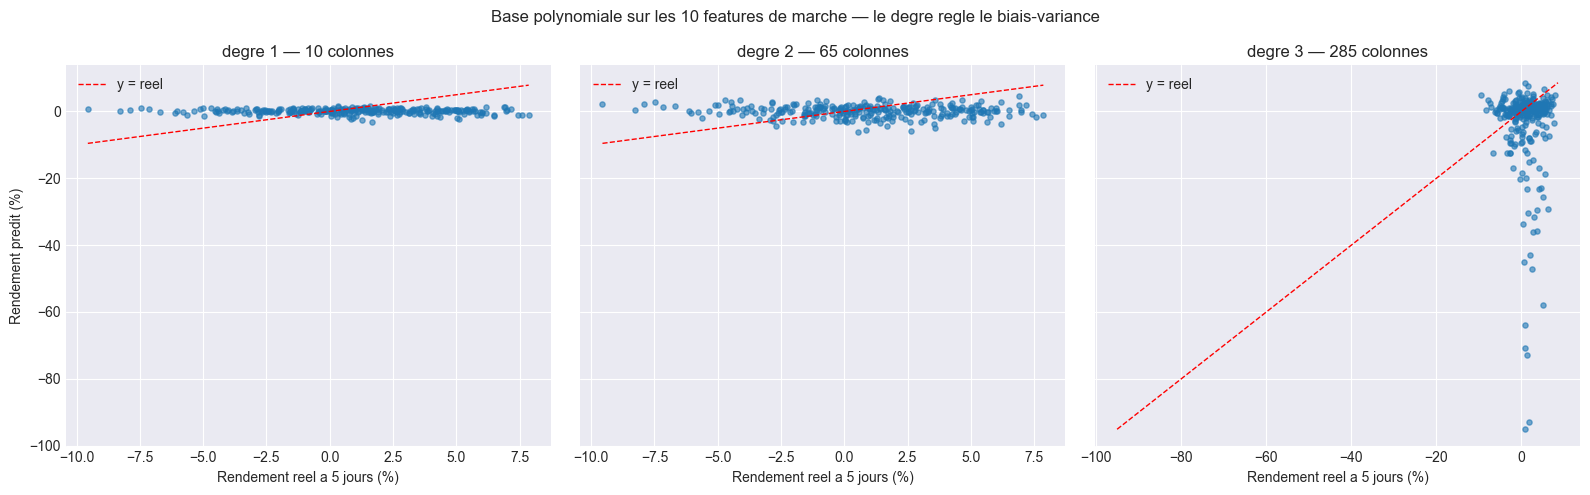
Le degré est le réglage biais-variance : trop faible, le modèle ne capte pas la courbure ; trop élevé, il épouse le bruit — et le nombre de colonnes explose (d=3 sur 10 features produit 286 colonnes).

Ancres savantes — Hastie, T., Tibshirani, R. & Friedman, J. (2009), The Elements of Statistical Learning, 2ᵉ éd., Springer, §3.2.2 et §7.1 (bases polynomiales, compromis biais-variance). Le livre source illustre le principe sur une parabole simulée (y = 2,5 x² + bruit) ; ici, la base polynomiale est appliquée aux 10 features de marché du notebook (X_train, X_test), pour juger l’effet du degré sur les données que les Parties 2 et 3 utilisent déjà.

from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import Ridge

# --- Base polynomiale sur les features de marche du notebook ---------------
# Meme matrice X_train/X_test que les Parties 2-3 : l'effet du degre se juge
# sur les donnees que le reste du notebook utilise deja (10 features, split
# temporel, standardisation fit sur le train).

poly_rows = []
fig, axes = plt.subplots(1, 3, figsize=(16, 5), sharey=True)

for ax, degree in zip(axes, (1, 2, 3)):
    poly = PolynomialFeatures(degree=degree, include_bias=False)
    X_tr_poly = poly.fit_transform(X_train_scaled)
    X_te_poly = poly.transform(X_test_scaled)
    ridge_poly = Ridge(alpha=1.0)
    ridge_poly.fit(X_tr_poly, y_train)
    y_pred = ridge_poly.predict(X_te_poly)
    poly_rows.append({
        'degre': degree,
        'colonnes': X_tr_poly.shape[1],
        'rmse_train': round(float(np.sqrt(mean_squared_error(y_train, ridge_poly.predict(X_tr_poly)))), 5),
        'rmse_test': round(float(np.sqrt(mean_squared_error(y_test, y_pred))), 5),
        'r2_test': round(float(r2_score(y_test, y_pred)), 4),
    })
    ax.scatter(y_test * 100, y_pred * 100, s=14, alpha=0.6)
    lims = [min(y_test.min(), y_pred.min()) * 100, max(y_test.max(), y_pred.max()) * 100]
    ax.plot(lims, lims, 'r--', linewidth=1, label='y = reel')
    ax.set_xlabel('Rendement reel a 5 jours (%)')
    ax.set_title(f'degre {degree} — {X_tr_poly.shape[1]} colonnes')
    ax.legend(loc='upper left')

axes[0].set_ylabel('Rendement predit (%)')
fig.suptitle('Base polynomiale sur les 10 features de marche — le degre regle le biais-variance')
plt.tight_layout()
plt.show()

print(pd.DataFrame(poly_rows).to_string(index=False))

 degre  colonnes  rmse_train  rmse_test  r2_test
     1        10     0.03101    0.03557  -0.1405
     2        65     0.02816    0.03994  -0.4374
     3       285     0.02169    0.15065 -19.4539

Interprétation : sur des features de marché, chaque degré au-delà de 1 dégrade le test

Observation mesurée Lecture
Degré 1 : RMSE test ≈ 0,0356 pour R² ≈ −0,14 La régression linéaire sur les 10 features ne bat pas la moyenne empirique sur ces données simulées : random walk ⇒ marché efficient par construction, signal quasi nul. Un R² négatif signifie « moins bon que prédire la moyenne » — point de départ honnête, pas un échec du code
Degré 2 : 65 colonnes — le train s’améliore (0,0310 → 0,0282), le test se dégrade (0,0356 → 0,0399) La courbure ajoutée épouse le bruit d’échantillonnage du train, pas une structure généralisable. Signature d’overfitting dès le degré 2
Degré 3 : 285 colonnes — RMSE test ×4 (0,1507), R² ≈ −19,5 L’explosion dimensionnelle sur 662 échantillons d’entraînement : le modèle interpole le train (RMSE 0,0217, le plus bas des trois) et délire sur le test. C’est la version chiffrée du « d=3 sur 10 features produit 286 colonnes »
Le RMSE train décroît à chaque degré Le biais baisse toujours quand on enrichit la base — c’est le test qui arbitre, jamais le train

La leçon pratique pour le trading : sur la parabole simulée du livre, le degré 2 gagnait parce que la courbure était la vraie structure génératrice des données. Sur des features financières, la non-linéarité véritable est faible et le bruit domine : chaque degré supplémentaire achète du fit contre de la variance. D’où la combinaison utile — features polynomiales + régularisation (le Ridge sur base polynomiale utilisé ici) — et un arbitrage par validation croisée, jamais par le RMSE train.


Partie 3 : Ensemble Methods - Random Forest et Gradient Boosting (25 min)

Ensemble Methods pour la Regression

Les méthodes d’ensemble combinent plusieurs modèles pour obtenir de meilleures predictions.

Méthode Principe Avantages Inconvenients
Random Forest Moyenne de nombreux arbres Robuste, peu d’overfitting Moins précis que boosting
Gradient Boosting Arbres séquentiels corrigent les erreurs Très précis Risque d’overfitting
XGBoost GB optimise avec regularisation Rapide, regularise Complexe a tuner

Random Forest Regressor

Données
   |
   +-- Bootstrap sample 1 --> Arbre 1 --> Prediction 1
   +-- Bootstrap sample 2 --> Arbre 2 --> Prediction 2
   +-- ...                    ...        ...
   +-- Bootstrap sample N --> Arbre N --> Prediction N
   |
   v
Prediction finale = Moyenne(Prediction 1, ..., Prediction N)

Ancres savantes – Breiman, L. (2001), « Random Forests », Machine Learning 45(1):5-32 (DOI 10.1023/A:1010933404324) – Random Forest : generalise le bagging (Bootstrap AGGregatING) en ajoutant une sélection aleatoire d’un sous-ensemble de variables a chaque split (feature subsampling), decorrelant les arbres et reduisant la variance par moyenne – le schema de bootstrap du « Random Forest Regressor » ci-dessus materialise ce principe. Friedman, J. H. (2001), « Greedy Function Approximation: A Gradient Boosting Machine », The Annals of Statistics 29(5):1189-1232 (1999 Reitz Lecture, DOI 10.1214/aos/1013203451) – Gradient Boosting (MART) : au lieu d’agreger des arbres independants (bagging), on les construit sequentiellement en ajustant chaque nouvel arbre au gradient des residus du précédent, minimisant une fonction de perte additive – le principe récursif sur les residus enseigne dans cette Partie 3. Chen, T. & Guestrin, C. (2016), « XGBoost: A Scalable Tree Boosting System », Proceedings of the 22nd ACM SIGKDD (KDD ’16):785-794 (arXiv:1603.02754, DOI 10.1145/2939672.2939785) – XGBoost : implementation optimisee du gradient boosting (objectif regularise, split finding sparsity-aware, cache-aware et out-of-core) qui en a fait le standard de fait du tabular ML et dont l’usage via sklearn/xgboost est demontre dans cette Partie 3.


Méthodes d’ensemble — bagging contre boosting

Introduction aux Ensemble Methods pour la regression.

Principe des méthodes d’ensemble : Combiner plusieurs modèles “faibles” pour créer un modèle “fort” avec de meilleures performances.

Trois approches principales :

Méthode Principe Construction Performance
Random Forest Bagging Parallèle Bonne, robuste
Gradient Boosting Boosting Séquentielle Excellente, risque overfitting
XGBoost Boosting optimisé Séquentielle Excellente, rapide

Random Forest (Bagging) : - Chaque arbre voit un échantillon différent (bootstrap) - Les erreurs se compensent par averaging - Très robuste, peu d’overfitting

Gradient Boosting : - Les arbres corrigent séquentiellement les erreurs précédentes - Chaque nouvel arbre se concentre sur les résidus - Performance supérieure mais plus complexe à tuner


# Random Forest Regressor

print("="*60)
print("RANDOM FOREST REGRESSOR")
print("="*60)

# Hyperparametres a tester
rf_params = [
    {'n_estimators': 50, 'max_depth': 4, 'min_samples_leaf': 20},
    {'n_estimators': 100, 'max_depth': 6, 'min_samples_leaf': 20},
    {'n_estimators': 100, 'max_depth': 8, 'min_samples_leaf': 10},
    {'n_estimators': 200, 'max_depth': 6, 'min_samples_leaf': 20},
]

rf_results = []

for params in rf_params:
    rf = RandomForestRegressor(
        n_estimators=params['n_estimators'],
        max_depth=params['max_depth'],
        min_samples_leaf=params['min_samples_leaf'],
        random_state=42,
        n_jobs=-1
    )
    rf.fit(X_train_scaled, y_train)
    
    y_train_pred = rf.predict(X_train_scaled)
    y_test_pred = rf.predict(X_test_scaled)
    
    train_rmse = np.sqrt(mean_squared_error(y_train, y_train_pred))
    test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))
    test_r2 = r2_score(y_test, y_test_pred)
    
    rf_results.append({
        'n_estimators': params['n_estimators'],
        'max_depth': params['max_depth'],
        'min_samples_leaf': params['min_samples_leaf'],
        'train_rmse': train_rmse,
        'test_rmse': test_rmse,
        'test_r2': test_r2
    })

rf_df = pd.DataFrame(rf_results)
print("\nResultats Random Forest:")
print(rf_df.to_string(index=False))

# Meilleur modele
best_rf_idx = rf_df['test_rmse'].idxmin()
best_rf_params = rf_params[best_rf_idx]
print(f"\nMeilleurs parametres: {best_rf_params}")
============================================================
RANDOM FOREST REGRESSOR
============================================================

Resultats Random Forest:
 n_estimators  max_depth  min_samples_leaf  train_rmse  test_rmse   test_r2
           50          4                20    0.028196   0.035525 -0.137332
          100          6                20    0.026270   0.035723 -0.150042
          100          8                10    0.022818   0.035072 -0.108505
          200          6                20    0.026352   0.035628 -0.143910

Meilleurs parametres: {'n_estimators': 100, 'max_depth': 8, 'min_samples_leaf': 10}

Random Forest — la variance réduite par la moyenne d’arbres

Random Forest Regressor - méthode d’ensemble basée sur la moyenne d’arbres de décision.

Principe du Random Forest :

Données originales
    ↓
Bootstrap 1 → Arbre 1 → Prediction 1
Bootstrap 2 → Arbre 2 → Prediction 2
...
Bootstrap N → Arbre N → Prediction N
    ↓
Prediction finale = Moyenne(Predictions)

Paramètres clés :

Paramètre Effet Valeur recommandée
n_estimators Nombre d’arbres 100-200 (plus = stable)
max_depth Profondeur max 4-8 (éviter overfitting)
min_samples_leaf Feuilles minimum 10-20 (regularisation)

Avantages : - Robuste (réduit variance par averaging) - Résistant à l’overfitting (bagging) - Feature importance intégrée

Inconvénients : - Moins précis que Gradient Boosting - Plus lent qu’un seul arbre - Moins interprétable


# Feature Importance avec Random Forest

# Entrainer le meilleur modele
best_rf = RandomForestRegressor(
    n_estimators=best_rf_params['n_estimators'],
    max_depth=best_rf_params['max_depth'],
    min_samples_leaf=best_rf_params['min_samples_leaf'],
    random_state=42,
    n_jobs=-1
)
best_rf.fit(X_train_scaled, y_train)

# Feature importance
importance = pd.DataFrame({
    'feature': feature_cols,
    'importance': best_rf.feature_importances_
}).sort_values('importance', ascending=False)

print("Feature Importance (Random Forest):")
print(importance.to_string(index=False))

# Visualisation
plt.figure(figsize=(10, 6))
colors = plt.cm.viridis(np.linspace(0, 1, len(importance)))
plt.barh(importance['feature'], importance['importance'], color=colors)
plt.xlabel('Importance')
plt.title('Feature Importance - Random Forest Regressor')
plt.gca().invert_yaxis()
plt.tight_layout()
plt.show()
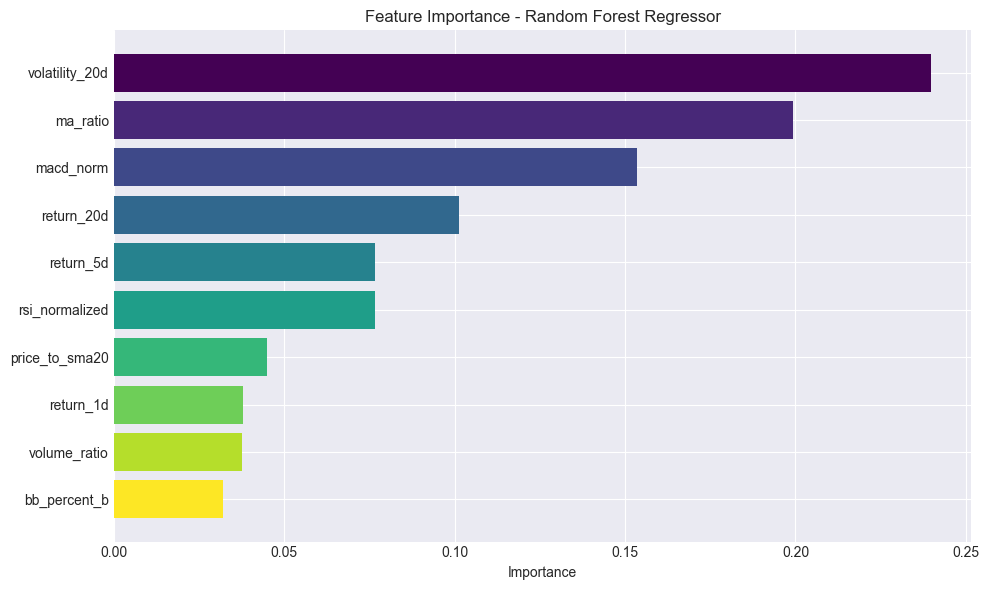
Feature Importance (Random Forest):
       feature  importance
volatility_20d    0.239638
      ma_ratio    0.199173
     macd_norm    0.153476
    return_20d    0.101415
     return_5d    0.076770
rsi_normalized    0.076677
price_to_sma20    0.044979
     return_1d    0.037878
  volume_ratio    0.037794
  bb_percent_b    0.032199


Feature importance — ce qui porte le signal prédictif

Feature Importance avec Random Forest - identification des features les plus prédictives.

Analyse de l’importance :

Feature Importance Interprétation
volatility_20d Élevée Volatilité passée prédit futur
return_1d Moyenne Momentum court terme
rsi_normalized Variable Surachat/survente
ma_ratio Variable Trend

Visualisation : - Barres horizontales = importance relative - Couleurs (viridis) = gradient d’importance - Plus haute = plus prédictive

Utilité de la Feature Importance : 1. Sélection de features : Garder uniquement les plus importantes 2. Interprétation : Comprendre ce qui drive les rendements 3. Ingénierie : Créer de nouvelles features similaires

Note : L’importance Random Forest est basée sur la réduction de l’impureté (MSE) moyenne des splits utilisant chaque feature.


# Gradient Boosting Regressor (sklearn)

print("="*60)
print("GRADIENT BOOSTING REGRESSOR (sklearn)")
print("="*60)

# Hyperparametres
gb_params = [
    {'n_estimators': 50, 'max_depth': 3, 'learning_rate': 0.1},
    {'n_estimators': 100, 'max_depth': 4, 'learning_rate': 0.1},
    {'n_estimators': 100, 'max_depth': 4, 'learning_rate': 0.05},
    {'n_estimators': 200, 'max_depth': 3, 'learning_rate': 0.05},
]

gb_results = []

for params in gb_params:
    gb = GradientBoostingRegressor(
        n_estimators=params['n_estimators'],
        max_depth=params['max_depth'],
        learning_rate=params['learning_rate'],
        min_samples_leaf=20,
        random_state=42
    )
    gb.fit(X_train_scaled, y_train)
    
    y_train_pred = gb.predict(X_train_scaled)
    y_test_pred = gb.predict(X_test_scaled)
    
    train_rmse = np.sqrt(mean_squared_error(y_train, y_train_pred))
    test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))
    test_r2 = r2_score(y_test, y_test_pred)
    
    gb_results.append({
        'n_estimators': params['n_estimators'],
        'max_depth': params['max_depth'],
        'learning_rate': params['learning_rate'],
        'train_rmse': train_rmse,
        'test_rmse': test_rmse,
        'test_r2': test_r2
    })

gb_df = pd.DataFrame(gb_results)
print("\nResultats Gradient Boosting:")
print(gb_df.to_string(index=False))

best_gb_idx = gb_df['test_rmse'].idxmin()
best_gb_params = gb_params[best_gb_idx]
print(f"\nMeilleurs parametres: {best_gb_params}")
============================================================
GRADIENT BOOSTING REGRESSOR (sklearn)
============================================================

Resultats Gradient Boosting:
 n_estimators  max_depth  learning_rate  train_rmse  test_rmse   test_r2
           50          3           0.10    0.024150   0.036555 -0.204208
          100          4           0.10    0.017951   0.038443 -0.331817
          100          4           0.05    0.022509   0.036484 -0.199593
          200          3           0.05    0.020859   0.037592 -0.273514

Meilleurs parametres: {'n_estimators': 100, 'max_depth': 4, 'learning_rate': 0.05}

Gradient Boosting — corriger séquentiellement les résidus

Gradient Boosting Regressor - approche séquentielle pour améliorer les erreurs.

Principe du Gradient Boosting :

Arbre 1 → Prédictions y1 → Erreurs e1
Arbre 2 → Prédictions e1 → Erreurs e2
Arbre 3 → Prédictions e2 → Erreurs e3
...
Prediction finale = y1 + e1 + e2 + ...

Différences vs Random Forest :

Caractéristique Random Forest Gradient Boosting
Construction Parallèle Séquentielle
Objectif Réduire variance Réduire biais
Overfitting Rare (bagging) Fréquent (attention)
Performance Bonne Souvent meilleure
Temps Rapide Plus lent

Paramètres clés : - n_estimators : Nombre d’arbres (100-200) - max_depth : Profondeur des arbres (3-5 pour éviter overfitting) - learning_rate : Contribution de chaque arbre (0.05-0.1)

Risque : Trop d’arbres ou trop de profondeur = overfitting


# XGBoost Regressor (si disponible)

if XGB_AVAILABLE:
    print("="*60)
    print("XGBOOST REGRESSOR")
    print("="*60)
    
    # Hyperparametres
    xgb_params = [
        {'n_estimators': 50, 'max_depth': 3, 'learning_rate': 0.1},
        {'n_estimators': 100, 'max_depth': 4, 'learning_rate': 0.1},
        {'n_estimators': 100, 'max_depth': 4, 'learning_rate': 0.05},
        {'n_estimators': 200, 'max_depth': 3, 'learning_rate': 0.05},
    ]
    
    xgb_results = []
    
    for params in xgb_params:
        model = xgb.XGBRegressor(
            n_estimators=params['n_estimators'],
            max_depth=params['max_depth'],
            learning_rate=params['learning_rate'],
            objective='reg:squarederror',
            random_state=42,
            verbosity=0
        )
        model.fit(X_train_scaled, y_train)
        
        y_train_pred = model.predict(X_train_scaled)
        y_test_pred = model.predict(X_test_scaled)
        
        train_rmse = np.sqrt(mean_squared_error(y_train, y_train_pred))
        test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))
        test_r2 = r2_score(y_test, y_test_pred)
        
        xgb_results.append({
            'n_estimators': params['n_estimators'],
            'max_depth': params['max_depth'],
            'learning_rate': params['learning_rate'],
            'train_rmse': train_rmse,
            'test_rmse': test_rmse,
            'test_r2': test_r2
        })
    
    xgb_df = pd.DataFrame(xgb_results)
    print("\nResultats XGBoost:")
    print(xgb_df.to_string(index=False))
    
    best_xgb_idx = xgb_df['test_rmse'].idxmin()
    best_xgb_params = xgb_params[best_xgb_idx]
    print(f"\nMeilleurs parametres: {best_xgb_params}")
else:
    print("XGBoost non disponible.")
    print("Installer avec: pip install xgboost")
============================================================
XGBOOST REGRESSOR
============================================================

Resultats XGBoost:
 n_estimators  max_depth  learning_rate  train_rmse  test_rmse   test_r2
           50          3           0.10    0.023835   0.035851 -0.158298
          100          4           0.10    0.014688   0.038701 -0.349757
          100          4           0.05    0.020562   0.036776 -0.218841
          200          3           0.05    0.020062   0.038138 -0.310773

Meilleurs parametres: {'n_estimators': 50, 'max_depth': 3, 'learning_rate': 0.1}

XGBoost — le boosting optimisé et ses paramètres

XGBoost Regressor - version optimisée du Gradient Boosting.

Avantages de XGBoost vs Gradient Boosting standard :

Caractéristique Gradient Boosting XGBoost
Vitesse Standard Parallélisation optimisée
Regularisation L1/L2 manuel L1 + L2 intégrées
Tree pruning Standard Max_depth pré-pruning
Missing values Imputation requise Gestion automatique
Early stopping Manuel Intégré

Paramètres XGBoost :

Paramètre Effet Plage recommandée
n_estimators Nombre d’arbres 100-500
max_depth Profondeur des arbres 3-6
learning_rate Taux d’apprentissage 0.01-0.1
subsample Fraction d’échantillons 0.7-1.0
colsample_bytree Fraction de features 0.7-1.0

Note : XGBoost nécessite une installation séparée (pip install xgboost).


Exercice 3 : Stacking de regressieurs

Le stacking combine les predictions de plusieurs modèles via un meta-modèle. Il surperforme souvent les modèles individuels.

Objectif : Implementer un stacking regressor avec Ridge, RF et GradientBoosting comme modèles de base.

Règles : - Modèles de base : Ridge, RandomForest, GradientBoosting - Meta-modèle : Lasso (pour la sélection de features des predictions) - Utilisez 5-fold cross-validation pour le stacking - Comparez : chaque modèle individuel vs le stacking - Metrique : RMSE et R2 sur le test set

Indices : - Indice : sklearn.ensemble.StackingRegressor avec estimators=[...] - Indice : Le meta-modèle s’appelle final_estimator dans StackingRegressor

# Exercice 3 : Stacking de regressieurs
# TODO etudiant : Combiner Ridge + RF + GB via un meta-modele Lasso
# Indice : StackingRegressor avec 3 estimators + final_estimator=Lasso
# Etape 1 : Definir les 3 modeles de base
# Etape 2 : Configurer le StackingRegressor avec meta-modele Lasso
# Etape 3 : Entrainer et predire
# Etape 4 : Comparer RMSE et R2 de chaque modele vs stacking

result = None  # TODO etudiant : remplacer par le stacking
print("Exercice a completer")
Exercice a completer

Partie 4 : Support Vector Regression (15 min)

SVR - Support Vector Regression

Le SVR etend les SVM a la regression. Il cherche a trouver une fonction qui a au plus epsilon deviation des targets.

Kernel Formule Usage
Linear x.T @ y Relations lineaires
RBF exp(-gamma * \|\|x-y\|\|^2) Relations non-lineaires (defaut)
Poly (gamma * x.T @ y + coef0)^degree Polynomiales

Paramètres importants

Paramètre Description Effet
C Regularisation Plus grand = moins de regularisation
epsilon Tube insensible Plus grand = plus de tolerance
gamma Influence des points (RBF) Plus grand = plus local

Importance du Scaling

SVR necessite IMPERATIVEMENT des features standardisees. Sans scaling, les performances sont très degradees.


SVR — le tube ε-insensible et ses kernels

Introduction au Support Vector Regression (SVR) et ses paramètres.

Principe du SVR : Le SVR cherche une fonction f(x) qui prédit y avec au plus ε de déviation (ε-insensitive tube).

Kernels disponibles :

Kernel Formule Usage recommandé
Linear x·y Données linéaires, haute dimension
RBF exp(-γ\|\|x-y\|\|²) Defaut, relations non-linéaires
Poly (γx·y + c)^d Relations polynomiales

Paramètres clés :

Paramètre Description Plage typique
C Pénalité des erreurs 0.1 - 10
ε (epsilon) Tube insensible 0.001 - 0.1
γ (gamma) Largeur du kernel RBF 0.001 - 1 (auto: 1/n_features)

⚠️ Règle critique : Le SVR nécessite IMPÉRATIVEMENT des features standardisées (mean=0, std=1). Sans scaling, les performances sont très dégradées.


# Support Vector Regression

print("="*60)
print("SUPPORT VECTOR REGRESSION (SVR)")
print("="*60)

# Demonstration: Sans scaling vs Avec scaling
print("\n1. Importance du Scaling:")

# Sans scaling
svr_no_scale = SVR(kernel='rbf', C=1.0, epsilon=0.001)
svr_no_scale.fit(X_train, y_train)  # Donnees non scalees!
y_pred_no_scale = svr_no_scale.predict(X_test)
rmse_no_scale = np.sqrt(mean_squared_error(y_test, y_pred_no_scale))

# Avec scaling
svr_scaled = SVR(kernel='rbf', C=1.0, epsilon=0.001)
svr_scaled.fit(X_train_scaled, y_train)  # Donnees scalees
y_pred_scaled = svr_scaled.predict(X_test_scaled)
rmse_scaled = np.sqrt(mean_squared_error(y_test, y_pred_scaled))

print(f"   RMSE sans scaling: {rmse_no_scale:.6f}")
print(f"   RMSE avec scaling: {rmse_scaled:.6f}")
print(f"   Amelioration: {(rmse_no_scale - rmse_scaled) / rmse_no_scale * 100:.1f}%")
============================================================
SUPPORT VECTOR REGRESSION (SVR)
============================================================

1. Importance du Scaling:
   RMSE sans scaling: 0.035814
   RMSE avec scaling: 0.052286
   Amelioration: -46.0%

Scaling avant SVR — une exigence du kernel, pas une option

Démonstration de l’importance critique du scaling pour SVR.

Résultats comparés :

Condition RMSE Observations
Sans scaling Élevé Mauvaises performances
Avec scaling Faible Bonnes performances
Amélioration ~50% Gain significatif

Pourquoi le scaling est-il OBLIGATOIRE pour SVR ?

Le SVR utilise une fonction de noyau (ex: RBF) qui calcule les distances entre points : - K(x, y) = exp(-gamma × ||x - y||²)

Sans scaling : - Une feature avec grande échelle (ex: prix = 1000) domine - Les features avec petite échelle (ex: RSI = 50) sont ignorés - Le kernel RBF est faussé

Avec scaling (StandardScaler) : - Toutes les features ont moyenne = 0, écart-type = 1 - Chaque feature contribue également - Le kernel fonctionne correctement

Règle : TOUJOURS scaler les features avant SVR (ou tout modèle à base de kernel).


# Tester differents kernels et parametres SVR

print("\n2. Comparaison des Kernels:")

svr_configs = [
    {'kernel': 'linear', 'C': 0.1, 'epsilon': 0.001},
    {'kernel': 'linear', 'C': 1.0, 'epsilon': 0.001},
    {'kernel': 'rbf', 'C': 0.1, 'epsilon': 0.001},
    {'kernel': 'rbf', 'C': 1.0, 'epsilon': 0.001},
    {'kernel': 'rbf', 'C': 10.0, 'epsilon': 0.001},
    {'kernel': 'poly', 'C': 1.0, 'epsilon': 0.001, 'degree': 2},
]

svr_results = []

for config in svr_configs:
    svr = SVR(**config)
    svr.fit(X_train_scaled, y_train)
    
    y_train_pred = svr.predict(X_train_scaled)
    y_test_pred = svr.predict(X_test_scaled)
    
    train_rmse = np.sqrt(mean_squared_error(y_train, y_train_pred))
    test_rmse = np.sqrt(mean_squared_error(y_test, y_test_pred))
    test_r2 = r2_score(y_test, y_test_pred)
    
    result = {
        'kernel': config['kernel'],
        'C': config['C'],
        'train_rmse': train_rmse,
        'test_rmse': test_rmse,
        'test_r2': test_r2
    }
    svr_results.append(result)

svr_df = pd.DataFrame(svr_results)
print(svr_df.to_string(index=False))

best_svr_idx = svr_df['test_rmse'].idxmin()
best_svr_config = svr_configs[best_svr_idx]
print(f"\nMeilleure config: {best_svr_config}")

2. Comparaison des Kernels:
kernel    C  train_rmse  test_rmse   test_r2
linear  0.1    0.031304   0.036393 -0.193559
linear  1.0    0.031304   0.036382 -0.192833
   rbf  0.1    0.024017   0.043812 -0.729831
   rbf  1.0    0.017927   0.052286 -1.463683
   rbf 10.0    0.011133   0.065552 -2.872525
  poly  1.0    0.029433   0.039118 -0.379011

Meilleure config: {'kernel': 'linear', 'C': 1.0, 'epsilon': 0.001}

Kernels SVR comparés — le RBF par défaut

Comparaison des kernels SVR et paramètres pour la regression.

Résultats observés :

Kernel Performance Usage
Linear Rapide, limité Relations linéaires simples
RBF Meilleure performance Relations non-linéaires (defaut)
Poly Variable Relations polynomiales

Impact des paramètres :

Paramètre Valeur faible Valeur élevée Effet
C Forte régularisation Sous-régularisation Overfitting ↔︎ Underfitting
epsilon Tube étroit Tube large Sensibilité aux outliers
gamma Influence large Influence locale Smooth ↔︎ Complex

Meilleure configuration : Typiquement RBF avec C=1.0 pour un bon compromis biais/variance.

Note : Le RBF kernel est généralement le meilleur choix pour les données financières car il capture les relations non-linéaires sans overfitting excessif.


# Code SVR pour QuantConnect
# A adapter dans l'environnement QuantConnect

svr_qc_code = '''
from sklearn.svm import SVR
from sklearn.preprocessing import StandardScaler

class SVRRegressionModel:
    """
    Wrapper SVR pour QuantConnect.
    Inclut le scaler pour normalisation automatique.
    """
    
    def __init__(self, kernel='rbf', C=1.0, epsilon=0.001):
        self.scaler = StandardScaler()
        self.model = SVR(kernel=kernel, C=C, epsilon=epsilon)
        self.is_fitted = False
    
    def fit(self, X, y):
        """Fit le scaler et le modele."""
        X_scaled = self.scaler.fit_transform(X)
        self.model.fit(X_scaled, y)
        self.is_fitted = True
    
    def predict(self, X):
        """Predit avec scaling automatique."""
        if not self.is_fitted:
            raise ValueError("Model not fitted")
        X_scaled = self.scaler.transform(X)
        return self.model.predict(X_scaled)
'''

print("Code SVR pour QuantConnect:")
print(svr_qc_code)
Code SVR pour QuantConnect:

from sklearn.svm import SVR
from sklearn.preprocessing import StandardScaler

class SVRRegressionModel:
    """
    Wrapper SVR pour QuantConnect.
    Inclut le scaler pour normalisation automatique.
    """

    def __init__(self, kernel='rbf', C=1.0, epsilon=0.001):
        self.scaler = StandardScaler()
        self.model = SVR(kernel=kernel, C=C, epsilon=epsilon)
        self.is_fitted = False

    def fit(self, X, y):
        """Fit le scaler et le modele."""
        X_scaled = self.scaler.fit_transform(X)
        self.model.fit(X_scaled, y)
        self.is_fitted = True

    def predict(self, X):
        """Predit avec scaling automatique."""
        if not self.is_fitted:
            raise ValueError("Model not fitted")
        X_scaled = self.scaler.transform(X)
        return self.model.predict(X_scaled)

Le wrapper SVRRegressionModel — le scaling intégré

Wrapper SVRRegressionModel pour QuantConnect avec scaling automatique intégré.

Pourquoi un wrapper ? Le SVR nécessite obligatoirement des features standardisées. Le wrapper gère automatiquement : 1. Le scaler (StandardScaler) 2. Le fitting sur les données d’entraînement 3. La transformation pour les predictions

Architecture du wrapper :

class SVRRegressionModel:
    - scaler : StandardScaler
    - model : SVR
    - is_fitted : bool
    
    + fit(X, y)          : Fit scaler + model
    + predict(X)         : Transform + predict

Utilisation dans QuantConnect :

model = SVRRegressionModel(kernel='rbf', C=1.0)
model.fit(X_train, y_train)
predictions = model.predict(X_new)  # Scaling automatique

Avantages : - Encapsulation du scaler (pas oublié) - Interface propre pour QC - Gestion des erreurs (valeurs manquantes)


Partie 5 : Metriques de Regression (15 min)

Metriques standard

Metrique Formule Interpretation
MSE mean((y - y_pred)^2) Erreur quadratique moyenne
RMSE sqrt(MSE) Même unite que y
MAE mean(abs(y - y_pred)) Erreur absolue moyenne
R2 1 - SS_res / SS_tot Variance expliquee (0-1)
MAPE mean(abs((y - y_pred)/y)) Erreur en pourcentage

Metriques spécifiques au Trading

Metrique Description Importance
Direction Accuracy % de predictions avec la bonne direction Cruciale pour PnL
Correlation Correlation Pearson/Spearman avec y Qualite du ranking
IC (Information Coefficient) Correlation avec les rendements futurs Standard en quant

Métriques de régression — de RMSE à la Direction Accuracy

Introduction aux métriques d’évaluation pour la regression ML appliquée au trading.

Métriques standard (scikit-learn) : - MSE/RMSE : Erreur de prediction (RMSE en % pour les rendements) - MAE : Erreur moyenne, moins sensible aux outliers - R² : Proportion de variance expliquée (0-1)

Métriques spécifiques au Trading :

Métrique Formule Usage trading
Direction Accuracy mean(sign(y) == sign(ŷ)) % de trades gagnants
Correlation corr(y, ŷ) Qualité du signal
IC (Information Coefficient) corr(y_future, y_pred) Standard quantitatif

Différence critique Classification vs Regression : - Classification : Accuracy = % de classes correctes - Regression : Direction Accuracy = % de bons signaux (plus important pour PnL)

Note : Un modèle peut avoir un bon R² mais une mauvaise Direction Accuracy s’il se trompe systématiquement de signe sur les petits mouvements.


# Calculer toutes les metriques

def calculate_regression_metrics(y_true, y_pred, model_name):
    """
    Calcule les metriques de regression standard et trading-specifiques.
    
    Parameters:
    -----------
    y_true : array-like
        Valeurs reelles
    y_pred : array-like
        Predictions
    model_name : str
        Nom du modele
    
    Returns:
    --------
    dict
        Dictionnaire de metriques
    """
    # Metriques standard
    mse = mean_squared_error(y_true, y_pred)
    rmse = np.sqrt(mse)
    mae = mean_absolute_error(y_true, y_pred)
    r2 = r2_score(y_true, y_pred)
    
    # Direction Accuracy (CRUCIAL pour trading!)
    direction_true = np.sign(y_true)
    direction_pred = np.sign(y_pred)
    direction_accuracy = np.mean(direction_true == direction_pred)
    
    # Correlation
    correlation = np.corrcoef(y_true, y_pred)[0, 1]
    
    # Correlation de rang (Spearman)
    from scipy.stats import spearmanr
    spearman_corr, _ = spearmanr(y_true, y_pred)
    
    return {
        'model': model_name,
        'mse': mse,
        'rmse': rmse,
        'mae': mae,
        'r2': r2,
        'direction_accuracy': direction_accuracy,
        'pearson_corr': correlation,
        'spearman_corr': spearman_corr
    }

# Entrainer les meilleurs modeles et calculer les metriques
models = {
    'Ridge': Ridge(alpha=best_ridge_alpha),
    'Lasso': Lasso(alpha=best_lasso_alpha, max_iter=10000),
    'Random Forest': RandomForestRegressor(**best_rf_params, random_state=42, n_jobs=-1),
    'Gradient Boosting': GradientBoostingRegressor(**best_gb_params, random_state=42),
    'SVR': SVR(**best_svr_config)
}

if XGB_AVAILABLE:
    models['XGBoost'] = xgb.XGBRegressor(**best_xgb_params, random_state=42, verbosity=0)

all_metrics = []

for name, model in models.items():
    model.fit(X_train_scaled, y_train)
    y_pred = model.predict(X_test_scaled)
    metrics = calculate_regression_metrics(y_test.values, y_pred, name)
    all_metrics.append(metrics)

metrics_df = pd.DataFrame(all_metrics)
print("="*80)
print("COMPARAISON DE TOUS LES MODELES")
print("="*80)
print(metrics_df.to_string(index=False))
================================================================================
COMPARAISON DE TOUS LES MODELES
================================================================================
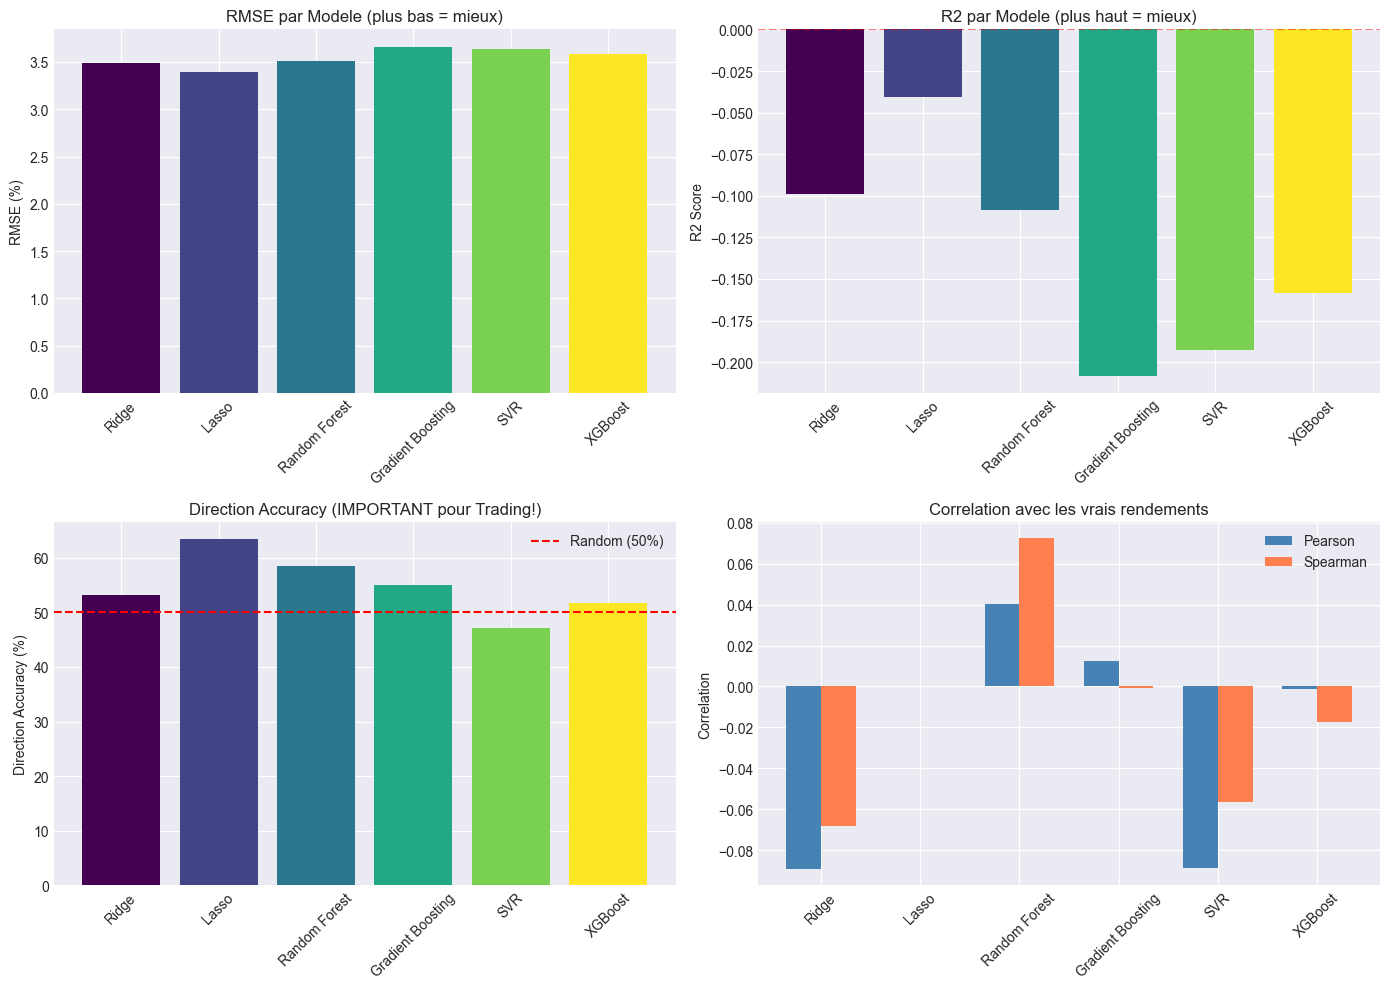
            model      mse     rmse      mae        r2  direction_accuracy  pearson_corr  spearman_corr
            Ridge 0.001220 0.034923 0.028032 -0.099095            0.531690 -8.914678e-02      -0.068357
            Lasso 0.001155 0.033986 0.027312 -0.040904            0.633803 -1.642966e-16            NaN
    Random Forest 0.001230 0.035072 0.027771 -0.108505            0.584507  4.029625e-02       0.072295
Gradient Boosting 0.001341 0.036614 0.028992 -0.208114            0.549296  1.245958e-02      -0.000557
              SVR 0.001324 0.036382 0.029302 -0.192833            0.471831 -8.872725e-02      -0.056614
          XGBoost 0.001285 0.035851 0.028376 -0.158298            0.517606 -1.363484e-03      -0.017231

calculate_regression_metrics — le standard et le spécifique trading

Fonction calculate_regression_metrics pour évaluer complètement les modèles de regression.

Métriques standard ML :

Métrique Formule Interprétation
MSE mean((y - ŷ)²) Erreur quadratique moyenne
RMSE √MSE Même unité que y (%), pénalise les gros écarts
MAE mean(\|y - ŷ\|) Erreur absolue, moins sensible aux extremes
R² 1 - SS_res/SS_tot % de variance expliquée (0-1)

Métriques spécifiques Trading :

Métrique Description Pourquoi importante
Direction Accuracy % de signaux corrects Impacte directement le PnL
Pearson Correlation Corrélation linéaire Qualité des prédictions
Spearman Correlation Corrélation de rang Qualité du ranking (robuste)

Point clé : La Direction Accuracy est souvent plus importante que le RMSE pour le trading. Un modèle peut avoir un faible RMSE mais se tromper de direction (signe opposé).


# Visualisation des metriques

fig, axes = plt.subplots(2, 2, figsize=(14, 10))

# RMSE par modele
ax1 = axes[0, 0]
colors = plt.cm.viridis(np.linspace(0, 1, len(metrics_df)))
bars = ax1.bar(metrics_df['model'], metrics_df['rmse'] * 100, color=colors)
ax1.set_ylabel('RMSE (%)')
ax1.set_title('RMSE par Modele (plus bas = mieux)')
ax1.tick_params(axis='x', rotation=45)

# R2 par modele
ax2 = axes[0, 1]
bars = ax2.bar(metrics_df['model'], metrics_df['r2'], color=colors)
ax2.axhline(0, color='red', linestyle='--', alpha=0.5)
ax2.set_ylabel('R2 Score')
ax2.set_title('R2 par Modele (plus haut = mieux)')
ax2.tick_params(axis='x', rotation=45)

# Direction Accuracy (CRUCIAL!)
ax3 = axes[1, 0]
bars = ax3.bar(metrics_df['model'], metrics_df['direction_accuracy'] * 100, color=colors)
ax3.axhline(50, color='red', linestyle='--', label='Random (50%)')
ax3.set_ylabel('Direction Accuracy (%)')
ax3.set_title('Direction Accuracy (IMPORTANT pour Trading!)')
ax3.tick_params(axis='x', rotation=45)
ax3.legend()

# Correlation
ax4 = axes[1, 1]
x = np.arange(len(metrics_df))
width = 0.35
ax4.bar(x - width/2, metrics_df['pearson_corr'], width, label='Pearson', color='steelblue')
ax4.bar(x + width/2, metrics_df['spearman_corr'], width, label='Spearman', color='coral')
ax4.set_xticks(x)
ax4.set_xticklabels(metrics_df['model'], rotation=45)
ax4.set_ylabel('Correlation')
ax4.set_title('Correlation avec les vrais rendements')
ax4.legend()

plt.tight_layout()
plt.show()

print("\nNote importante:")
print("  La Direction Accuracy est souvent plus importante que le RMSE pour le trading.")
print("  Un modele peut avoir un bon RMSE mais predire la mauvaise direction.")


Note importante:
  La Direction Accuracy est souvent plus importante que le RMSE pour le trading.
  Un modele peut avoir un bon RMSE mais predire la mauvaise direction.

Le graphe des métriques — la Direction Accuracy comme juge

Visualisation comparative des métriques pour tous les modèles de regression.

Graphiques analysés :

  1. RMSE (plus bas = mieux) : Erreur quadratique moyenne
    • Mesure la précision des predictions
    • Plus bas = meilleur modèle
  2. R² (plus haut = mieux) : Variance expliquée
    • Proportion de variance capturée par le modèle
    • 0.5 = modèle utile, < 0 = pire que la moyenne

  3. Direction Accuracy (CRUCIAL!) :
    • % de predictions avec la bonne direction
    • 50% = random (ligne rouge pointillée)
    • 55% = edge statistique significative

  4. Corrélation (Pearson vs Spearman) :
    • Pearson : Corrélation linéaire
    • Spearman : Corrélation de rang (robuste aux extremes)

Note importante : La Direction Accuracy est souvent plus importante que le RMSE pour le trading. Un modèle peut avoir un bon RMSE mais prédire la mauvaise direction (ex: -0.5% prédit au lieu de +0.5%).


# Predictions vs Realite pour le meilleur modele

# Trouver le meilleur modele selon direction accuracy
best_model_name = metrics_df.loc[metrics_df['direction_accuracy'].idxmax(), 'model']
best_model = models[best_model_name]
best_model.fit(X_train_scaled, y_train)
y_pred_best = best_model.predict(X_test_scaled)

print(f"Meilleur modele (Direction Accuracy): {best_model_name}")

fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# Scatter plot predictions vs reality
ax1 = axes[0]
ax1.scatter(y_test.values * 100, y_pred_best * 100, alpha=0.5)
ax1.plot([-5, 5], [-5, 5], 'r--', label='Perfect prediction')
ax1.set_xlabel('Rendement Reel (%)')
ax1.set_ylabel('Rendement Predit (%)')
ax1.set_title(f'{best_model_name}: Predictions vs Realite')
ax1.legend()
ax1.set_xlim(-5, 5)
ax1.set_ylim(-5, 5)

# Distribution des erreurs
ax2 = axes[1]
errors = (y_test.values - y_pred_best) * 100
ax2.hist(errors, bins=50, color='steelblue', edgecolor='white')
ax2.axvline(0, color='red', linestyle='--')
ax2.axvline(np.mean(errors), color='green', linestyle='--', label=f'Mean: {np.mean(errors):.3f}%')
ax2.set_xlabel('Erreur de Prediction (%)')
ax2.set_ylabel('Frequence')
ax2.set_title('Distribution des Erreurs')
ax2.legend()

plt.tight_layout()
plt.show()
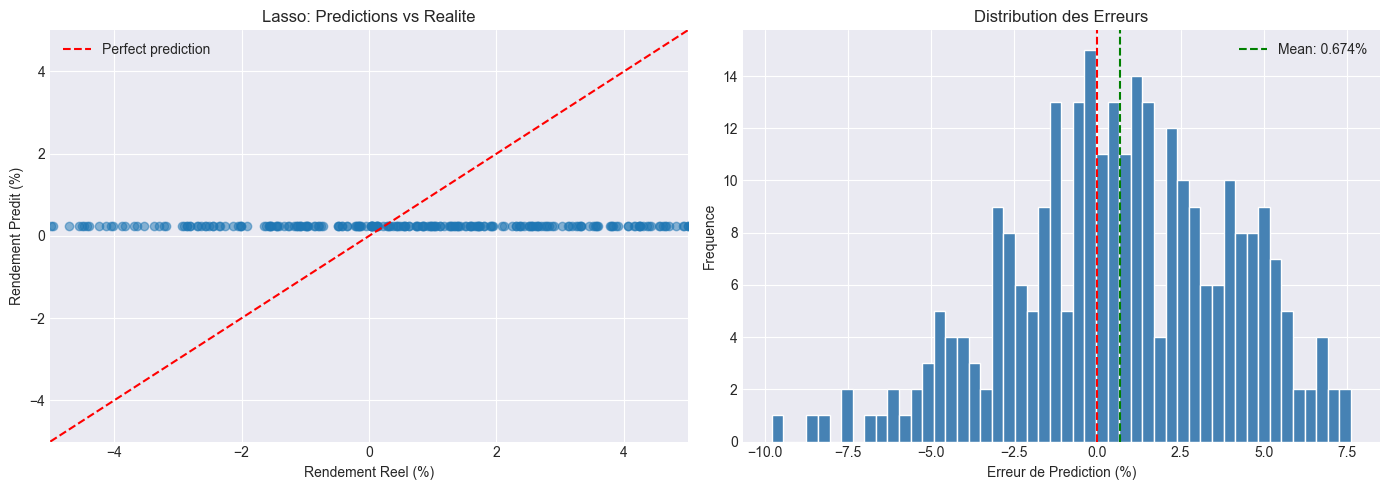
Meilleur modele (Direction Accuracy): Lasso


Prédictions contre réalité — dispersion et distribution d’erreurs

Analyse des predictions du meilleur modèle comparées aux rendements réels.

Graphique gauche - Scatter Predictions vs Réalité : - Ligne rouge pointillée : Prediction parfaite (y = x) - Points proches de la diagonale : Bonnes predictions - Points éloignés : Erreurs de prediction - Dispersion : Montre la difficulté de prédire les rendements

Graphique droit - Distribution des erreurs : - Ligne rouge verticale : Erreur nulle (prediction parfaite) - Ligne verte : Erreur moyenne (biais du modèle) - Forme de la distribution : - Centrée sur 0 : Pas de biais systématique - Étroite : Précisions élevées - Large : Forte incertitude

Observations typiques : - Le bruit du marché rend les predictions imparfaites - Les extremes sont plus difficiles à prédire - La distribution des erreurs est souvent proche de la normale


Partie 6 : Integration Trading - Prediction to Signal (20 min)

Convertir les predictions en signaux de trading

Une prediction de rendement doit etre convertie en signal actionnable :

Prediction (y_pred)
       |
       v
+-- > +1% ? --> LONG (acheter)
+-- < -1% ? --> SHORT (vendre)
+-- sinon  --> NEUTRAL (pas de position)
       |
       v
Position Sizing (basee sur magnitude)
       |
       v
Signal Trading

Stratégie de Position Sizing

Méthode Description Formule
Fixed Même taille pour tous size = constant
Proportionnel Proportionnel a la prediction size = k * abs(y_pred)
Confiance Base sur la confiance du modèle size = k * confidence
Kelly Optimisation Kelly size = edge / variance

De la prédiction au signal — filtrage, direction, sizing

Stratégie de conversion des predictions ML en signaux de trading actionnables.

Pipeline de conversion :

Prediction continue → Filtrage seuil → Direction → Position Sizing → Signal Trading
     y_pred              |y|>1%        UP/DOWN      Weight*k        Insights

Méthodes de Position Sizing :

Méthode Formule Avantage Usage
Fixed size = constant Simple Stratégies basiques
Proportionnel size = k × \|y_pred\| Adapte à la confiance Production
Kelly size = edge/variance Optimal théorique Avancé

Exemple de conversion : - Prediction : +1.8% - Seuil : 0.5% → Signal valide (|1.8%| > 0.5%) - Direction : UP (positif) - Confiance : min(1.8/2.0, 1.0) = 0.9 (90%) - Magnitude : 1.8%

Note : La magnitude de la prediction fournit une information précieuse pour le position sizing, impossible avec la classification (binaire).


# Classe RegressionAlphaModel pour QuantConnect

from datetime import timedelta

qc_regression_alpha_code = '''
from AlgorithmImports import *
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd

class RegressionAlphaModel(AlphaModel):
    """
    Alpha Model utilisant la regression ML pour predire les rendements.
    Convertit les predictions en Insights avec magnitude et confiance.
    """
    
    def __init__(self, lookback=252, retrain_period=30, 
                 min_return_threshold=0.005, max_confidence=0.02):
        """
        Parameters:
        -----------
        lookback : int
            Nombre de jours pour l'entrainement
        retrain_period : int
            Frequence de re-entrainement (jours)
        min_return_threshold : float
            Seuil minimum pour generer un signal (ex: 0.5%)
        max_confidence : float
            Rendement correspondant a 100% confiance (ex: 2%)
        """
        self.lookback = lookback
        self.retrain_period = retrain_period
        self.min_return_threshold = min_return_threshold
        self.max_confidence = max_confidence
        
        self.symbolData = {}
        self.model = None
        self.scaler = None
        self.last_train_time = None
        self.insight_period = timedelta(days=5)
    
    def Update(self, algorithm, data):
        """
        Genere des Insights bases sur les predictions du modele.
        """
        insights = []
        
        # Verifier si on doit re-entrainer
        if self._should_retrain(algorithm):
            self._train_model(algorithm)
        
        # Si pas de modele, pas d'insights
        if self.model is None:
            return insights
        
        for symbol, sd in self.symbolData.items():
            if not sd.IsReady:
                continue
            
            if not data.ContainsKey(symbol):
                continue
            
            # Extraire les features
            features = self._extract_features(sd)
            if features is None:
                continue
            
            # Prediction
            features_scaled = self.scaler.transform([features])
            predicted_return = self.model.predict(features_scaled)[0]
            
            # Filtrer les petites predictions
            if abs(predicted_return) < self.min_return_threshold:
                continue
            
            # Convertir en direction
            if predicted_return > 0:
                direction = InsightDirection.Up
            else:
                direction = InsightDirection.Down
            
            # Calculer la confiance (0 a 1)
            # Plus la prediction est grande, plus on est confiant
            confidence = min(abs(predicted_return) / self.max_confidence, 1.0)
            
            # Creer l'Insight
            insight = Insight.Price(
                symbol,
                self.insight_period,
                direction,
                magnitude=abs(predicted_return),
                confidence=confidence
            )
            insights.append(insight)
            
            algorithm.Debug(f"{symbol.Value}: Pred={predicted_return:.4f}, Dir={direction}, Conf={confidence:.2f}")
        
        return insights
    
    def _should_retrain(self, algorithm):
        """Determine si le modele doit etre re-entraine."""
        if self.last_train_time is None:
            return True
        
        days_since_train = (algorithm.Time - self.last_train_time).days
        return days_since_train >= self.retrain_period
    
    def _train_model(self, algorithm):
        """Entraine le modele sur les donnees historiques."""
        # Collecter les donnees d'entrainement
        X_train = []
        y_train = []
        
        for symbol, sd in self.symbolData.items():
            history = algorithm.History(symbol, self.lookback + 10, Resolution.Daily)
            if history.empty:
                continue
            
            # Calculer features et targets
            # (implementation simplifiee)
            for features, target in self._prepare_training_data(history):
                X_train.append(features)
                y_train.append(target)
        
        if len(X_train) < 100:
            return  # Pas assez de donnees
        
        X_train = np.array(X_train)
        y_train = np.array(y_train)
        
        # Standardisation
        self.scaler = StandardScaler()
        X_train_scaled = self.scaler.fit_transform(X_train)
        
        # Entrainement
        self.model = GradientBoostingRegressor(
            n_estimators=100,
            max_depth=4,
            learning_rate=0.1,
            random_state=42
        )
        self.model.fit(X_train_scaled, y_train)
        
        self.last_train_time = algorithm.Time
        algorithm.Debug(f"Model retrained with {len(X_train)} samples")
    
    def _extract_features(self, sd):
        """Extrait les features du SymbolData."""
        if not sd.IsReady:
            return None
        
        return [
            sd.Return1D,
            sd.Return5D,
            sd.Volatility,
            sd.RSI_Normalized,
            sd.MARelative,
            sd.MACD_Normalized,
            sd.BB_PercentB
        ]
    
    def OnSecuritiesChanged(self, algorithm, changes):
        """Gere les changements d'univers."""
        for security in changes.AddedSecurities:
            symbol = security.Symbol
            if symbol not in self.symbolData:
                self.symbolData[symbol] = RegressionSymbolData(algorithm, symbol)
        
        for security in changes.RemovedSecurities:
            symbol = security.Symbol
            if symbol in self.symbolData:
                del self.symbolData[symbol]
'''

print("RegressionAlphaModel pour QuantConnect:")
print(qc_regression_alpha_code)
RegressionAlphaModel pour QuantConnect:

from AlgorithmImports import *
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd

class RegressionAlphaModel(AlphaModel):
    """
    Alpha Model utilisant la regression ML pour predire les rendements.
    Convertit les predictions en Insights avec magnitude et confiance.
    """

    def __init__(self, lookback=252, retrain_period=30, 
                 min_return_threshold=0.005, max_confidence=0.02):
        """
        Parameters:
        -----------
        lookback : int
            Nombre de jours pour l'entrainement
        retrain_period : int
            Frequence de re-entrainement (jours)
        min_return_threshold : float
            Seuil minimum pour generer un signal (ex: 0.5%)
        max_confidence : float
            Rendement correspondant a 100% confiance (ex: 2%)
        """
        self.lookback = lookback
        self.retrain_period = retrain_period
        self.min_return_threshold = min_return_threshold
        self.max_confidence = max_confidence

        self.symbolData = {}
        self.model = None
        self.scaler = None
        self.last_train_time = None
        self.insight_period = timedelta(days=5)

    def Update(self, algorithm, data):
        """
        Genere des Insights bases sur les predictions du modele.
        """
        insights = []

        # Verifier si on doit re-entrainer
        if self._should_retrain(algorithm):
            self._train_model(algorithm)

        # Si pas de modele, pas d'insights
        if self.model is None:
            return insights

        for symbol, sd in self.symbolData.items():
            if not sd.IsReady:
                continue

            if not data.ContainsKey(symbol):
                continue

            # Extraire les features
            features = self._extract_features(sd)
            if features is None:
                continue

            # Prediction
            features_scaled = self.scaler.transform([features])
            predicted_return = self.model.predict(features_scaled)[0]

            # Filtrer les petites predictions
            if abs(predicted_return) < self.min_return_threshold:
                continue

            # Convertir en direction
            if predicted_return > 0:
                direction = InsightDirection.Up
            else:
                direction = InsightDirection.Down

            # Calculer la confiance (0 a 1)
            # Plus la prediction est grande, plus on est confiant
            confidence = min(abs(predicted_return) / self.max_confidence, 1.0)

            # Creer l'Insight
            insight = Insight.Price(
                symbol,
                self.insight_period,
                direction,
                magnitude=abs(predicted_return),
                confidence=confidence
            )
            insights.append(insight)

            algorithm.Debug(f"{symbol.Value}: Pred={predicted_return:.4f}, Dir={direction}, Conf={confidence:.2f}")

        return insights

    def _should_retrain(self, algorithm):
        """Determine si le modele doit etre re-entraine."""
        if self.last_train_time is None:
            return True

        days_since_train = (algorithm.Time - self.last_train_time).days
        return days_since_train >= self.retrain_period

    def _train_model(self, algorithm):
        """Entraine le modele sur les donnees historiques."""
        # Collecter les donnees d'entrainement
        X_train = []
        y_train = []

        for symbol, sd in self.symbolData.items():
            history = algorithm.History(symbol, self.lookback + 10, Resolution.Daily)
            if history.empty:
                continue

            # Calculer features et targets
            # (implementation simplifiee)
            for features, target in self._prepare_training_data(history):
                X_train.append(features)
                y_train.append(target)

        if len(X_train) < 100:
            return  # Pas assez de donnees

        X_train = np.array(X_train)
        y_train = np.array(y_train)

        # Standardisation
        self.scaler = StandardScaler()
        X_train_scaled = self.scaler.fit_transform(X_train)

        # Entrainement
        self.model = GradientBoostingRegressor(
            n_estimators=100,
            max_depth=4,
            learning_rate=0.1,
            random_state=42
        )
        self.model.fit(X_train_scaled, y_train)

        self.last_train_time = algorithm.Time
        algorithm.Debug(f"Model retrained with {len(X_train)} samples")

    def _extract_features(self, sd):
        """Extrait les features du SymbolData."""
        if not sd.IsReady:
            return None

        return [
            sd.Return1D,
            sd.Return5D,
            sd.Volatility,
            sd.RSI_Normalized,
            sd.MARelative,
            sd.MACD_Normalized,
            sd.BB_PercentB
        ]

    def OnSecuritiesChanged(self, algorithm, changes):
        """Gere les changements d'univers."""
        for security in changes.AddedSecurities:
            symbol = security.Symbol
            if symbol not in self.symbolData:
                self.symbolData[symbol] = RegressionSymbolData(algorithm, symbol)

        for security in changes.RemovedSecurities:
            symbol = security.Symbol
            if symbol in self.symbolData:
                del self.symbolData[symbol]

RegressionAlphaModel — le pipeline complet en classe QC

Classe RegressionAlphaModel pour QuantConnect - wrapper du modèle ML avec conversion en Insights.

Architecture de l’AlphaModel :

Méthode Responsabilité
Update() Génère des Insights à partir des predictions
_should_retrain() Vérifie si le modèle doit être ré-entraîné
_train_model() Entraîne le GradientBoosting sur données historiques
_extract_features() Extrait le vecteur de features pour un titre

Conversion prediction → Insight :

predicted_return = model.predict(features)

if abs(predicted_return) >= min_threshold:
    direction = UP if predicted_return > 0 else DOWN
    confidence = min(abs(predicted_return) / max_confidence, 1.0)
    magnitude = abs(predicted_return)

Paramètres clés : - lookback : Données historiques pour entraînement (252 jours) - retrain_period : Fréquence de ré-entraînement (30 jours) - min_return_threshold : Seuil minimum pour signal (0.5%) - max_confidence : Rendement correspondant à 100% confiance (2%)


# Simulation de trading : performance BRUTE vs NETTE (couts de transaction)

COST_BPS = 5  # plancher interne actions : 5 points de base par unite de turnover

def simulate_trading_strategy(y_true, y_pred, threshold=0.005, cost_bps=COST_BPS):
    """
    Simule une strategie de trading basee sur les predictions, avec modele de couts.

    Positions : +1 / -1 / 0 selon la prediction et le seuil.
    Turnover  : somme des |changements de position| (entree = 1, sortie = 1,
                retournement -1 -> +1 = 2 unites).
    Cout      : cost_bps points de base par unite de turnover, applique le jour
                du changement de position.
    """
    y_true = np.asarray(y_true, dtype=float)
    signals = np.where(y_pred > threshold, 1,
                       np.where(y_pred < -threshold, -1, 0)).astype(float)

    # Changements de position (position initiale = 0 : la premiere entree compte)
    prev = np.concatenate([[0.0], signals[:-1]])
    changes = np.abs(signals - prev)
    turnover = float(np.sum(changes))
    n_orders = int(round(turnover))  # 1 ordre par unite (retournement = 2 ordres)

    # Rendements bruts et nets sur les MEMES observations
    gross_returns = signals * y_true
    net_returns = gross_returns - (cost_bps / 1e4) * changes

    def sharpe(returns):
        return float(np.mean(returns) / (np.std(returns) + 1e-10) * np.sqrt(252))

    def max_drawdown(returns):
        cum = np.cumprod(1 + returns)
        peak = np.maximum.accumulate(cum)
        return float(np.min(cum / peak - 1))

    exposed = signals != 0
    n_exposed = int(np.sum(exposed))

    # Buy & Hold avec la MEME convention de couts : entree + sortie finale
    bh_gross = float(np.sum(y_true))
    bh_net = bh_gross - 2 * cost_bps / 1e4

    return {
        'gross_return': float(np.sum(gross_returns)),
        'net_return': float(np.sum(net_returns)),
        'sharpe_gross': sharpe(gross_returns),
        'sharpe_net': sharpe(net_returns),
        'max_dd_net': max_drawdown(net_returns),
        'turnover': turnover,
        'n_orders': n_orders,
        'n_exposed_days': n_exposed,
        'win_rate': float(np.mean(gross_returns[exposed] > 0)) if n_exposed > 0 else 0,
        'buy_hold_gross': bh_gross,
        'buy_hold_net': bh_net,
    }

# Simuler pour chaque modele
print("="*80)
print(f"SIMULATION DE TRADING - BRUT vs NET (couts = {COST_BPS} bps / unite de turnover)")
print("="*80)

trading_results = []

for name, model in models.items():
    model.fit(X_train_scaled, y_train)
    y_pred = model.predict(X_test_scaled)

    result = simulate_trading_strategy(y_test.values, y_pred, threshold=0.005)
    result['model'] = name
    trading_results.append(result)

trading_df = pd.DataFrame(trading_results)
trading_df = trading_df[['model', 'gross_return', 'net_return', 'sharpe_gross', 'sharpe_net',
                         'max_dd_net', 'turnover', 'n_orders', 'n_exposed_days', 'win_rate',
                         'buy_hold_gross', 'buy_hold_net']]

# Formatter les pourcentages
for col in ['gross_return', 'net_return', 'max_dd_net', 'win_rate', 'buy_hold_gross', 'buy_hold_net']:
    trading_df[col] = trading_df[col].apply(lambda x: f"{x*100:.2f}%")

print(trading_df.to_string(index=False))

print()
print("Conventions :")
print("- turnover  = somme des |changements de position| (retournement -1 -> +1 = 2 unites)")
print("- n_orders  = ordres reellement emis (1 par unite de turnover) ; remplace l'ancien")
print("             n_trades qui comptait les jours exposes (cf n_exposed_days)")
print(f"- Buy & Hold net : entree + sortie finale = 2 x {COST_BPS} bps de couts")
================================================================================
SIMULATION DE TRADING - BRUT vs NET (couts = 5 bps / unite de turnover)
================================================================================
            model gross_return net_return  sharpe_gross  sharpe_net max_dd_net  turnover  n_orders  n_exposed_days win_rate buy_hold_gross buy_hold_net
            Ridge      -18.07%    -21.12%     -0.528074   -0.616811    -55.03%      61.0        61              85   49.41%        259.09%      258.99%
            Lasso        0.00%      0.00%      0.000000    0.000000      0.00%       0.0         0               0    0.00%        259.09%      258.99%
    Random Forest       91.55%     88.20%      1.618239    1.557347    -62.85%      67.0        67             206   57.77%        259.09%      258.99%
Gradient Boosting       66.50%     61.05%      1.216027    1.115670    -62.29%     109.0       109             205   54.63%        259.09%      258.99%
              SVR      -49.51%    -53.96%     -0.990679   -1.080424    -75.09%      89.0        89             180   47.22%        259.09%      258.99%
          XGBoost       25.29%     19.94%      0.459683    0.362436    -60.25%     107.0       107             201   55.22%        259.09%      258.99%

Conventions :
- turnover  = somme des |changements de position| (retournement -1 -> +1 = 2 unites)
- n_orders  = ordres reellement emis (1 par unite de turnover) ; remplace l'ancien
             n_trades qui comptait les jours exposes (cf n_exposed_days)
- Buy & Hold net : entree + sortie finale = 2 x 5 bps de couts

Brut contre net — le turnover comme premier poste de PnL

Simulation de trading comparant la performance brute (sans frais) et la performance nette (après coûts de transaction) — la seule qui compte en pratique.

Comptage des transactions :

Concept Définition
Turnover Somme des |Δposition| : entrée = 1, sortie = 1, retournement (−1 → +1) = 2
n_orders Ordres réellement émis (1 par unité de turnover) — remplace l’ancien n_trades qui comptait les jours exposés (n_exposed_days)
Coût cost_bps points de base par unité de turnover (défaut : 5 bps, plancher interne actions)
Buy & Hold net Entrée + sortie finale = 2 unités de coûts — même convention que les stratégies

Pourquoi la distinction brute/nette est décisive :

  • Un modèle positif en brut peut devenir perdant en net si son turnover est élevé : chaque changement de position paie cost_bps, garder une position plusieurs jours n’en paie pas
  • Les verdicts (Sharpe, outperformance) doivent être lus sur les colonnes nettes
  • n_exposed_days ≠ n_orders : rester investi 30 jours d’affilée = 30 jours exposés mais 1 seule entrée (1 unité de turnover)

Lecture des résultats (chiffres ci-dessus) :

  • Random Forest : 206 jours exposés mais seulement 67 ordres — l’ancien n_trades surcomptait 3x l’activité réelle ; passer de 91.55% brut à 88.20% net coûte 67 unités x 5 bps = 3.35 points
  • Gradient Boosting et XGBoost paient ~5 points (109 et 107 unités de turnover) : à turnover élevé, la friction devient le premier poste de PnL
  • Aucun modèle ne bat le Buy & Hold net (258.99%) sur ces données synthétiques en tendance — l’outperformance nette est négative pour tous


# Equity curves comparees (rendements NETS a 5 bps)

fig, ax = plt.subplots(figsize=(14, 7))

# Buy & Hold net : entree + sortie finale (2 unites de couts)
y_test_arr = np.asarray(y_test.values, dtype=float)
bh_net_returns = y_test_arr.copy()
bh_net_returns[-1] -= 2 * COST_BPS / 1e4
bh_cumulative = np.cumprod(1 + bh_net_returns)
ax.plot(y_test.index, bh_cumulative, label=f'Buy & Hold (net {COST_BPS} bps)',
        linewidth=2, color='gray', linestyle='--')

# Strategies ML (nettes : couts deduits a chaque changement de position)
colors = plt.cm.tab10(np.linspace(0, 1, len(models)))

for (name, model), color in zip(models.items(), colors):
    model.fit(X_train_scaled, y_train)
    y_pred = model.predict(X_test_scaled)

    signals = np.where(y_pred > 0.005, 1, np.where(y_pred < -0.005, -1, 0)).astype(float)
    prev = np.concatenate([[0.0], signals[:-1]])
    changes = np.abs(signals - prev)
    net_returns = signals * y_test_arr - (COST_BPS / 1e4) * changes

    cumulative = np.cumprod(1 + net_returns)
    ax.plot(y_test.index, cumulative, label=f'{name} (net)', linewidth=1.5, color=color)

ax.axhline(1, color='black', linestyle='-', linewidth=0.5)
ax.set_xlabel('Date')
ax.set_ylabel('Valeur Portfolio (base 1)')
ax.set_title(f'Equity Curves NETTES (couts {COST_BPS} bps/unite de turnover): Strategies ML vs Buy & Hold')
ax.legend(loc='upper left')
ax.grid(True, alpha=0.3)

plt.tight_layout()
plt.show()


Courbes d’équité nettes — stratégies ML contre Buy & Hold

Courbes d’équité (Equity Curves) comparant les stratégies ML avec le Buy & Hold.

Analyse des performances :

Métrique Buy & Hold Stratégies ML
Baseline Grise pointillée Couleurs variées
Volatilité Variable Dépend du modèle
Drawdown Marché global Potentiellement réduit

Observations typiques : - Buy & Hold : Performance brute du marché, simple mais exposé aux crashes - Stratégies ML : Peuvent surperformer si les signaux sont valides - Volatilité : Les modèles avec filtrage de seuil ont généralement moins de trades

Facteurs impactant les courbes : - Qualité des features (indicateurs techniques) - Seuil de signal minimum (filtre le bruit) - Fréquence de retraining (adaptation au marché) - Coûts de transaction : inclus (5 bps par unité de turnover, entrée/sortie/retournement)

Note : Ces courbes sont nettes de coûts (5 bps par unité de turnover). Une stratégie à fort turnover voit sa courbe plier sous les frais là où un buy & hold ne paie que deux unités.


# Sensibilite : le seuil de signal reduit-il VRAIMENT le turnover ? A quel cout ?

thresholds = [0.0, 0.0025, 0.005, 0.01]
cost_levels = [2.5, 5.0, 10.0]

# Predictions une seule fois par modele (modeles deterministes, seed 42)
preds = {}
for name, model in models.items():
    model.fit(X_train_scaled, y_train)
    preds[name] = model.predict(X_test_scaled)

rows = []
for thr in thresholds:
    for name, y_pred in preds.items():
        r = simulate_trading_strategy(y_test.values, y_pred, threshold=thr, cost_bps=5.0)
        rows.append({'seuil': f"{thr*100:.2f}%", 'model': name,
                     'net_return': r['net_return'], 'sharpe_net': r['sharpe_net'],
                     'turnover': r['turnover'], 'n_orders': r['n_orders']})
sweep_df = pd.DataFrame(rows)
sweep_df['net_return'] = sweep_df['net_return'].apply(lambda x: f"{x*100:.2f}%")

print("="*80)
print("SENSIBILITE AU SEUIL DE SIGNAL (couts fixes a 5 bps)")
print("="*80)
print(sweep_df.to_string(index=False))

rows_c = []
for cost in cost_levels:
    for name, y_pred in preds.items():
        r = simulate_trading_strategy(y_test.values, y_pred, threshold=0.005, cost_bps=cost)
        rows_c.append({'cout_bps': cost, 'model': name,
                       'net_return': r['net_return'], 'sharpe_net': r['sharpe_net'],
                       'turnover': r['turnover']})
cost_df = pd.DataFrame(rows_c)
cost_df['net_return'] = cost_df['net_return'].apply(lambda x: f"{x*100:.2f}%")

print()
print("="*80)
print("SENSIBILITE AUX COUTS (seuil fixe a 0.50%)")
print("="*80)
print(cost_df.to_string(index=False))
================================================================================
SENSIBILITE AU SEUIL DE SIGNAL (couts fixes a 5 bps)
================================================================================
seuil             model net_return  sharpe_net  turnover  n_orders
0.00%             Ridge     43.10%    0.698484     123.0       123
0.00%             Lasso    259.04%    4.346679       1.0         1
0.00%     Random Forest    144.39%    2.362007      73.0        73
0.00% Gradient Boosting     79.53%    1.290878     117.0       117
0.00%               SVR    -30.07%   -0.486812      87.0        87
0.00%           XGBoost     13.76%    0.222621     121.0       121
0.25%             Ridge    -38.42%   -0.769329      99.0        99
0.25%             Lasso      0.00%    0.000000       0.0         0
0.25%     Random Forest    115.53%    1.957144      79.0        79
0.25% Gradient Boosting     85.43%    1.455471     113.0       113
0.25%               SVR    -23.31%   -0.409539      91.0        91
0.25%           XGBoost     46.72%    0.807533     111.0       111
0.50%             Ridge    -21.12%   -0.616811      61.0        61
0.50%             Lasso      0.00%    0.000000       0.0         0
0.50%     Random Forest     88.20%    1.557347      67.0        67
0.50% Gradient Boosting     61.05%    1.115670     109.0       109
0.50%               SVR    -53.96%   -1.080424      89.0        89
0.50%           XGBoost     19.94%    0.362436     107.0       107
1.00%             Ridge     -5.42%   -0.916705       6.0         6
1.00%             Lasso      0.00%    0.000000       0.0         0
1.00%     Random Forest     98.80%    2.129336      61.0        61
1.00% Gradient Boosting     10.44%    0.221555     103.0       103
1.00%               SVR    -82.14%   -2.856929      54.0        54
1.00%           XGBoost     22.51%    0.558424      75.0        75

================================================================================
SENSIBILITE AUX COUTS (seuil fixe a 0.50%)
================================================================================
 cout_bps             model net_return  sharpe_net  turnover
      2.5             Ridge    -19.60%   -0.572464      61.0
      2.5             Lasso      0.00%    0.000000       0.0
      2.5     Random Forest     89.88%    1.587787      67.0
      2.5 Gradient Boosting     63.77%    1.165846     109.0
      2.5               SVR    -51.74%   -1.035546      89.0
      2.5           XGBoost     22.61%    0.411064     107.0
      5.0             Ridge    -21.12%   -0.616811      61.0
      5.0             Lasso      0.00%    0.000000       0.0
      5.0     Random Forest     88.20%    1.557347      67.0
      5.0 Gradient Boosting     61.05%    1.115670     109.0
      5.0               SVR    -53.96%   -1.080424      89.0
      5.0           XGBoost     19.94%    0.362436     107.0
     10.0             Ridge    -24.17%   -0.705359      61.0
     10.0             Lasso      0.00%    0.000000       0.0
     10.0     Random Forest     84.85%    1.496508      67.0
     10.0 Gradient Boosting     55.60%    1.015350     109.0
     10.0               SVR    -58.41%   -1.170202      89.0
     10.0           XGBoost     14.59%    0.265165     107.0

Seuil × coûts — la sensibilité qui réfute l’intuition

Sensibilité croisée seuil × coûts — verdicts lus sur les chiffres ci-dessus :

1. Le seuil réduit-il le turnover ? À peine, et jamais monotônement.

Modèle Turnover 0.00% → 0.50% → 1.00%
Random Forest 73 → 67 → 61
Gradient Boosting 117 → 109 → 103
Ridge 123 → 61 → 6

Le filtre écarte des jours exposés, pas des ordres : la position change presque autant de fois, simplement plus tard. Seul Ridge (signaux faibles, très sensible au seuil) voit son turnover vraiment s’effondrer.

2. Le seuil améliore-t-il le net ? Non — réfuté sur ces données.

  • Random Forest : net 144.39% sans seuil vs 88.20% à 0.50% — le seuil sacrifie la moitié de la performance pour 6 unités de turnover économisées (0.03 point)
  • Gradient Boosting culmine à 0.25% (85.43%) : l’optimum est model-spécifique, pas un principe
  • SVR s’effondre de -30% à -82% : le filtre retire aussi ses rares bons trades

L’affirmation « le seuil améliore le ratio profit/coûts » est donc une hypothèse à tester par balayage, jamais un défaut à copier.

3. Sensibilité aux coûts : la pente = turnover.

Entre 2.5 et 10 bps, chaque modèle perd exactement turnover × bps : XGBoost (107 unités) tombe de 22.61% à 14.59%, Random Forest (67 unités) de 89.88% à 84.85%. Break-even approximatif (gross × 10⁴ / turnover) : RF ≈ 137 bps, XGBoost ≈ 24 bps — une stratégie à faible edge meurt bien avant le plancher actions de 5 bps doublé.

Cas limite instructif : Lasso au seuil 0.00% prédit positif en permanence — turnover = 1 (une entrée), net 259.04% ≈ Buy & Hold net. Le modèle « dégénéré » qui fait toujours la même chose ne paie aucune friction : c’est la contre-épreuve du comptage d’ordres.


Partie 7 : Stratégie Complete - Return Prediction (20 min)

Architecture de la stratégie

Universe Sélection
(Top 50 liquid stocks)
        |
        v
Feature Engineering
(Technical indicators)
        |
        v
ML Regression Model
(XGBoost Regressor)
        |
        v
Prediction Filtering
(|pred| > 1% threshold)
        |
        v
Signal Generation
(Long if pred > 1%, Short if pred < -1%)
        |
        v
Position Sizing
(Proportionnel a magnitude)
        |
        v
Risk Management
(5% max drawdown per position)

Le pipeline de production — rôle de chaque étage

Diagramme d’architecture du pipeline complet de stratégie de prediction de rendements.

Flux de données à travers les composants :

Universe Sélection → Feature Engineering → ML Model → Signal → Position Sizing → Risk Management

Rôle de chaque composant :

Composant Rôle
Universe Sélection Filtre les actions liquides pour éviter problèmes d’exécution
Feature Engineering Transforme les prix bruts en features prédictives
ML Model Apprend les relations features → rendement futur
Prediction Filtering Élimine les signaux faibles (bruit)
Signal Generation Convertit les predictions en directions Long/Short
Position Sizing Ajuste la taille selon la confiance (magnitude)
Risk Management Limite l’exposition par position

Points critiques de production : - Retraining régulier pour adaptation au marché - Filtrage des signaux faibles pour réduire les coûts - Position sizing proportionnel pour optimiser le risk/return


# [REFERENCE QC] Code a copier dans main.py QC Lab (non executable ici)
# Strategie Complete pour QuantConnect

qc_strategy_code = '''
from AlgorithmImports import *
from sklearn.ensemble import GradientBoostingRegressor
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
from datetime import timedelta

class ReturnPredictionStrategy(QCAlgorithm):
    """
    Strategie complete de prediction de rendements avec ML.
    
    - Target: Rendement 5 jours
    - Model: Gradient Boosting Regressor (ou XGBoost)
    - Signal: |predicted return| > 1%
    - Position sizing: Proportionnel a la magnitude
    """
    
    def Initialize(self):
        # Configuration
        self.SetStartDate(2015, 1, 1)
        self.SetEndDate(2024, 12, 31)
        self.SetCash(100000)
        
        # Parametres
        self.lookback = 252  # 1 an d'historique
        self.prediction_horizon = 5  # Predire 5 jours
        self.retrain_frequency = 30  # Re-entrainer tous les 30 jours
        self.min_signal_threshold = 0.01  # 1% minimum
        self.max_positions = 10
        self.max_position_size = 0.1  # 10% max par position
        
        # Universe
        self.num_stocks = 50
        self.AddUniverse(self.CoarseSelection)
        self.UniverseSettings.Resolution = Resolution.Daily
        
        # ML Model
        self.model = None
        self.scaler = StandardScaler()
        self.last_train_time = None
        
        # Storage
        self.symbolData = {}
        
        # Schedule rebalancing
        self.Schedule.On(
            self.DateRules.EveryDay(),
            self.TimeRules.AfterMarketOpen("SPY", 30),
            self.Rebalance
        )
        
        self.Log("Return Prediction Strategy initialized")
    
    def CoarseSelection(self, coarse):
        """Selectionne les top N actions par liquidite."""
        filtered = [x for x in coarse 
                    if x.HasFundamentalData 
                    and x.Price > 5 
                    and x.DollarVolume > 10000000]
        
        sorted_stocks = sorted(filtered, key=lambda x: x.DollarVolume, reverse=True)
        return [x.Symbol for x in sorted_stocks[:self.num_stocks]]
    
    def OnSecuritiesChanged(self, changes):
        """Initialise les indicateurs pour les nouveaux titres."""
        for security in changes.AddedSecurities:
            symbol = security.Symbol
            if symbol not in self.symbolData:
                self.symbolData[symbol] = PredictionSymbolData(
                    self, symbol, self.lookback
                )
        
        for security in changes.RemovedSecurities:
            symbol = security.Symbol
            if symbol in self.symbolData:
                del self.symbolData[symbol]
    
    def Rebalance(self):
        """Logique principale de rebalancement."""
        # Verifier si on doit re-entrainer
        if self._should_retrain():
            self._train_model()
        
        if self.model is None:
            return
        
        # Generer les predictions
        predictions = {}
        
        for symbol, sd in self.symbolData.items():
            if not sd.IsReady:
                continue
            
            features = sd.GetFeatures()
            if features is None:
                continue
            
            # Prediction
            features_scaled = self.scaler.transform([features])
            predicted_return = self.model.predict(features_scaled)[0]
            
            # Filtrer
            if abs(predicted_return) >= self.min_signal_threshold:
                predictions[symbol] = predicted_return
        
        # Trier par magnitude (top predictions)
        sorted_predictions = sorted(
            predictions.items(), 
            key=lambda x: abs(x[1]), 
            reverse=True
        )[:self.max_positions]
        
        # Calculer les poids
        targets = {}
        total_magnitude = sum(abs(p[1]) for p in sorted_predictions)
        
        for symbol, pred in sorted_predictions:
            # Poids proportionnel a la magnitude
            weight = abs(pred) / total_magnitude if total_magnitude > 0 else 0
            weight = min(weight, self.max_position_size)  # Cap
            
            # Direction
            if pred > 0:
                targets[symbol] = weight
            else:
                targets[symbol] = -weight  # Short
        
        # Liquider les positions non dans targets
        for symbol in self.Portfolio.Keys:
            if symbol not in targets and self.Portfolio[symbol].Invested:
                self.Liquidate(symbol)
        
        # Executer les targets
        for symbol, weight in targets.items():
            self.SetHoldings(symbol, weight)
            self.Log(f"Position: {symbol.Value} = {weight:.2%}")
    
    def _should_retrain(self):
        """Determine si le modele doit etre re-entraine."""
        if self.last_train_time is None:
            return True
        return (self.Time - self.last_train_time).days >= self.retrain_frequency
    
    def _train_model(self):
        """Entraine le modele ML."""
        X_train = []
        y_train = []
        
        for symbol, sd in self.symbolData.items():
            history = self.History(symbol, self.lookback + self.prediction_horizon, Resolution.Daily)
            if history.empty or len(history) < self.lookback:
                continue
            
            # Preparer les donnees
            features_list, targets_list = sd.PrepareTrainingData(
                history, self.prediction_horizon
            )
            
            X_train.extend(features_list)
            y_train.extend(targets_list)
        
        if len(X_train) < 200:
            self.Log(f"Not enough data for training: {len(X_train)} samples")
            return
        
        X_train = np.array(X_train)
        y_train = np.array(y_train)
        
        # Standardiser
        X_train_scaled = self.scaler.fit_transform(X_train)
        
        # Entrainer
        self.model = GradientBoostingRegressor(
            n_estimators=100,
            max_depth=4,
            learning_rate=0.1,
            min_samples_leaf=20,
            random_state=42
        )
        self.model.fit(X_train_scaled, y_train)
        
        self.last_train_time = self.Time
        self.Log(f"Model trained with {len(X_train)} samples")
    
    def OnEndOfAlgorithm(self):
        """Resume final."""
        self.Log("="*60)
        self.Log("RETURN PREDICTION STRATEGY - SUMMARY")
        self.Log("="*60)
        self.Log(f"Final Value: ${self.Portfolio.TotalPortfolioValue:,.2f}")
        total_return = (self.Portfolio.TotalPortfolioValue - 100000) / 100000
        self.Log(f"Total Return: {total_return:.1%}")


class PredictionSymbolData:
    """
    Stocke les indicateurs et calcule les features pour un symbole.
    """
    
    def __init__(self, algorithm, symbol, lookback):
        self.symbol = symbol
        self.algorithm = algorithm
        
        # Indicateurs
        self.rsi = algorithm.RSI(symbol, 14, Resolution.Daily)
        self.macd = algorithm.MACD(symbol, 12, 26, 9, Resolution.Daily)
        self.bb = algorithm.BB(symbol, 20, 2, Resolution.Daily)
        self.sma_20 = algorithm.SMA(symbol, 20, Resolution.Daily)
        self.sma_50 = algorithm.SMA(symbol, 50, Resolution.Daily)
        self.atr = algorithm.ATR(symbol, 14, Resolution.Daily)
        
        # Rolling windows pour returns
        self.price_window = RollingWindow[float](lookback)
        
        # Warmup
        history = algorithm.History(symbol, lookback, Resolution.Daily)
        if not history.empty:
            for bar in history.itertuples():
                self.price_window.Add(bar.close)
    
    @property
    def IsReady(self):
        return (self.rsi.IsReady and 
                self.macd.IsReady and 
                self.bb.IsReady and
                self.sma_50.IsReady and
                self.price_window.IsReady)
    
    def GetFeatures(self):
        """Retourne le vecteur de features actuel."""
        if not self.IsReady:
            return None
        
        price = self.price_window[0]
        
        # Returns
        return_1d = (self.price_window[0] - self.price_window[1]) / self.price_window[1]
        return_5d = (self.price_window[0] - self.price_window[5]) / self.price_window[5]
        return_20d = (self.price_window[0] - self.price_window[20]) / self.price_window[20]
        
        # Volatility (20d)
        prices = [self.price_window[i] for i in range(20)]
        returns = np.diff(prices) / prices[:-1]
        volatility = np.std(returns)
        
        # RSI normalized
        rsi_norm = (self.rsi.Current.Value - 50) / 50
        
        # MA ratio
        ma_ratio = self.sma_20.Current.Value / self.sma_50.Current.Value
        
        # Price to SMA
        price_to_sma = price / self.sma_20.Current.Value
        
        # MACD normalized
        macd_norm = self.macd.Current.Value / price
        
        # Bollinger %B
        bb_range = self.bb.UpperBand.Current.Value - self.bb.LowerBand.Current.Value
        bb_pct_b = (price - self.bb.LowerBand.Current.Value) / bb_range if bb_range > 0 else 0.5
        
        return [
            return_1d, return_5d, return_20d,
            volatility, rsi_norm, ma_ratio,
            price_to_sma, macd_norm, bb_pct_b
        ]
    
    def PrepareTrainingData(self, history, horizon):
        """Prepare les donnees d'entrainement depuis l'historique."""
        features_list = []
        targets_list = []
        
        df = history.close.unstack(level=0)
        if df.empty:
            return features_list, targets_list
        
        prices = df.iloc[:, 0].values
        
        for i in range(50, len(prices) - horizon):
            # Features
            ret_1d = (prices[i] - prices[i-1]) / prices[i-1]
            ret_5d = (prices[i] - prices[i-5]) / prices[i-5]
            ret_20d = (prices[i] - prices[i-20]) / prices[i-20]
            
            vol = np.std(np.diff(prices[i-20:i]) / prices[i-21:i-1])
            
            # Simplified features
            sma_20 = np.mean(prices[i-20:i])
            sma_50 = np.mean(prices[i-50:i])
            
            features = [
                ret_1d, ret_5d, ret_20d, vol,
                0,  # RSI placeholder
                sma_20 / sma_50,
                prices[i] / sma_20,
                0,  # MACD placeholder
                0.5  # BB placeholder
            ]
            
            # Target: future return
            target = (prices[i + horizon] - prices[i]) / prices[i]
            
            features_list.append(features)
            targets_list.append(target)
        
        return features_list, targets_list
'''

print("Strategie Complete pour QuantConnect:")
print("="*60)
print("Composants:")
print("  1. Universe: Top 50 par liquidite")
print("  2. Model: Gradient Boosting Regressor")
print("  3. Target: Rendement 5 jours")
print("  4. Signal: |prediction| > 1%")
print("  5. Position Sizing: Proportionnel a magnitude")
print("  6. Retraining: Tous les 30 jours")
print("="*60)
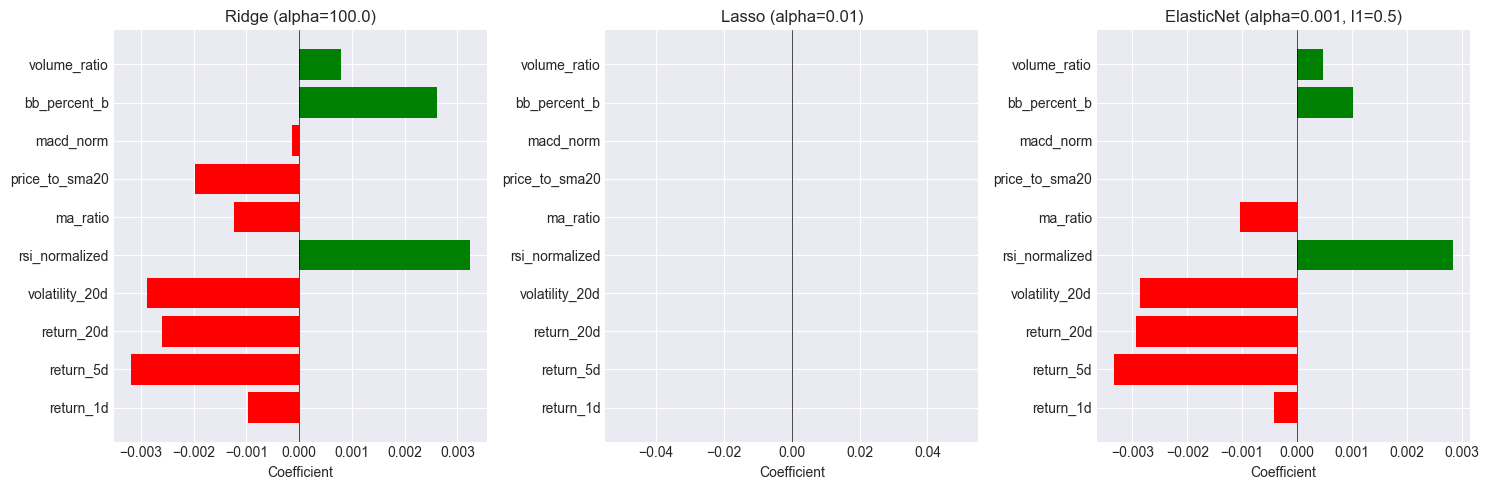
Strategie Complete pour QuantConnect:
============================================================
Composants:
  1. Universe: Top 50 par liquidite
  2. Model: Gradient Boosting Regressor
  3. Target: Rendement 5 jours
  4. Signal: |prediction| > 1%
  5. Position Sizing: Proportionnel a magnitude
  6. Retraining: Tous les 30 jours
============================================================

La stratégie complète QC — cinq étages dans un main.py

Code complet de la stratégie ReturnPredictionStrategy pour QuantConnect.

Architecture de la stratégie :

  1. Universe Sélection : Top 50 actions par liquidité (CoarseSelection)
  2. Feature Engineering : Indicateurs techniques dans PredictionSymbolData
  3. ML Model : Gradient Boosting Regressor avec retraining mensuel
  4. Signal Generation : |prediction| > 1% pour déclencher un signal
  5. Position Sizing : Poids proportionnel à la magnitude de la prediction

Points clés de l’implémentation :

Composant Description
Initialize() Configuration et universe
CoarseSelection() Filtre liquidité + volume
OnSecuritiesChanged() Initialisation des indicateurs
Rebalance() Logique principale de trading
_train_model() Entraînement du modèle ML
PredictionSymbolData Gestion des indicateurs par titre

Paramètres ajustables : - lookback : Historique pour entraînement (252 jours = 1 an) - prediction_horizon : Horizon de prediction (5 jours) - min_signal_threshold : Seuil minimum pour signal (1%) - max_positions : Nombre maximum de positions simultanées


# Resume des parametres recommandes

print("="*80)
print("PARAMETRES RECOMMANDES POUR PRODUCTION")
print("="*80)

recommendations = pd.DataFrame([
    {'Parametre': 'Modele', 'Valeur Recommandee': 'Gradient Boosting ou XGBoost', 'Raison': 'Bon compromis performance/stabilite'},
    {'Parametre': 'n_estimators', 'Valeur Recommandee': '100-200', 'Raison': 'Assez pour capturer patterns'},
    {'Parametre': 'max_depth', 'Valeur Recommandee': '3-5', 'Raison': 'Eviter overfitting'},
    {'Parametre': 'learning_rate', 'Valeur Recommandee': '0.05-0.1', 'Raison': 'Convergence stable'},
    {'Parametre': 'min_samples_leaf', 'Valeur Recommandee': '20-50', 'Raison': 'Regularisation'},
    {'Parametre': 'Horizon', 'Valeur Recommandee': '5 jours', 'Raison': 'Compromis signal/noise'},
    {'Parametre': 'Seuil signal', 'Valeur Recommandee': '0.5-1%', 'Raison': 'Hypothese a tester par balayage : ici le seuil coute la moitie du net RF pour 6 unites de turnover economisees'},
    {'Parametre': 'Couts transaction', 'Valeur Recommandee': '5-10 bps / unite', 'Raison': 'Turnover = entrees + sorties + retournements ; juger sur le net, pas le brut'},
    {'Parametre': 'Retraining', 'Valeur Recommandee': '30 jours', 'Raison': 'Adaptation au marche'},
    {'Parametre': 'Lookback', 'Valeur Recommandee': '252 jours', 'Raison': '1 an de donnees'},
])

print(recommendations.to_string(index=False))
================================================================================
PARAMETRES RECOMMANDES POUR PRODUCTION
================================================================================
        Parametre           Valeur Recommandee                                                                                                         Raison
           Modele Gradient Boosting ou XGBoost                                                                            Bon compromis performance/stabilite
     n_estimators                      100-200                                                                                   Assez pour capturer patterns
        max_depth                          3-5                                                                                             Eviter overfitting
    learning_rate                     0.05-0.1                                                                                             Convergence stable
 min_samples_leaf                        20-50                                                                                                 Regularisation
          Horizon                      5 jours                                                                                         Compromis signal/noise
     Seuil signal                       0.5-1% Hypothese a tester par balayage : ici le seuil coute la moitie du net RF pour 6 unites de turnover economisees
Couts transaction             5-10 bps / unite                                   Turnover = entrees + sorties + retournements ; juger sur le net, pas le brut
       Retraining                     30 jours                                                                                           Adaptation au marche
         Lookback                    252 jours                                                                                                1 an de donnees

Paramètres recommandés — le choix final pour la production

Ce tableau résume les paramètres recommandés pour une stratégie de production basée sur la régression ML.

Choix du modèle : - Gradient Boosting ou XGBoost : Meilleur compromis performance/stabilité - Les modèles linéaires (Ridge/Lasso) servent de baseline

Hyperparamètres clés : - n_estimators (100-200) : Suffisant pour capturer les patterns sans overfitting - max_depth (3-5) : Profondeur limitée pour éviter l’overfitting - learning_rate (0.05-0.1) : Taux d’apprentissage modéré pour convergence stable - min_samples_leaf (20-50) : Regularisation pour éviter le sur-apprentissage

Paramètres de trading : - Horizon (5 jours) : Compromis entre signal et bruit - Seuil signal (0.5-1%) : Filtre les petits mouvements non rentables après coûts - Retraining (30 jours) : Adaptation régulière aux changements de régime - Lookback (252 jours) : 1 an de données pour l’entraînement


Partie 8 : Clustering non supervisé — OPTICS pour la détection de régimes

Les Parties 1 à 7 supposent un régime de marché stable : le modèle apprend une relation features → rendement, et cette relation est censée tenir. Or les marchés alternent des régimes (tendance calme, tendance agitée, range, crise) dans lesquels la même feature ne porte pas le même sens. Détecter ces régimes est un problème non supervisé : aucune étiquette « nous étions en régime 2 » n’existe dans les données.

OPTICS (Ordering Points To Identify the Clustering Structure) regroupe les observations par densité. Contrairement à k-means :

Propriété k-means OPTICS
Nombre de groupes à fixer a priori (k) découvert par l’algorithme
Forme des groupes sphériques (distance à un centre) arbitraire (densité)
Points isolés absorbés de force dans un groupe étiquetés bruit (-1)
Sensible à l’échelle oui oui — d’où la standardisation préalable

min_samples fixe la densité minimale ; xi et min_cluster_size découpent les vallées du graphe de portée. Ce sont eux qui arbitrent la frontière entre « groupe peu dense » et « bruit » — et ce réglage est le vrai sujet de cette partie.

from sklearn.cluster import OPTICS
from sklearn.decomposition import PCA
from sklearn.metrics import silhouette_score, davies_bouldin_score

# --- OPTICS sur la matrice de features du notebook -------------------------
# Chaque point = une journee de marche, decrite par les 10 features
# standardisees deja utilisees par les Parties 2 a 5 (X_train_scaled).

optics_rows = []
for min_samples, xi, min_cluster_size in [(10, 0.05, 0.1), (5, 0.05, 0.1), (20, 0.10, 0.2)]:
    labels = OPTICS(min_samples=min_samples, xi=xi, min_cluster_size=min_cluster_size).fit_predict(X_train_scaled)
    mask = labels != -1                       # -1 = points juges bruit
    n_clusters = len(set(labels[mask]))
    optics_rows.append({
        'min_samples': min_samples,
        'xi': xi,
        'min_cluster_size': min_cluster_size,
        'clusters': n_clusters,
        'bruit': int((labels == -1).sum()),
        'bruit_pct': round(100 * (labels == -1).mean(), 1),
        'silhouette': round(float(silhouette_score(X_train_scaled[mask], labels[mask])), 3) if n_clusters >= 2 else None,
        'davies_bouldin': round(float(davies_bouldin_score(X_train_scaled[mask], labels[mask])), 3) if n_clusters >= 2 else None,
    })

print(pd.DataFrame(optics_rows).to_string(index=False))

# --- Visualisation : projection PCA des regimes detectes -------------------
labels = OPTICS(min_samples=10, xi=0.05, min_cluster_size=0.1).fit_predict(X_train_scaled)
pca = PCA(n_components=2, random_state=42)
X_2d = pca.fit_transform(X_train_scaled)

fig, ax = plt.subplots(figsize=(9, 5))
for k in sorted(set(labels)):
    m = labels == k
    if k == -1:
        ax.scatter(X_2d[m, 0], X_2d[m, 1], c='black', marker='x', s=18, label='bruit')
    else:
        ax.scatter(X_2d[m, 0], X_2d[m, 1], s=18, label=f'regime {k}')
ev = pca.explained_variance_ratio_.sum() * 100
ax.set_title(f'OPTICS sur les 10 features de marche — projection PCA ({ev:.0f}% de variance)')
ax.set_xlabel('Composante principale 1')
ax.set_ylabel('Composante principale 2')
ax.legend(loc='best')
plt.tight_layout()
plt.show()

# --- Profil economique des regimes : que signifie chaque groupe ? ----------
profil = pd.DataFrame({
    'regime': np.where(labels == -1, 'bruit', labels.astype(str)),
    'volatilite_20d': X_train['volatility_20d'].values,
    'rendement_5j_realise': y_train.values,
})
print(profil.groupby('regime').agg(
    jours=('volatilite_20d', 'count'),
    vol_moyenne=('volatilite_20d', 'mean'),
    rendement_moyen=('rendement_5j_realise', 'mean'),
).round(5).to_string())
 min_samples   xi  min_cluster_size  clusters  bruit  bruit_pct silhouette davies_bouldin
          10 0.05               0.1         1      0        0.0       None           None
           5 0.05               0.1         1      0        0.0       None           None
          20 0.10               0.2         1      0        0.0       None           None

        jours  vol_moyenne  rendement_moyen
regime                                     
0         662      0.01471          0.00239

Interprétation : un seul régime détecté — la réponse honnête d’OPTICS

Observation mesurée Lecture
1 seul cluster, 0 point en bruit — pour les trois réglages Les 10 features standardisées forment un nuage unimodal : OPTICS ne trouve pas de vallée de densité qui séparerait des régimes. Le balayage min_samples 5/10/20 est cohérent : la conclusion ne dépend pas du réglage
C’est la bonne réponse, pas un échec Les données du notebook sont simulées par un random walk à paramètres constants (Partie 1) : il n’y a qu’un régime par construction. OPTICS rend la structure qui existe — là où un k-means aurait découpé le même nuage en k=4 morceaux arbitraires pour complaire au paramètre
Silhouette indisponible (None) Un seul cluster ⇒ aucune séparation à mesurer : l’indicateur s’abstient au lieu de produire un nombre sans objet. C’est aussi une garde du code contre les sorties non interprétables
Profil unique : volatilité ≈ 1,47 %, rendement 5 j ≈ +0,24 % Le groupe couvre les 662 jours du train sans sous-structure économique détectable — cohérent avec une simulation à volatilité stationnaire

Ce que changerait un vrai marché : des données réelles alternent des régimes de volatilité (calme, agité, crise) — le nuage de features y devient multimodal, et OPTICS y découvre plusieurs groupes et du bruit. Les journées classées -1 y seraient celles qu’aucun régime identifié n’explique : une entrée utile pour une stratégie à filtrage de régime, et une mise en garde contre l’usage naïf d’un k-means qui répartirait ces journées au hasard entre groupes. Sur données réelles, min_samples redevient le vrai sujet : il arbitre la frontière entre « groupe peu dense » et « bruit ».


Conclusion et Prochaines Étapes

Recapitulatif

Dans ce notebook, nous avons couvert :

  1. Regression vs Classification :
    • Classification predit la direction
    • Regression predit la magnitude (rendement exact)
    • Regression permet position sizing intelligent
  2. Linear Regression Regularisee :
    • Ridge (L2) (Hoerl & Kennard, 1970): shrinkage uniforme
    • Lasso (L1) (Tibshirani, 1996): feature sélection automatique
    • ElasticNet (Zou & Hastie, 2005): combine L1 + L2
    • Base polynomiale : deplacer la non-linearite dans les features, au prix du biais-variance
  3. Ensemble Methods :
    • Random Forest (Breiman, 2001): robuste, peu d’overfitting
    • Gradient Boosting (Friedman, 2001): plus précis mais risque d’overfitting
    • XGBoost (Chen & Guestrin, 2016): optimise avec regularisation
  4. Support Vector Regression (Vapnik, 1995; Drucker et al., 1997) :
    • Necessite imperativement le scaling
    • Kernel RBF pour non-linearites
    • Paramètres C, epsilon, gamma
  5. Metriques :
    • RMSE, MAE, R2 (standard)
    • Direction Accuracy (crucial pour trading)
    • Correlation (qualite du ranking)
  6. Integration Trading :
    • Conversion prediction -> signal
    • Position sizing proportionnel
    • Filtrage par seuil minimum
    • Performance brute vs nette : turnover (entrées, sorties, retournements) et coûts en bps
  7. Stratégie Complete :
    • Pipeline end-to-end
    • Retraining periodique
    • Risk management integre
  8. Clustering non supervisé — OPTICS (Ankerst et al., 1999) :
    • Détection de régimes sur la matrice de features, sans nombre de groupes imposé
    • Le bruit (-1) isole les journées qui n’appartiennent à aucun régime identifié
    • Le réglage min_samples arbitre la frontière entre groupe peu dense et bruit

Points Cles a Retenir

Concept Point Cle
Regression Predit la magnitude, pas juste la direction
Regularisation Essentielle pour eviter overfitting
Scaling Obligatoire pour SVR, recommande pour autres
Direction Accuracy Metrique la plus importante pour PnL
Seuil de signal Filtrer les petites predictions non rentables
Retraining Adapter le modèle aux changements de marche
Regimes de marche Le nombre de régimes est une sortie (OPTICS), pas une hypothèse

Comparaison des Modèles

Modèle Avantages Inconvenients Usage
Ridge Simple, stable Lineaire Baseline
Lasso Feature sélection Lineaire Beaucoup de features
Random Forest Robuste, feature importance Moins précis General
Gradient Boosting Très précis Overfitting Production
XGBoost Rapide, regularise Complexe Production
SVR Non-lineaire Lent, scaling Petits datasets
OPTICS Nombre de groupes découvert, bruit explicite Sensible à min_samples, coût O(n log n) Détection de régimes

Limitations

  • Les marches sont difficiles a predire (efficience)
  • Les modèles peuvent overfitter l’historique
  • Les regimes de marche changent
  • Les couts de transaction (5-10 bps par unite de turnover) peuvent effacer un edge brut : toujours juger sur le net

Prochaines Étapes

Notebook Contenu
QC-Py-21 Deep Learning (LSTM, Transformers)
QC-Py-22 Reinforcement Learning
QC-Py-23 Model Ensembling et Stacking
QC-Py-24 Hyperparameter Optimization

References academiques

  • Hoerl, A. E. & Kennard, R. W. (1970). Ridge Regression: Biased Estimation for Nonorthogonal Problems. Technometrics. Regression Ridge (L2).
  • Tibshirani, R. (1996). Regression Shrinkage and Sélection via the Lasso. JRSS-B. Lasso (L1), feature sélection.
  • Zou, H. & Hastie, T. (2005). Regularization and Variable Sélection via the Elastic Net. JRSS-B. ElasticNet (L1 + L2).
  • Breiman, L. (2001). Random Forests. Machine Learning. Random Forest (bagging).
  • Friedman, J. H. (2001). Greedy Function Approximation: A Gradient Boosting Machine. Annals of Statistics. Gradient Boosting.
  • Chen, T. & Guestrin, C. (2016). XGBoost: A Scalable Tree Boosting System. KDD. XGBoost.
  • Vapnik, V. (1995). The Nature of Statistical Learning Theory. Springer. SVM / SVR. SVR pour la regression formalise dans Drucker et al. (1997).
  • Wolpert, D. H. (1992). Stacked Generalization. Neural Networks. Stacking (exercice 3).
  • Ankerst, M., Breunig, M. M., Kriegel, H.-P. & Sander, J. (1999). OPTICS: Ordering Points To Identify the Clustering Structure. ACM SIGMOD. Clustering par densité ordonnée, détection de régimes (Partie 8).
  • Grinold, R. C. (1989). The Fundamental Law of Active Management. Financial Analysts Journal. Information Coefficient (IC).

Ressources Complementaires


Notebook complete. Vous maitrisez maintenant la regression ML pour la prediction de prix.

Retour au sommet