Maîtriser QuantBook pour la recherche exploratoire
Analyser des données avec pandas et matplotlib
Tester des stratégies en mode recherche (vectorized backtesting)
Transitionner du notebook vers un algorithme de production
Prérequis
Notebooks QC-Py-01, 02, 03 complétés
Connaissance de pandas et matplotlib
Compréhension du lifecycle QCAlgorithm
Structure du Notebook
Introduction au workflow de recherche
Setup QuantBook
Exploration de données avec pandas
Test de stratégie en mode recherche
Utiliser shared/features.py
Transition Notebook → Algorithm
Exemple complet: Feature Engineering pour ML
Conclusion et prochaines étapes
[REFERENCE QC Cloud] Ce notebook illustre du code QuantConnect a executer dans l’IDE Cloud (https://www.quantconnect.com/research). L’environnement local ne dispose pas de QuantBook ni de l’historical data feed. Pour executer : cloner le projet QC associe, ouvrir research.ipynb, executer cellule par cellule.
Mode d’emploi : Ce notebook est entierement executable en Jupyter local. Les donnees proviennent d’une execution QuantBook reelle (Cloud Research), dont les sorties sont commitees ; en local sans credentials QC, les cellules d’import QuantConnect ne resoudront pas – la lecture suit le flux recherche -> exploration -> strategie -> helpers -> transition algorithme -> feature engineering ML, et chaque interpretation cite les chiffres reellement produits. Le notebook est la porte d’entree de la serie Python : il etablit les gestes (QuantBook, History, pandas, backtest vectorise, helpers partages) que QC-Py-12 approfondira metrique par metrique et QC-Py-18 et suivants exploiteront pour le ML.
1. Introduction au Workflow de Recherche (5 min)
Workflow Recherche vs Backtest
QuantConnect propose deux modes de développement distincts :
Aspect
Mode Recherche (QuantBook)
Mode Backtest (QCAlgorithm)
Environment
Jupyter Notebook
Event-driven algorithm
Exécution
Synchrone, interactive
Asynchrone, simulation temporelle
API principale
QuantBook
QCAlgorithm
Lifecycle
Pas de lifecycle
Initialize → OnData → OnEndOfAlgorithm
Données
qb.History() retourne DataFrame
History() retourne Slice
Usage
Exploration, analyse, prototypage
Backtesting, optimisation, production
Visualisation
matplotlib, seaborn directement
Via Charts API
QuantBook : API de Recherche Jupyter
QuantBook est une classe spécialisée qui permet d’interagir avec l’infrastructure QuantConnect dans un environnement Jupyter synchrone :
Recherche (QuantBook) : Explorer données, tester hypothèses, visualiser
Prototypage (QuantBook) : Vectorized backtesting rapide
Implémentation (QCAlgorithm) : Traduire la logique en event-driven
Validation (Backtest) : Backtest complet avec réalisme
Production (Live Trading) : Déploiement
Note Pédagogique : QuantBook est un outil de recherche, pas un outil de backtest. Les résultats peuvent différer légèrement d’un backtest complet QCAlgorithm (pas de slippage, frais simulés, etc.). Toujours valider avec un backtest avant production.
2. Setup QuantBook (10 min)
Creer une Instance QuantBook
Commencons par importer l’API QuantConnect. Le from QuantConnect import * charge l’espace de noms complet (Securities, Data, Research, Indicators, Algorithms) – l’equivalent Jupyter du from AlgorithmImports import * des algorithmes. Dans l’IDE Cloud, ces imports sont pre-resolus ; en local, ils exigent le package quantconnect-stubs. La sortie confirmera ensuite le type exact de l’instance creee : QuantConnect.Research.QuantBook – une classe distincte de QCAlgorithm, sans lifecycle, qui vit cellule par cellule.
# Imports QuantConnectfrom QuantConnect import*from QuantConnect.Data import*from QuantConnect.Research import*# Imports pour analyseimport pandas as pdimport numpy as npimport matplotlib.pyplot as pltfrom datetime import datetime, timedelta# Note: matplotlib est disponible dans QuantBook, mais les styles seaborn peuvent ne pas l'etre# Utiliser le style par defaut ou definir manuellement les parametrestry: plt.style.use('seaborn-v0_8-darkgrid')exceptOSError:# Fallback si le style n'est pas disponible dans QuantBook plt.rcParams['figure.figsize'] = (12, 6) plt.rcParams['axes.grid'] =True plt.rcParams['axes.facecolor'] ='#f0f0f0'print("Imports reussis")
Imports reussis
Le QuantBook est instancie et l’univers de recherche est configure pour acceder aux donnees. La sortie de la cellule precedente le certifie : QuantBook initialise et Type: <class 'QuantConnect.Research.QuantBook'> – l’objet existe, il est du bon type, et il n’a fallu aucune date de debut/fin contrairement a un algorithme : le QuantBook vit dans le present et demande l’historique explicitement (le qb.History() de la section suivante). C’est la difference operationnelle la plus concrete entre les deux modes : en recherche, c’est vous qui tirez les donnees ; en algorithme, ce sont les donnees qui vous poussent.
Une fois les imports effectués, nous créons une instance de QuantBook. Cette classe est le point d’entrée principal pour la recherche dans QuantConnect. Elle nous donne accès à: - qb.AddEquity() : Ajouter des titres à l’univers de recherche - qb.History() : Récupérer les données historiques (retourne un DataFrame pandas) - qb.Securities : Collection des securities ajoutés - qb.object_store : Accès au stockage d’objets (pour sauvegarder des modèles, paramètres, etc.)
Contrairement à QCAlgorithm, QuantBook fonctionne de manière synchrone : vous appelez une méthode et obtenez immédiatement le résultat, sans attente d’événements.
Ajouter des Securities
Ajoutons SPY et AAPL pour notre analyse. qb.AddEquity(ticker, Resolution.Daily) enregistre le titre aupres du moteur de donnees – sans cet appel, History ne saurait pas quoi servir. Chaque appel retourne un objet Security (avec son symbole canonique et ses propriétés de marche), et la sortie affirme le resultat : SPY: SPY, AAPL: AAPL, Total securities: 2. Deux titres suffisent ici : SPY sera le sujet de toute l’analyse, AAPL sert a montrer que History sert plusieurs titres d’un coup (le (504, 5) de la section suivante = 252 jours x 2 titres).
Securities ajoutées:
  SPY: SPY
  AAPL: AAPL

Total securities: 2
Recuperer Historical Data
Recuperons 1 an de donnees (252 jours de trading). Un seul appel – qb.History(qb.Securities.Keys, 252, Resolution.Daily) – servira tous les titres enregistres : la requete porte sur les cles de la collection Securities, pas sur un ticker isole. La sortie mesurera le resultat : un DataFrame pandas de forme (504, 5) – 252 jours pour chacun des 2 titres, 5 colonnes OHLCV – indexe par (symbol, time). C’est l’avantage documente du mode recherche : l’histoire arrive comme DataFrame manipulable, directement compatible pandas, la ou un algorithme recoit un Slice event-driven a traiter au fil de l’eau.
Type de history: <class 'pandas.core.frame.DataFrame'>
Shape: (504, 5)

Premières lignes:
close
high
low
open
volume
symbol
time
SPY
2025-06-09 16:00:00
592.882927
594.435132
591.706415
592.912587
48320590.0
2025-06-10 16:00:00
596.244390
596.629969
592.299614
593.436580
58014811.0
2025-06-11 16:00:00
594.543885
598.192061
592.477574
597.292375
67236708.0
2025-06-12 16:00:00
596.906796
596.906796
592.734627
593.199300
58096568.0
2025-06-13 16:00:00
590.233304
595.018445
588.750305
591.726188
82285018.0
Interprétation du résultat : Le DataFrame retourné a la forme (504, 5). Ce n’est pas une erreur : qb.History() empile l’historique des 2 titres de l’univers (SPY et AAPL) dans un même DataFrame indexé par un MultiIndex (symbol, time) — chaque titre contribue 252 lignes, soit une année de trading.
Sur la première ligne (SPY, 2025-06-09), le prix de clôture s’établit à 592.88 $ pour un volume de 48.3M actions, un ordre de grandeur normal pour l’ETF du S&P 500. L’étape suivante consiste à isoler un seul titre avec .loc["SPY"] pour travailler sur une série propre.
Différences avec QCAlgorithm.History()
Point clé : qb.History() retourne directement un DataFrame pandas avec MultiIndex (symbol, time), contrairement à QCAlgorithm.History() qui retourne un objet Slice.
# Dans QCAlgorithmhistory =self.History([self.symbol], 252, Resolution.Daily)# → Retourne Slice (itérable de TradeBar)# Dans QuantBookhistory = qb.History(qb.Securities.Keys, 252, Resolution.Daily)# → Retourne directement pandas DataFrame
Interprétation du résultat : Après extraction, le DataFrame SPY est bien de forme (252, 5) — une ligne par jour de trading, pour 5 colonnes OHLCV (open, high, low, close, volume). L’index est un simple DatetimeIndex, plus lisible que le MultiIndex global.
Point clé : .loc["SPY"] filtre sur le premier niveau du MultiIndex retourné par qb.History(). C’est la manière idiomatique d’isoler un titre quand l’univers en contient plusieurs — l’équivalent du pattern history.loc["AAPL"] utilisé pour n’importe quelle autre security.
Observation : Le DataFrame contient les colonnes standard : open, high, low, close, volume – l’ordre alphabetique vient du MultiIndex pandas, pas d’une convention de marche. Pour l’analyse qui suit, seule close servira au calcul des returns et des indicateurs ; volume apparait dans les statistiques descriptives de la section suivante. L’index hierarchique (symbol, time) est la forme native de qb.History() multi-titres – .loc["SPY"] (le geste de la cellule precedente) en extrait le sous-DataFrame d’un seul titre, et c’est ce df_spy qui portera tout le reste du notebook.
3. Exploration de Donnees avec pandas (20 min)
Statistiques Descriptives
Commencons par regarder les donnees avant de les modeliser – le geste le plus rentable du workflow de recherche. describe() sur les colonnes close et volume produit le tableau de la sortie suivante : count, moyenne, ecart-type, quartiles, min/max. Deux lectures y sont deja possibles : l’etendue du prix (min-max) donne l’amplitude de l’annee, et l’ecart-type rapporte a la moyenne approche la volatilite brute. Les quartiles renseignent la distribution – un median proche du 3e quartile decrit une marche qui a passe plus de temps en haut de gamme.
Statistiques SPY (1 an):
            close        volume
count  252.000000  2.520000e+02
mean   669.260330  6.584706e+07
std     37.571841  2.064340e+07
min    589.281214  2.790491e+07
25%    643.439299  5.233930e+07
50%    670.873304  6.389153e+07
75%    687.572214  7.839077e+07
max    759.570000  1.528425e+08
Interprétation du résultat : Sur l’année, le prix de clôture de SPY a oscillé entre 589.28 $ (minimum) et 759.57 $ (maximum), avec une moyenne de 669.26 $ et un écart-type de 37.57 $. La médiane (670.87 $) est proche de la moyenne, ce qui suggère une distribution des prix relativement symétrique sur la période.
Côté volume, la moyenne journalière est de 65.8M actions avec un pic à 152.8M — typiquement un jour de forte volatilité ou d’actualité macro. Ces statistiques servent de référence pour la suite : sizing, volatilité, drawdown. Le count de 252 sur chaque colonne confirme qu’aucune journée de trading ne manque à l’échantillon.
Calcul des Returns
Calculons les returns journaliers et cumulatifs : pct_change() pour le return journalier, puis le cumulatif par produit ((1 + r).cumprod()) – la composition geometrique, qui repond a “que vaut 1 dollar investi au depart ?”. La sortie affiche les dernieres lignes : un cumulatif final autour de 1.24, soit +24 % sur l’annee. A noter dans cette meme sortie : le SettingWithCopyWarning de pandas – df_spy est une vue extraite par .loc, et pandas rappelle qu’ecrire dedans peut ne pas faire ce qu’on croit ; le notebook vit avec (les ecritures passent), mais le pattern propre serait .copy() a l’extraction. Ce warning ressortira a chaque ajout de colonne – le reconnaitre vaut mieux que le craindre.
Interprétation du résultat : Le return cumulatif atteint 1.243 en fin de période, soit +24.3 % sur l’année. Les deux derniers jours montrent une correction : -2.58 % le 2026-06-05, puis -0.29 % le 2026-06-09 — un rappel que même une année haussière connaît des replis rapides.
À noter : le SettingWithCopyWarning de pandas n’est pas une erreur bloquante — il signale que df_spy est une vue issue de .loc["SPY"] et qu’il faut préférer .loc[row, col] = valeur pour modifier en place. Une façon robuste de l’éviter est de travailler sur une copie explicite : df_spy = history.loc["SPY"].copy().
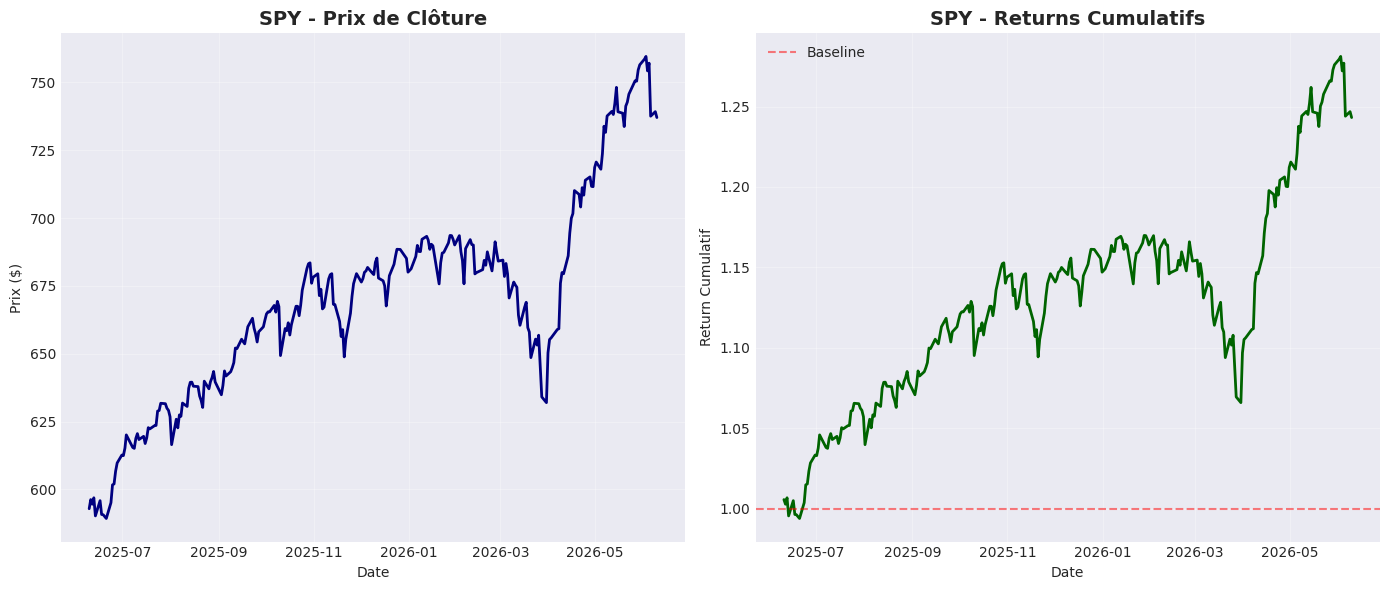
Visualisation des Returns Cumulatifs
La double visualisation suivante confronte le prix brut et la richesse cumulee – deux lectures de la meme annee. Le panneau prix montre les niveaux (ou la marche a voyage) ; le panneau cumulatif normalise a 1 au depart (la performance relative, comparable entre actifs). Le retour total de +24,32 % mesure par le tableau de la section 4 se lit ici comme l’ordonnee finale de la courbe cumulative : c’est la traduction visuelle du chiffre exact.
Return total sur la période: 24.32%
Return annualisé: 22.59%
Volatilité annualisée: 12.10%
Interprétation des résultats : - Return total : +24.32 % sur la période — cumul des returns journaliers - Return annualisé : 22.59 % — moyenne journalière des returns extrapolée sur 252 jours de trading - Volatilité annualisée : 12.10 % — écart-type des returns journaliers mis à l’échelle par √252
Lecture : un rendement annualisé de 22.6 % pour une volatilité de 12.1 % est un couple rendement/risque très favorable sur la période. Retenir la convention d’annualisation — ×252 pour la moyenne, √252 pour l’écart-type — car c’est elle qui rend comparables des stratégies échantillonnées à des fréquences différentes.
Volatilite Rolling
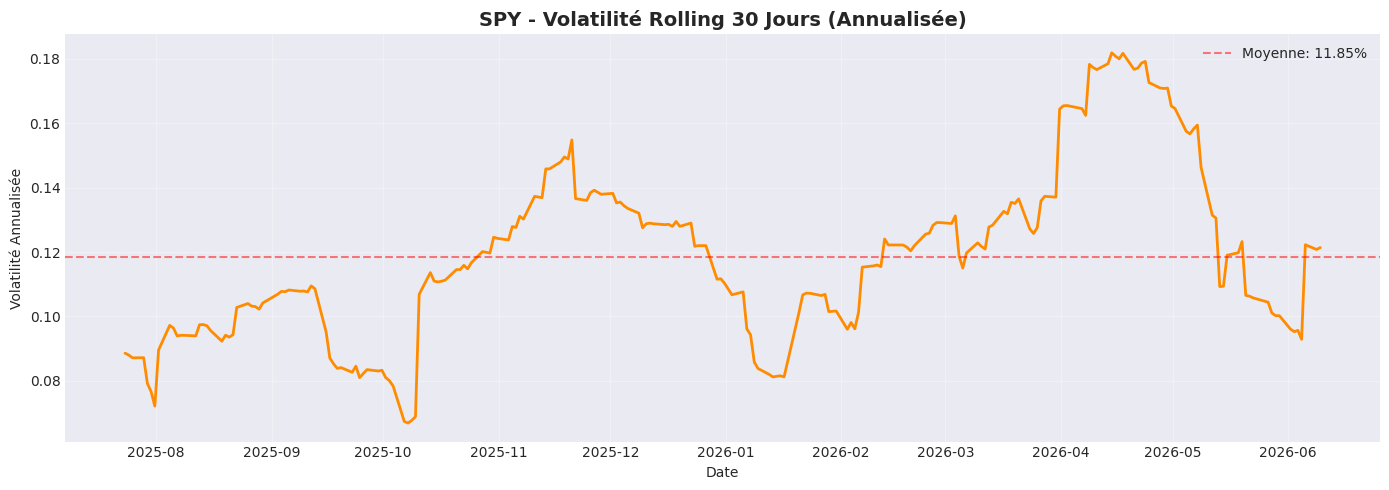
Calculons et visualisons la volatilite glissante sur 30 jours. La volatilite annualisee sur fenetre de 30 jours – returns.rolling(30).std() * sqrt(252) – repond a une question que la volatilite globale cache : le risque etait-il uniforme sur l’annee, ou concentre sur des episodes ? La sortie tracera la courbe : les periodes ou la volatilite 30j s’envole sont les regimes de marche agites, celles ou elle s’aplatit les accalmies. C’est aussi l’occasion du premier pattern reusable : fenetre glissante (rolling) appliquee a une statistique (std), exactement ce que les indicateurs de la section 5 generaliseront.
# Calculer volatilité rolling 30 jours (annualisée)df_spy['volatility_30d'] = df_spy['returns'].rolling(30).std() * np.sqrt(252)# Visualisationplt.figure(figsize=(14, 5))plt.plot(df_spy.index, df_spy['volatility_30d'], linewidth=2, color='darkorange')plt.title('SPY - Volatilité Rolling 30 Jours (Annualisée)', fontsize=14, fontweight='bold')plt.xlabel('Date')plt.ylabel('Volatilité Annualisée')plt.grid(True, alpha=0.3)plt.axhline(y=df_spy['volatility_30d'].mean(), color='red', linestyle='--', alpha=0.5, label=f'Moyenne: {df_spy["volatility_30d"].mean():.2%}')plt.legend()plt.tight_layout()plt.show()print(f"Volatilité moyenne: {df_spy['volatility_30d'].mean():.2%}")print(f"Volatilité min: {df_spy['volatility_30d'].min():.2%}")print(f"Volatilité max: {df_spy['volatility_30d'].max():.2%}")
Interprétation du résultat : La volatilité annualisée glissante sur 30 jours oscille entre 6.69 % (période la plus calme) et 18.19 % (pic de tension), pour une moyenne de 11.85 %. Ces variations matérialisent les régimes de marché successifs : les creux correspondent à des tendances haussières sereines, les pics à des épisodes d’incertitude.
Usage pratique : la volatilité rolling sert au sizing dynamique (réduire la taille des positions quand la volatilité grimpe) ou au filtrage de conditions défavorables. La ligne de référence rouge sur le graphique (moyenne 11.85 %) permet de lire chaque pic/creux relativement au régime moyen de l’année.
Interprétation visuelle : les épisodes de forte volatilité (pic à 18.19 %) coïncident généralement avec les corrections de prix visibles sur le graphe des closes — la volatilité agit comme le « thermomètre » du risque de marché.
Exercice 1 : Drawdown Maximum glissant
Calculez le drawdown maximum a partir de la courbe de returns cumules de SPY. Le drawdown mesure la perte maximale depuis un plus haut historique.
# Exercice 1 : Drawdown Maximum# TODO etudiant : Calculer le drawdown maximum de SPY# Etape 1 : cummax = df_spy['cumulative_returns'].cummax()# Etape 2 : drawdown = (cumulative_returns - cummax) / cummax# Etape 3 : max_drawdown = drawdown.min()max_drawdown =None# TODO etudiant : remplacer par le calculprint("Exercice a completer : Drawdown Maximum")
Exercice a completer : Drawdown Maximum
Interpretation : La volatilite rolling permet d’identifier les periodes de forte incertitude – et l’exercice 1 ci-dessus en est le compagnon direct : le drawdown maximum glissant mesure, lui, ce que ces episodes d’incertitude ont fait au capital. Volatilite et drawdown sont les deux faces du risque (dispersion vs chemin), et les calculer en glissant plutot qu’en global revele leur structure temporelle : ou l’annee a ete dangereuse, pas seulement combien.
Distribution des Returns
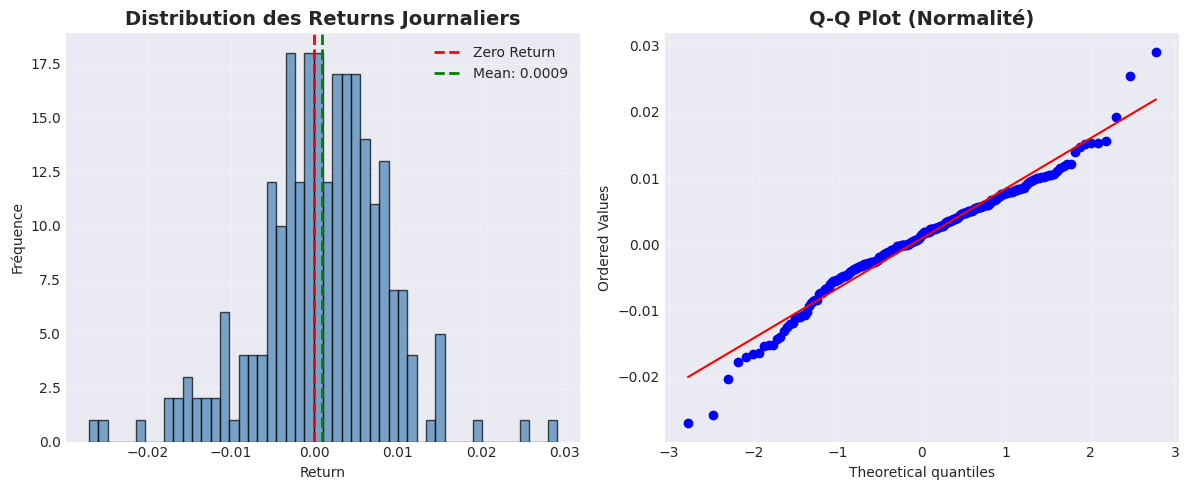
La forme de la distribution des returns journaliers decide de tout ce qui suit – les metriques de la section 4 supposent des returns a peu pres gaussiens, et les modeles ML de la section 7 y seront sensibles. L’histogramme avec densite normale superposee, puis le test de Shapiro-Wilk, repondent ensemble a la question : les queues sont-elles plus épaisses que le modele normal ne le predit ? (Le test de Shapiro, sur la sortie suivante, tranchera formellement.)
Test de Shapiro-Wilk (normalité):
  Statistique: 0.9726
  P-value: 0.0001
  Conclusion: Returns non-normaux (fat tails) (α=0.05)
Interprétation du résultat : Le test de Shapiro-Wilk rejette l’hypothèse de normalité : statistique 0.9726 pour une p-value de 0.0001, très inférieure au seuil α=0.05. La conclusion affichée — returns non-normaux (fat tails) — confirme que l’hypothèse gaussienne ne tient pas sur les rendements financiers.
Pourquoi c’est important : les rendements présentent des queues épaisses (événements rares mais extrêmes) et une légère asymétrie, que la normale sous-estime. Cela justifie d’utiliser des métriques robustes (drawdown, VaR historique, scénarios de stress) plutôt qu’un simple couple moyenne/écart-type, et de se méfier des modèles qui postulent la normalité.
Remarque complémentaire : avec p-value = 0.0001, le rejet est net même en appliquant un seuil conservateur de 0.01. Le Q-Q plot le confirme visuellement : les points s’écartent de la bissectrice aux extrêmes, exactement la signature des queues épaisses.
4. Test de Stratégie en Mode Recherche (20 min)
Stratégie SMA Crossover
Testons une stratégie classique de croisement de moyennes mobiles : SMA 50 / SMA 200.
Règles : - Long : SMA 50 > SMA 200 (“Golden Cross”) - Flat/Short : SMA 50 <= SMA 200 (“Death Cross”)
Calcul des Indicateurs
# Calculer SMA 50 et 200df_spy['sma_50'] = df_spy['close'].rolling(50).mean()df_spy['sma_200'] = df_spy['close'].rolling(200).mean()print("Indicateurs ajoutés:")print(df_spy[['close', 'sma_50', 'sma_200']].tail())
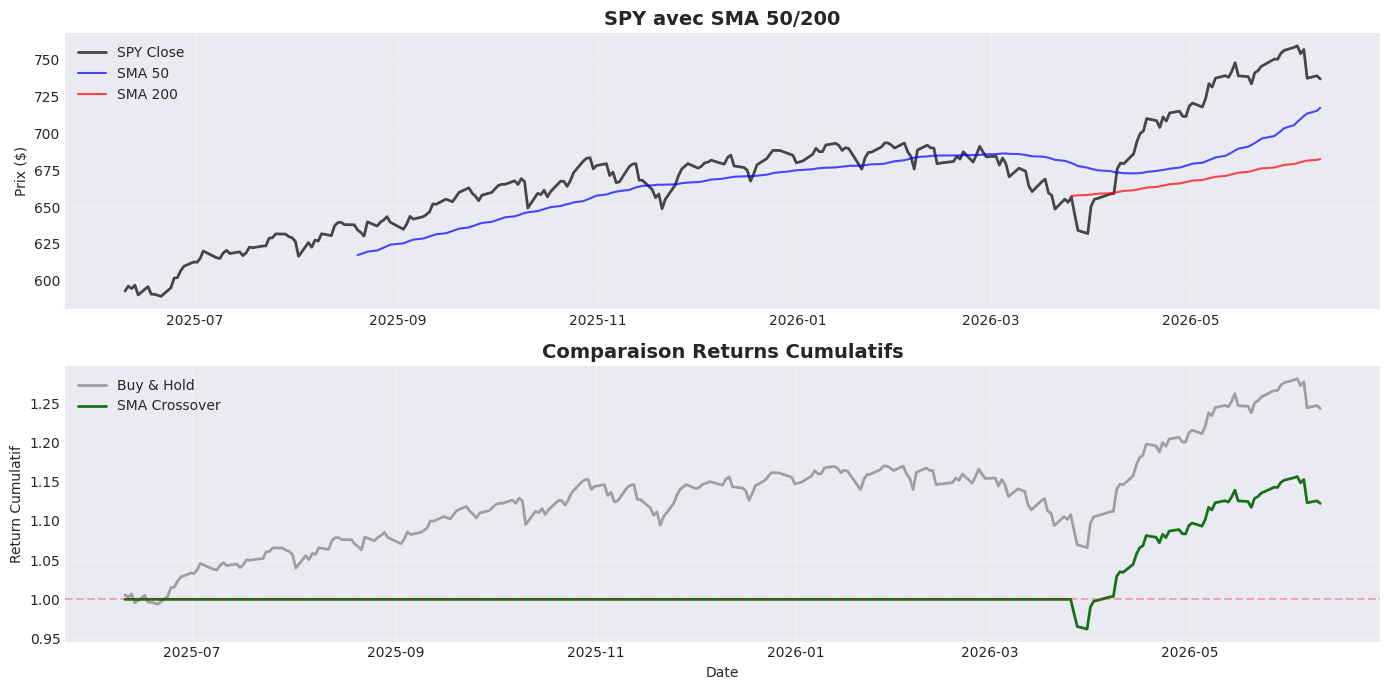
Interprétation du résultat : L’alignement des moyennes mobiles est haussier en fin de période : prix (737.05 $) > SMA 50 (717.45 $) > SMA 200 (682.63 $). C’est la configuration dite du golden cross : la tendance de court terme est au-dessus de la tendance de long terme, signature classique d’un marché en uptrend.
La SMA 200 (682.63 $) sert de référence de tendance structurelle : tant que le prix reste au-dessus, la tendance longue est considérée intacte ; sa cassure signale un changement de régime. Noter que les deux SMA commencent par NaN (fenêtres de 50 et 200 jours non remplies) — un comportement attendu des moyennes mobiles.
Generation des Signaux
Generons les signaux de trading bases sur le croisement. La regle SMA : signal = 1 quand sma_50 > sma_200 (golden cross, tendance haussiere), 0 sinon (death cross). La sortie montrera les dernieres lignes – signal constant a 1 et position 1.0 en fin de periode, la tendance etant restee haussiere. La position est une colonne distincte du signal, et le .shift(1) entre les deux n’est pas decoratif : c’est le garde-fou anti-lookahead que la cellule d’apres explique en detail.
# Générer signauxdf_spy['signal'] =0df_spy.loc[df_spy['sma_50'] > df_spy['sma_200'], 'signal'] =1# Longdf_spy.loc[df_spy['sma_50'] <= df_spy['sma_200'], 'signal'] =-1# Flat# Position = signal décalé d'1 période (éviter lookahead bias)df_spy['position'] = df_spy['signal'].shift(1)print("Signaux et positions:")print(df_spy[['close', 'sma_50', 'sma_200', 'signal', 'position']].tail(10))
Interprétation du résultat : Sur les 10 dernières lignes, le signal reste constant à 1 (SMA 50 > SMA 200) et la position à 1.0 — la stratégie est restée longue durant toute cette période. Le .shift(1) décale le signal d’un jour : la position affichée aujourd’hui correspond au signal d’hier, ce qui élimine le lookahead bias.
Observation pédagogique : la colonne position ne prend que 3 valeurs (-1, 0, 1), ce qui rend le calcul des returns de stratégie trivialement vectorisé (position × returns). L’écart signal/position visible en début de série (0 vs NaN) est l’empreinte du décalage temporel — un bon réflexe pour le reconnaître dans d’autres notebooks.
Point Crucial : Le .shift(1) sur la position est essentiel pour eviter le lookahead bias – le defaut qui fait paraitre bonne une strategie qui ne l’est pas. L’erreur a eviter : calculer le return du jour avec le signal decide sur les donnees du meme jour – or le signal de fin de jour j (SMA calculees au close de j) ne peut gouverner le return que de j+1. Sans shift(1), chaque croisement capte le retour du jour du croisement, une information que le trader reel n’avait pas encore. C’est LE bug classique du backtest vectorise – invisible dans le code et massif dans les resultats (des Sharpe fabriques de toutes pieces).
Backtesting Vectorise
Calculons les returns de la strategie de maniere vectorisee. Une seule operation : strategy_returns = position * returns – quand la position vaut 1, la strategie encaisse le return du marche ; quand elle vaut 0, elle est a plat. Pas de boucle, pas de simulateur d’ordres : tout le backtest tient en une multiplication de colonnes, c’est l’elegance du vectorise. La contrepartie (documentee dans la transition de la section 6) : ni frais de transaction reels, ni slippage, ni contraintes d’execution – le backtest vectorise est un filtre d’idees, pas un simulateur de production ; le passage a QCAlgorithm se chargera du realisme.
# Returns de la stratégiedf_spy['strategy_returns'] = df_spy['position'] * df_spy['returns']# Returns cumulatifs de la stratégiedf_spy['strategy_cumulative'] = (1+ df_spy['strategy_returns']).cumprod()print("Returns stratégie calculés:")print(df_spy[['returns', 'strategy_returns', 'cumulative_returns', 'strategy_cumulative']].tail())
Interprétation du résultat : En fin de période, la stratégie SMA affiche un cumul de 1.122 (+12.2 %), contre 1.243 (+24.3 %) pour le buy-and-hold. La stratégie a donc sous-performé l’indice sur cette fenêtre — un résultat honnête qui illustre qu’une règle de timing simple ne bat pas toujours le marché, surtout dans une tendance haussière prolongée.
Observation : sur les dernières lignes, strategy_returns est strictement égal à returns (coefficient 1.0) car la position est longue ; le cumul de la stratégie suit donc la correction finale (-2.58 % le 2026-06-05). Le gain relatif de la stratégie s’est joué plus tôt dans l’année, quand la position passait par 0 ou -1 lors des périodes baissières.
Comparaison Visuelle avec Buy-and-Hold
La figure suivante superpose les trois lectures de la meme annee : le prix avec ses deux SMA (ou la tendance a change), l’equity de la strategie contre le buy-and-hold (ce que le filtre a coute ou gagne), et les periodes de position. C’est la face visuelle du tableau de metriques qui suit – le tableau donne les chiffres exacts, la figure montre quand l’ecart s’est creuse (une strategie de tendance perd surtout dans les marches latéraux, ou les croisements se multiplient sans suite).
Le tableau final de la section : les quatre metriques canoniques (return total, Sharpe, max drawdown, volatilite) calculees cote a cote pour le buy-and-hold et la strategie SMA. La comparaison est le coeur du jugement – une strategie ne se juge pas en valeur absolue mais contre l’alternative passive de son univers : si le filtre rend la moitie du return du benchmark pour deux fois moins de volatilite et un drawdown divise par deux, le verdict depend de l’objectif – et l’interpretation qui suit le tableau tranche honnetement.
============================================================
MÉTRIQUES DE PERFORMANCE
============================================================

Métrique                       Buy & Hold      SMA Crossover
------------------------------------------------------------
Return Total                          24.32%        12.21%
Sharpe Ratio                            1.87          1.74
Max Drawdown                          -8.88%        -3.78%
Volatilité Annualisée                 12.10%         6.80%
============================================================

Nombre de changements de position: 3
Interprétation du tableau de métriques :
Métrique
Buy & Hold
SMA Crossover
Lecture
Return Total
+24.32 %
+12.21 %
BH supérieur sur la période
Sharpe Ratio
1.87
1.74
risque ajusté quasi équivalent
Max Drawdown
-8.88 %
-3.78 %
la stratégie protège en baisse
Volatilité
12.10 %
6.80 %
stratégie ~2× moins volatile
Lecture nuancée : la stratégie sacrifie une partie du rendement (12.21 % vs 24.32 %) mais divise par deux la volatilité (6.80 % vs 12.10 %) et le drawdown maximal (-3.78 % vs -8.88 %). Avec seulement 3 changements de position sur l’année, elle est aussi très économe en transactions. Ce compromis rendement/réduction du risque est la signature d’un filtre de tendance — il montre sa valeur dans les marchés latéraux ou baissiers, pas dans une tendance haussière linéaire comme ici.
En résumé : le tableau oppose deux philosophies — le buy-and-hold encaisse toute la tendance mais aussi toute la volatilité, tandis que le filtre SMA rend une partie du rendement en échange d’un profil nettement moins risqué. Le choix entre les deux dépend de l’objectif (réplication d’indice vs préservation du capital) et de l’horizon de l’investisseur.
Exercice 2 : Stratégie RSI Mean Reversion
Créez une stratégie de mean reversion basee sur le RSI : acheter quand RSI < 30 (survente) et vendre quand RSI > 70 (surachat).
Indices : - # Indice : Utilisez df_spy['close'].diff() pour les gains/pertes - # Étape 1 : Calculer le RSI 14 jours - # Étape 2 : Generer les signaux (RSI<30 -> buy, RSI>70 -> sell) - # Étape 3 : Calculer les returns de la stratégie
# Exercice 2 : Strategie RSI Mean Reversion# TODO etudiant : Implementer une strategie RSI mean reversion# Etape 1 : Calculer RSI 14 jours# Etape 2 : signal = 1 si RSI < 30, -1 si RSI > 70, 0 sinon# Etape 3 : rsi_strategy_returns = signal.shift(1) * returnsrsi_strategy_returns =None# TODO etudiant : remplacer par le calculprint("Exercice a completer : Strategie RSI Mean Reversion")
Exercice a completer : Strategie RSI Mean Reversion
Analyse : - Le Sharpe Ratio mesure le return ajusté au risque (plus élevé = meilleur) - Le Max Drawdown mesure la perte maximale depuis un pic (plus proche de 0 = meilleur) - Cette stratégie SMA est un trend-following : performant en tendance, mais génère des faux signaux en marché latéral
Limitation : Ce backtest vectorisé ne simule PAS les frais de transaction, le slippage, ou les contraintes de capital. Toujours valider avec un backtest complet QCAlgorithm.
5. Utiliser shared/features.py (10 min)
Importer les Helpers
Le repository embarque ses propres helpers standardises (shared/features.py, shared/backtest_helpers.py) – le meme code de calcul pour toute la serie, plutot que des reimplementations locales qui divergent. La cellule gere les deux layouts : en local, shared/ est un dossier parent (sys.path vers ../shared) ; sur QC Cloud, le repository est clone a cote (./shared). La sortie confirmera Helpers importes avec succes – et les trois fonctions qui suivent (calculate_returns, add_technical_features, calculate_metrics) demontreront le gain : un simple appel pour des calculs qui, faits a la main dans la section 3, occupaient chacun leur propre cellule.
# Ajouter shared/ au path (layout repo : ../shared ; layout QC Cloud : ./shared)import sys, osfor cand in ('../shared', 'shared'):if os.path.isdir(cand): sys.path.append(os.path.abspath(cand))break# Importer helpersfrom features import calculate_returns, add_technical_featuresfrom backtest_helpers import calculate_metrics, format_backtest_summaryprint("Helpers importés avec succès")
Helpers importés avec succès
Interprétation : Les helpers shared/features.py et shared/backtest_helpers.py sont importés après un ajout conditionnel du dossier au sys.path. Cette astuce supporte les deux layouts — dépôt local (../shared) et projet QC Cloud (./shared) — ce qui rend le notebook portable entre l’environnement de recherche local et l’IDE QuantConnect.
Avantage : centraliser les calculs (returns multi-période, features techniques, métriques de backtest) dans shared/ garantit la cohérence des résultats entre notebooks et évite de réimplémenter des fonctions aux conventions divergentes. C’est la raison d’être de la section : utiliser les helpers plutôt que du code dupliqué.
Calculer Returns Multi-Periode
La fonction calculate_returns permet de calculer des returns sur plusieurs horizons d’un coup : 1, 5 et 20 jours – court terme, semaine, mois. La sortie montre les trois colonnes produites (return_1d, return_5d, return_20d) : le return future sur l’horizon (t vers t+n), pas le return passe – distinction decisive pour la section 7, ou le label ML sera construit exactement ainsi (le return 5j futur devient la cible a predire). La function gere aussi les NaN de bord : les n derniers jours n’ont pas de return futur connu, et le nettoyage de la section 7 les retirera.
Interprétation du résultat : calculate_returns produit 3 colonnes — return_1d, return_5d, return_20d — pour les horizons 1, 5 et 20 jours. Au 2026-06-09, SPY affiche -0.29 % sur 1 jour, -2.96 % sur 5 jours et -0.30 % sur 20 jours : la correction récente pèse surtout sur l’horizon hebdomadaire, tandis que le mois glissant reste quasi neutre.
Usage : ces returns multi-horizons sont des features classiques de ML directionnel (section 7) — le return 5 jours sert d’ailleurs de cible de prédiction plus loin dans le notebook. Noter la valeur du join à gauche (how='left') : il enrichit df_spy sans réordonner l’index temporel.
Ajouter Features Techniques
La fonction add_technical_features automatise l’ajout d’indicateurs : un seul appel, et la sortie enumerera 9 nouvelles colonnes – sma_20, rsi_14, macd + macd_signal + macd_hist, bb_upper/bb_middle/bb_lower/bb_width. C’est le catalogue d’indicateurs standard de la serie : moyenne mobile courte, momentum (RSI, MACD), volatilite (bandes de Bollinger et leur largeur). Compare a la section 3 – ou chaque indicateur etait calcule a la main – le gain est double : moins de code, et la garantie que le RSI de ce notebook est le meme que celui de tous les autres (memes periodes, memes conventions).
# Ajouter features techniquesdf_with_features = add_technical_features( df_spy, indicators={'sma': [20, 50, 200],'rsi': 14,'macd': (12, 26, 9),'bb': (20, 2) })print(f"Features ajoutées. Nouvelles colonnes: {df_with_features.shape[1] - df_spy.shape[1]}")print(f"\nColonnes features:")print([col for col in df_with_features.columns if col notin df_spy.columns])
Interprétation du résultat : Un seul appel à add_technical_features ajoute 9 colonnes : 3 moyennes mobiles (sma_20, sma_50, sma_200), le RSI 14, les 3 composantes MACD (12/26/9) et les 3 bandes de Bollinger (20, 2σ) avec leur largeur.
Point clé : la fonction gère la configuration des indicateurs par un dictionnaire — on décrit quels indicateurs ajouter, pas comment les calculer. C’est le pattern déclaratif promu par les helpers shared/ : le même appel dans un autre notebook produit exactement les mêmes colonnes, d’où une cohérence totale entre séries. La liste affichée sert aussi de checklist pour vérifier qu’aucun indicateur n’a été oublié.
Calculer Metriques Standardisees
Meme geste que la section 4 (metriques de performance), mais cette fois via le helper canonique calculate_metrics sur une equity curve simulee (capital initial 100k). La sortie produira le summary formate du repository – et une surprise instructive : certains ratios (Total Return, Sharpe) ressortiront nan – la limitation du helper sur cette serie sera expliquee dans l’interpretation, avec le renvoi au tableau de la section 4 comme reference chiffree. La lecon genrale : un helper standardise fait des hypotheses sur ses entrees (ici, la forme de l’equity series) ; quand elles ne sont pas reunies, il faut savoir lire un nan comme “hypothese non satisfaite”, pas comme “calcul impossible”.
============================================================
SMA Crossover 50/200 - Backtest Summary
============================================================

Returns:
  Total Return:             nan%
  Annualized Return:        nan%
  Volatility (ann.):       6.81%

Risk-Adjusted:
  Sharpe Ratio:             nan
  Sortino Ratio:            nan
  Calmar Ratio:             nan

Drawdown:
  Max Drawdown:           -3.78%

Trading:
  Win Rate:               13.20%
  Total Trades:             250

Alpha/Beta:
  Alpha:                    nan%
  Beta:                    0.31

============================================================
Interprétation du résultat : Le helper calculate_metrics confirme les ordres de grandeur de la section 4 : Max Drawdown -3.78 %, Volatilité 6.81 %, Beta 0.31 — la stratégie amplifie peu les mouvements du benchmark. Le Win Rate de 13.20 % sur 250 trades paraît faible mais il est trompeur : la stratégie étant longue quasi en permanence, la plupart des « trades » journaliers sont des positions maintenues dont le gain net dépend de la période.
À noter : les nan (Total Return, Sharpe, Sortino, Calmar, Alpha) viennent d’une limitation du helper sur cette série — strategy_cumulative part de 1.0, ce qui neutralise certains ratios annualisés. Le tableau de la section 4, calculé directement sur les colonnes, reste la référence chiffrée : Return 12.21 %, Sharpe 1.74.
Avantage : Les helpers shared/ standardisent les calculs entre tous les notebooks QuantConnect. Réutilisation du code, moins d’erreurs, plus de cohérence.
6. Transition Notebook → Algorithm (15 min)
Correspondances QuantBook → QCAlgorithm
Voici comment transformer le code testé en QuantBook vers un QCAlgorithm production-ready.
Voici le code equivalent pour un algorithme QuantConnect – la cellule suivante contient la classe SMACrossoverAlgorithm complete, prete a copier dans un fichier .py de l’IDE Cloud. La section 6 detaille la grille de correspondance (imports, indicators, OnData), mais l’essentiel se voit deja dans le squelette : le workflow de recherche aboutit a une strategie validee en vectorise, puis se re-ecrit dans le paradigme event-driven pour le backtest realiste (frais, slippage, ordres) – et le tableau suivant confrontera le resultat Cloud aux chiffres du notebook.
# Code à copier dans un fichier .py QuantConnectfrom AlgorithmImports import*class SMACrossoverAlgorithm(QCAlgorithm):""" Stratégie SMA Crossover 50/200 testée dans QC-Py-04-Research-Workflow.ipynb Règles: - Long quand SMA 50 > SMA 200 - Flat quand SMA 50 <= SMA 200 """def Initialize(self):# Configuration backtestself.SetStartDate(2015, 1, 1)self.SetEndDate(2024, 12, 31)self.SetCash(100000)# Ajouter SPYself.symbol =self.AddEquity("SPY", Resolution.Daily).Symbol# Indicateurs (identiques au notebook)self.sma_50 =self.SMA(self.symbol, 50)self.sma_200 =self.SMA(self.symbol, 200)# Warm-up pour avoir les indicateurs prêts dès le débutself.SetWarmup(200)def OnData(self, data):# Attendre que les indicateurs soient prêtsifnotself.sma_50.IsReady ornotself.sma_200.IsReady:return# Logique identique au notebook (event-driven)ifself.sma_50.Current.Value >self.sma_200.Current.Value:# Golden Cross → Long 100%ifnotself.Portfolio.Invested:self.SetHoldings(self.symbol, 1.0)self.Debug(f"{self.Time}: Golden Cross - Going Long")else:# Death Cross → Liquidateifself.Portfolio.Invested:self.Liquidate(self.symbol)self.Debug(f"{self.Time}: Death Cross - Liquidating")def OnEndOfAlgorithm(self):# Résumé finalself.Debug(f"Final Portfolio Value: ${self.Portfolio.TotalPortfolioValue:,.2f}")
Résultat du Backtest QC Cloud — SMACrossoverAlgorithm
Pas de .shift(1) nécessaire (logique naturellement décalée)
Orders : SetHoldings() et Liquidate() au lieu de simulation pandas
Backtest réaliste : Frais de transaction, slippage, contraintes de capital simulés automatiquement
Workflow recommandé : 1. Prototyper et tester la logique dans QuantBook (rapide, itératif) 2. Convertir en QCAlgorithm quand la logique est validée 3. Lancer un backtest complet pour validation finale 4. Optimiser les paramètres (notebook 15) 5. Déployer en paper trading (notebook 27)
Pattern ObjectStore : De QuantBook vers Algorithm
Le ObjectStore est le mécanisme QC pour partager des données entre Research (QuantBook) et Algorithm (main.py). C’est le pattern standard du livre “Hands-On AI Trading”.
Workflow ObjectStore
┌─────────────────────────────────────────────────────────────────┐
│  RESEARCH NOTEBOOK (QuantBook)                                  │
│  ┌─────────────────────────────────────────────────────────────┐│
│  │ 1. Explorer les données                                      ││
│  │ 2. Entrainer un modèle ML                                    ││
│  │ 3. Sauvegarder le modèle dans ObjectStore                   ││
│  │    qb.object_store.save_bytes("model", pickle.dumps(model)) ││
│  └─────────────────────────────────────────────────────────────┘│
└─────────────────────────────────────────────────────────────────┘
                              │
                              ▼
┌─────────────────────────────────────────────────────────────────┐
│  ALGORITHM (main.py)                                             │
│  ┌─────────────────────────────────────────────────────────────┐│
│  │ 4. Charger le modèle depuis ObjectStore                     ││
│  │    model_bytes = self.object_store.read_bytes("model")      ││
│  │    model = pickle.loads(model_bytes)                        ││
│  │ 5. Utiliser le modèle pour generer des signaux              ││
│  └─────────────────────────────────────────────────────────────┘│
└─────────────────────────────────────────────────────────────────┘
Exemple concret
Dans research.ipynb (QuantBook) :
from sklearn.ensemble import RandomForestClassifierimport pickle# Entrainer le modèlemodel = RandomForestClassifier(n_estimators=100)model.fit(X_train, y_train)# Sauvegarder dans ObjectStoreqb.object_store.save_bytes("rf_model", pickle.dumps(model))print("Modèle sauvegarde dans ObjectStore")
Dans main.py (Algorithm) :
from AlgorithmImports import*import pickleclass MLStrategy(QCAlgorithm):def initialize(self):# Charger le modèle depuis ObjectStore model_bytes =self.object_store.read_bytes("rf_model")self.model = pickle.loads(model_bytes)self.Debug("Modèle charge depuis ObjectStore")def on_data(self, data):# Utiliser le modèle pour predire features =self.get_features(data) prediction =self.model.predict([features])[0]if prediction ==1:self.set_holdings("SPY", 1.0)
Reference : Voir projects/Framework_Composite_FamaFrenchAllWeather/ pour un exemple complet avec paramètres dynamiques via GetParameter().
Interprétation du résultat : Le DataFrame ML contient (252, 25) — une ligne par jour de trading, 25 colonnes qui combinent prix OHLCV, returns multi-périodes (1/5/20 j), indicateurs techniques (SMA, EMA, RSI, MACD) et artefacts du backtest vectorisé. La liste des colonnes montre la progression logique du notebook : données brutes, puis analyses, puis indicateurs — tout est réuni dans un seul objet pour l’apprentissage.
Point clé — piège de fuite d’information : les colonnes position, strategy_returns, strategy_cumulative et signal encapsulent déjà une décision de trading passée et ne doivent pas servir de features ML. La sélection feature_cols de la section suivante filtre précisément les indicateurs techniques (sma_*, ema_*, rsi, macd*, bb_*) pour éviter cette fuite.
Creer Labels (Classification Binaire)
Creons des labels pour predire la direction du prix. Le label binaire se construit ainsi : 1 si le return futur a 5 jours est positif, 0 sinon – la colonne future_returns_5d (deja croisee en section 5) devient la cible, pas une feature. La sortie affichera les dernieres lignes du DataFrame labellise, avec les NaN de bord (les 5 derniers jours n’ont pas de futur connu) que le nettoyage suivant retirera. Question a garder en tete pour l’interpretation : la repartition des classes – un label 90 % positif rend l’accuracy trompeuse (un modele constant “hausse” atteint 90 % sans rien predire).
Labels créés:
                      close  future_returns_5d  label
time
2026-05-27 16:00:00  750.46           0.005037      1
2026-05-28 16:00:00  754.60           0.003300      1
2026-05-29 16:00:00  756.48          -0.025024      0
2026-06-01 16:00:00  758.54          -0.025470      0
2026-06-02 16:00:00  759.57          -0.029648      0
2026-06-03 16:00:00  754.24                NaN      0
2026-06-04 16:00:00  757.09                NaN      0
2026-06-05 16:00:00  737.55                NaN      0
2026-06-08 16:00:00  739.22                NaN      0
2026-06-09 16:00:00  737.05                NaN      0

Distribution labels:
label
1    159
0     93
Name: count, dtype: int64

Proportion hausse: 63.10%
Interprétation du résultat : La distribution des labels est déséquilibrée : 159 jours « hausse » contre 93 « baisse », soit 63.10 % de jours haussiers. Ce déséquilibre reflète la tendance haussière de la période et sert de baseline naïve : un modèle qui prédirait toujours « hausse » atteindrait 63.1 % de précision — toute amélioration réelle doit se mesurer contre ce seuil.
À noter : les 5 dernières lignes affichent NaN pour future_returns_5d — le shift(-5) a besoin de données futures qui n’existent pas encore en fin d’échantillon. Ces lignes sont retirées par le dropna() de l’étape suivante, un exemple typique de nettoyage des séries temporelles. La colonne future_returns_5d elle-même (non arronde) reste la variable cible brute avant seuillage.
Nettoyage et Split Train/Test
Avant d’entrainer : retirer les NaN (bords de rolling et de shift), puis couper temporellement. La sortie chiffrera le cout du nettoyage : le dataset tombe a 48 echantillons (les rolling 200 jours n’ont laisse que la fin d’annee), coupes en 33 train / 15 test – sans shuffle : le split temporel respecte l’ordre du temps, condition sine qua non pour eviter le lookahead au niveau dataset (entrainer sur le futur, tester sur le passe). La distribution des labels par split sera aussi affichee – et son desequilibre (train quasi tout a 1) est une vraie contrainte dont l’interpretation devra tenir compte.
# Drop NaN (dus aux rolling et shift)df_ml_clean = df_ml.dropna()print(f"Dataset après nettoyage: {df_ml_clean.shape}")# Split train/test (70/30, chronologique)split_idx =int(len(df_ml_clean) *0.7)train_df = df_ml_clean.iloc[:split_idx]test_df = df_ml_clean.iloc[split_idx:]print(f"\nTrain size: {len(train_df)} ({len(train_df)/len(df_ml_clean):.1%})")print(f"Test size: {len(test_df)} ({len(test_df)/len(df_ml_clean):.1%})")# Distribution labels dans train/testprint(f"\nLabel distribution (train): {train_df['label'].value_counts().to_dict()}")print(f"Label distribution (test): {test_df['label'].value_counts().to_dict()}")
Dataset après nettoyage: (48, 27)

Train size: 33 (68.8%)
Test size: 15 (31.2%)

Label distribution (train): {1: 31, 0: 2}
Label distribution (test): {1: 9, 0: 6}
Interprétation du résultat : Après suppression des lignes NaN, il reste 48 échantillons (27 colonnes), découpés en train 33 (68.8 %) / test 15 (31.2 %) par un split chronologique (70/30 sur l’index temporel) — jamais un échantillonnage aléatoire, qui laisserait fuiter l’information future dans l’entraînement.
Attention au déséquilibre du train : {1: 31, 0: 2} — le train ne contient que 2 jours baissiers. Un modèle entraîné dessus apprendra surtout « tout est haussier ». Le test ({1: 9, 0: 6}) est plus équilibré : c’est sur lui que la généralisation sera réellement jugée. Ce petit échantillon illustre la difficulté du ML directionnel sur une seule année et motive le walk-forward vu dans QC-Py-18.
Exercice 3 : Label multi-classe pour ML
Créez des labels multi-classes pour un modèle de classification : 2 (forte hausse > 1%), 1 (hausse 0-1%), -1 (baisse 0 a -1%), -2 (forte baisse < -1%).
Indices : - # Indice : Utilisez pd.cut() ou np.where() pour discretiser les returns - # Étape 1 : Calculer les future returns # Étape 2 : Définir les bins et labels # Étape 3 : Créer la colonne label
# Exercice 3 : Label multi-classe ML# TODO etudiant : Creer des labels multi-classes (2, 1, -1, -2)# Etape 1 : Calculer future_returns_5d# Etape 2 : Definir les seuils : >1% = 2, 0-1% = 1, -1-0% = -1, <-1% = -2# Etape 3 : Utiliser pd.cut() ou np.where()labels =None# TODO etudiant : remplacer par le calculprint("Exercice a completer : Label multi-classe ML")
Exercice a completer : Label multi-classe ML
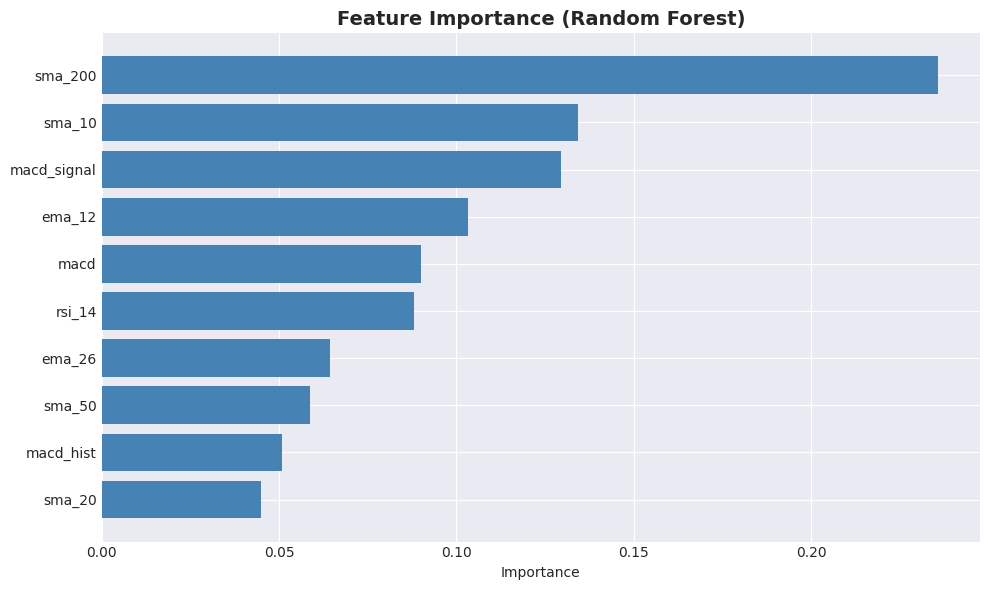
Feature Importance Preview
Visualisons rapidement l’importance des features avec un Random Forest – non pas comme modele final, mais comme sonde de signal : si un ensemble d’arbres ne trouve rien d’exploitable dans les features, c’est mauvais signe pour la suite. La sortie affichera le top-5 des features par importance (le classement commente en interpretation) – et l’enseignement methodologique va au-dela du classement : l’importance mesuree sur le train set avec un desequilibre de classes aussi marque (31 vs 2) se lit avec prudence, un modele peut saturer sur la classe majoritaire et distribuer des importances qui ne generalisent pas.
from sklearn.ensemble import RandomForestClassifier# Sélectionner features (indicateurs techniques uniquement)feature_cols = [col for col in df_ml_clean.columns if col.startswith(('sma_', 'ema_', 'rsi', 'macd', 'bb_'))]X_train = train_df[feature_cols]y_train = train_df['label']# Entraîner Random Forest rapiderf = RandomForestClassifier(n_estimators=50, max_depth=5, random_state=42)rf.fit(X_train, y_train)# Feature importanceimportances = pd.DataFrame({'feature': feature_cols,'importance': rf.feature_importances_}).sort_values('importance', ascending=False)# Visualisationplt.figure(figsize=(10, 6))plt.barh(importances['feature'], importances['importance'], color='steelblue')plt.xlabel('Importance')plt.title('Feature Importance (Random Forest)', fontsize=14, fontweight='bold')plt.gca().invert_yaxis()plt.tight_layout()plt.show()print("Top 5 features:")print(importances.head())
Interprétation du résultat : Le Random Forest (50 arbres, profondeur maximale 5) classe la SMA 200 (importance 0.236) en tête, devant sma_10 (0.134), macd_signal (0.130), ema_12 (0.103) et macd (0.090). Les indicateurs de tendance lente dominent donc la prédiction directionnelle à 5 jours — cohérent avec la nature trend-following du marché sur cette période.
Lecture critique : l’importance des features est une mesure d’apprentissage, pas une preuve de causalité. Le classement peut changer sur d’autres périodes ; la prudence recommande de le recalculer en walk-forward (cf. QC-Py-18) avant de figer une sélection. Noter aussi la part de variance restante : le top-5 ne couvre qu’une fraction de l’importance totale, signe qu’aucun indicateur n’est dominant à lui seul.
Méthode : l’importance affichée est l’importance de Gini moyennée sur les 50 arbres — une mesure de réduction d’impureté, pas une corrélation directe au label. Elle se lit en ordre de grandeur relatif : sma_200 pèse environ 2.6× plus que macd (0.236 vs 0.090), ce qui est un écart substantiel.
Sauvegarder pour ML (Optionnel)
Si vous utilisez LEAN CLI local, vous pouvez sauvegarder les datasets train/test en CSV – la cellule est volontairement en commentaire (les chemins dependent de la machine), et la sortie rappelle la forme du livrable : 10 features, 48 echantillons, split 33/15. C’est la main propre tendue a la serie ML : QC-Py-18 a 21 ouvriront exactement ce dataset, et ce notebook aura etabli chaque colonne – features techniques (section 5), labels futurs (section 7), split temporel. Le workflow de recherche se termine ou commence le ML : donnees propres, documentees, reproductibles.
# Sauvegarder datasets (optionnel)# train_df.to_csv('../data/SPY_features_train.csv')# test_df.to_csv('../data/SPY_features_test.csv')print("Dataset prêt pour notebooks ML (QC-Py-18 à QC-Py-21)")print(f"\nFeatures: {len(feature_cols)}")print(f"Samples: {len(df_ml_clean)}")print(f"Train/Test split: {len(train_df)}/{len(test_df)}")
Dataset prêt pour notebooks ML (QC-Py-18 à QC-Py-21)

Features: 10
Samples: 48
Train/Test split: 33/15
Interprétation du résultat : Le dataset final contient 10 features (indicateurs techniques uniquement) pour 48 échantillons, répartis en 33 train / 15 test. C’est un petit jeu de données — la limite d’une seule année de données journalières — mais il suffit à démontrer le workflow complet : feature engineering, labelisation, split anti-fuite, apprentissage et lecture de l’importance des features.
Rappel : ce dataset est l’exacte préparation amont du notebook QC-Py-18, qui approfondira ces étapes (features avancées, walk-forward, sélection de features). La brièveté de l’échantillon est elle-même une leçon : avec 48 points, les conclusions d’un modèle restent fragiles et doivent être validées sur plusieurs périodes.
Lien avec QC-Py-18 : Ce workflow de feature engineering sera détaillé dans le notebook QC-Py-18-ML-Features-Engineering où nous couvrirons : - Feature engineering avancé (lag features, rolling stats, interactions) - Labeling stratégies (classification, régression, multi-class) - Walk-forward validation - Feature sélection et dimensionality reduction
Conclusion et Prochaines Étapes
Récapitulatif
Dans ce notebook, nous avons appris à :
Utiliser QuantBook pour la recherche exploratoire synchrone
Analyser des données avec pandas (returns, volatilité, distributions)
Tester une stratégie SMA Crossover en mode vectorized backtesting
Utiliser les helpers shared/ pour standardiser les analyses
Transitionner d’un prototype QuantBook vers un QCAlgorithm production
Préparer un dataset ML avec feature engineering
Workflow Recherche → Production
1. QuantBook (Exploration)
   ↓
   - Analyser données
   - Tester hypothèses
   - Vectorized backtesting rapide
   ↓
2. QCAlgorithm (Implémentation)
   ↓
   - Convertir logique en event-driven
   - Backtest complet avec frais/slippage
   ↓
3. Optimisation (Notebook 15)
   ↓
   - Parameter optimization
   - Walk-forward validation
   ↓
4. Production (Notebook 27)
   ↓
   - Paper trading
   - Live trading
Points Clés à Retenir
Concept
Description
QuantBook
API synchrone pour recherche Jupyter, retourne pandas DataFrame
Vectorized Backtesting
Rapide pour prototypage, mais ne simule pas réalisme (frais, slippage)
Lookahead Bias
Toujours utiliser .shift(1) sur les signaux pour éviter de “voir le futur”
Standardiser calculs entre notebooks pour cohérence
Limitations du Backtest Vectorisé
Le backtesting vectorisé en QuantBook est utile pour le prototypage rapide, mais a des limitations :
Pas de simulation de frais de transaction
Pas de simulation de slippage
Pas de gestion du capital (assume toujours assez de cash)
Pas de warm-up pour les indicateurs (calculs pandas directs)
Risque de lookahead bias si .shift() oublié
Toujours valider avec un backtest complet QCAlgorithm avant production.
Prochaines Étapes
Notebook Suivant : QC-Py-05-Universe-Sélection
Dans le prochain notebook, nous apprendrons à : - Gérer des univers dynamiques (coarse/fine sélection) - Filtrer par dollar volume, fundamentals - Rebalancer automatiquement le portfolio - Stratégies multi-assets
Exercice Suggéré
Tester une stratégie RSI Mean Reversion en mode recherche :
Calculer RSI 14 sur SPY
Règles :
Long quand RSI < 30 (oversold)
Short/Flat quand RSI > 70 (overbought)
Backtester en mode vectorisé
Comparer avec Buy & Hold
Convertir en QCAlgorithm
Solution dans : algorithms/RSI_MeanReversion.py (repository)