La série compresse depuis le début : la distillation (3.7) comprimait le savoir d’un grand réseau vers un petit. Ce notebook comprime les nombres : peut-on stocker chaque poids et chaque activation sur 8 bits entiers au lieu de 32 bits flottants — un modèle 4 fois plus petit — sans perdre d’exactitude ?
Comme pour le reste de la série, on construit tout à la main : pas de torch.quantization ni de backend dédié. Chaque mécanisme (quantification asymétrique et par canal, calibration statique min/max, calibration par divergence de KL) est écrit, exécuté et mesuré sur un vrai réseau entraîné dans le notebook.
Le terrain est le duo canonique de la littérature quantification : ResNet-20 sur CIFAR-10 (~271 k poids — assez petit pour s’entraîner dans le notebook, assez réel pour que les mesures signifient quelque chose).
Le contrat de ce notebook
Quatre questions, chacune tranchée par une mesure et pas par un argument :
256 niveaux suffisent-ils pour les poids ? (erreur relative par couche, puis exactitude)
Granularité : quantifier chaque noyau de convolution séparément (per-channel) plutôt que le tenseur entier (per-tensor) change quoi ?
Activations : faut-il calibrer à l’avance (statique) ou mesurer au vol (dynamique) ?
Où s’arrête le déjeuner gratuit ? (INT8 puis INT4, poids et activations)
Et un algorithme complet reconstruit pas à pas : la calibration par divergence de KL (celle de TensorRT), qui choisit où couper la queue d’une distribution d’activations pour acheter de la résolution sur son corps.
import copyimport osimport timeimport numpy as npimport torchimport torch.nn as nnimport torch.nn.functional as Ffrom torchvision import datasets, transformsSEED =42torch.manual_seed(SEED)np.random.seed(SEED)DEV ="cuda"if torch.cuda.is_available() else"cpu"EPOCHS =40if DEV =="cuda"else6# recette complete sur GPU, reduite sur CPUprint(f"device={DEV} torch={torch.__version__} epochs={EPOCHS}")
device=cuda torch=2.8.0+cu126 epochs=40
1. Le vocabulaire : une seule équation
Quantifier en INT8, c’est approcher chaque flottant \(x\) par un multiple entier de pas :
\(s\) est le pas (scale) : la taille d’un niveau. Tout ce qui dépasse la plage couverte est écrêté (clipping) — c’est le vrai coût de la quantification, pas l’arrondi.
\(z\) est le point zéro (zero-point) : le code entier qui représente \(0.0\). \(z = 0\) donne la version symétrique (plage \([-128s, 127s]\)), adaptée aux poids ; \(z\) libre donne l’asymétrique, qui gaspille moins de codes sur une plage d’activations toute positive (sorties de ReLU).
Per-tensor : un \((s, z)\) pour tout le tenseur. Per-channel : un \(s\) par filtre de sortie — chaque noyau de convolution garde sa propre dynamique.
La fake quantification (fake-quant) est la manière standard de simuler l’INT8 sans kernels entiers : quantifier puis déquantiser, en restant en float32. C’est ce que fait tout ce notebook — et c’est aussi, littéralement, la première phase de l’entraînement conscient de la quantification (QAT).
QMIN, QMAX =-128, 127def qparams_tensor(t):# bornes reservees : la plage doit toujours contenir 0.0 exactement fmin =min(float(t.min()), 0.0) fmax =max(float(t.max()), 0.0) scale = (fmax - fmin) / (QMAX - QMIN) zp =int(np.clip(round(QMIN - fmin / scale) if scale >0else0, QMIN, QMAX))return scale, zpdef fakeq_tensor(t):# quantifier puis dequantiser : simuler l'INT8 en restant en float s, z = qparams_tensor(t)if s ==0:return treturn s * (torch.clamp(torch.round(t / s + z), QMIN, QMAX) - z)t = torch.tensor([-1.2, -0.4, 0.0, 0.35, 0.7, 2.9])s, z = qparams_tensor(t)codes = torch.clamp(torch.round(t / s + z), QMIN, QMAX)recon = fakeq_tensor(t)print(f"scale = {s:.5f} zero-point = {z}")for a, c, b inzip(t.tolist(), codes.tolist(), recon.tolist()):print(f" {a:+.2f} -> code {c:+6.0f} -> {b:+.4f} (erreur {b - a:+.4f})")print(f"255 codes disponibles pour couvrir [-1.2, 2.9] : pas moyen de {s:.4f}")
Le ResNet CIFAR canonique : un stem 3×3, trois étages de blocs résiduels (16, 32, 64 canaux, 3 blocs chacun = 19 convolutions + 1 linéaire). La recette d’entraînement n’est pas un détail : un optimiseur naïf (Adam à taux constant, sans augmentation) sous-entraîne le réseau et plafonne son exactitude nettement sous la barre des 90 % ; avec SGD + momentum + cosine + random crop / flip, il atteint ~0,90 (cf. la mesure FP32 mesurée plus bas dans ce notebook, FP32 = 0.9019 — sortie cellule 11 après entraînement ResNet-20 sur CIFAR-10 avec la recette SGD+momentum+cosine+augmentation). Un témoin affaiblirait faussement la conclusion « l’INT8 ne coûte rien » — il faut un réseau bien entraîné pour que la mesure soit honnête.
L’entraînement complet (40 époques) prend ~8 minutes sur GPU ; sur CPU le notebook bascule sur une recette réduite de 6 époques (témoin plus faible, mais exécutable).
L’entraînement suit la recette canonique ResNet-CIFAR — SGD avec momentum, décroissance cosmique du pas et augmentation par crops aléatoires ; c’est cette recette (et non l’architecture seule) qui décide de la qualité du témoin.
opt = torch.optim.SGD(model.parameters(), lr=0.08, momentum=0.9, weight_decay=5e-4)sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=EPOCHS)for ep inrange(EPOCHS): model.train() t0 = time.perf_counter()for x, y in train_loader: loss = F.cross_entropy(model(x.to(DEV)), y.to(DEV)) opt.zero_grad(); loss.backward(); opt.step() sched.step()if ep ==0or (ep +1) %10==0:print(f" ep {ep+1:2d}/{EPOCHS} loss={loss.item():.4f} ({time.perf_counter()-t0:.1f}s)")
  ep  1/40  loss=1.3057  (14.7s)
  ep 10/40  loss=0.4262  (14.0s)
  ep 20/40  loss=0.3638  (13.2s)
  ep 30/40  loss=0.2452  (12.7s)
  ep 40/40  loss=0.1113  (11.8s)
Le témoin se mesure sur les 10 000 images de test. La fonction evaluate ci-dessous servira telle quelle à toutes les configurations quantifiées — seule la version du réseau change.
def evaluate(m, loader): m.eval() good = tot =0with torch.no_grad():for x, y in loader: good += (m(x.to(DEV)).argmax(1).cpu() == y).sum().item() tot += y.numel()return good / totacc_fp32 = evaluate(model, test_loader)print(f"[FP32] exactitude test = {acc_fp32:.4f}")
[FP32] exactitude test = 0.9019
3. Les poids seuls en INT8
Premier étage : les poids quantifiés, les activations laissées en float. La question de la granularité se pose immédiatement. Un noyau 3×3 de 64 canaux compte 576 valeurs ; en per-tensor, une seule échelle couvre l’amplitude du plus grand filtre — les filtes modestes n’occupent alors que quelques dizaines des 255 codes. En per-channel, chaque filtre a la sienne.
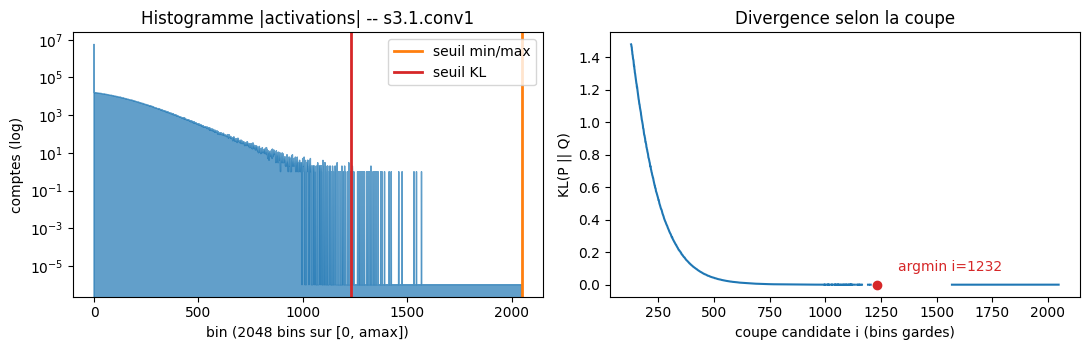
L’outil de mesure : l’erreur relative\(\|w - \hat{w}\| / \|w\|\) sur un noyau réel (ici s3.1.conv1, au cœur du dernier étage), puis l’exactitude du réseau complet aux poids remplacés par leurs versions quantifiées.
def fakeq_channel(w):# symetrique, un scale par canal de sortie (dim 0 des poids conv/linear) scale = w.reshape(w.shape[0], -1).abs().amax(dim=1).clamp(min=1e-12) /127.0 scale = scale.view([-1] + [1] * (w.dim() -1))return scale * torch.clamp(torch.round(w / scale), QMIN, QMAX)def relerr(a, b):return ((a - b).norm() / a.norm().clamp(min=1e-12)).item()def quantize_weights(ref, wmode="channel"):# deepcopy + substitution des poids par leur fake-quant m = copy.deepcopy(ref)with torch.no_grad():for mod in m.modules():ifisinstance(mod, (nn.Conv2d, nn.Linear)): w = mod.weight.detach() mod.weight.copy_(fakeq_channel(w) if wmode =="channel"else fakeq_tensor(w))return mw = model.s3[1].conv1.weight.detach()print(f"[erreur relative poids s3.1.conv1 {tuple(w.shape)}]")print(f" per-tensor : {relerr(w, fakeq_tensor(w)):.3e}")print(f" per-channel : {relerr(w, fakeq_channel(w)):.3e} ({w.shape[0]} scales au lieu d'une)")
[erreur relative poids s3.1.conv1 (64, 64, 3, 3)]
  per-tensor  : 1.052e-02
  per-channel : 7.720e-03  (64 scales au lieu d'une)
Lecture. L’erreur relative chute de ~27 % en passant au per-channel — mais l’exactitude ne bouge pas d’un dixième de point : les deux configurations sont dans le bruit de mesure. C’est la première leçon honnête de ce notebook : sur un CNN bien entraîné, la quantification INT8 des poids est essentiellement gratuite. La littérature industrielle le confirme à grande échelle ; ce n’est pas un artefact de notre mini-terrain. La discrimination entre les deux granularités existe bel et bien — mais au niveau de l’erreur numérique, pas de l’exactitude. Le réseau est robuste ; l’ingénieur qui veut une marge de sécurité prend quand même le per-channel.
4. Les activations : quantification dynamique
Les poids sont figés après l’entraînement — les quantifier est un calcul une fois pour toutes. Les activations, elles, varient à chaque exemple. La solution la plus simple, dite dynamique : calculer le pas au moment du forward, tension par tension, comme max|t| / 127. Pas de calibration, mais un calcul de maximum à chaque couche et chaque exemple — c’est le mode par défaut de la quantification dynamique de PyTorch.
L’implémentation utilise un forward pre-hook : une fonction appelée avant chaque couche ciblée, qui remplace sur place le tenseur d’entrée par sa version fake-quantifiée.
def _mk_hook_dynamic():def pre(module, inp): t = inp[0] s = t.abs().max().clamp(min=1e-12) /127.0# le pas, calcule au runtime inp[0].copy_(s * torch.clamp(torch.round(t / s), QMIN, QMAX))return predef eval_dynamic(ref, loader, wmode="channel"): qw = quantize_weights(ref, wmode) hooks = [mod.register_forward_pre_hook(_mk_hook_dynamic())for mod in qw.modules() ifisinstance(mod, (nn.Conv2d, nn.Linear))] acc = evaluate(qw, loader)for h in hooks: h.remove()return acct0 = time.perf_counter()acc_dyn_t = eval_dynamic(model, test_loader, "tensor")acc_dyn_c = eval_dynamic(model, test_loader, "channel")print(f"[dynamic : poids + activations INT8] ({time.perf_counter()-t0:.0f}s)")print(f" w per-tensor : {acc_dyn_t:.4f} ({acc_fp32-acc_dyn_t:+.4f})")print(f" w per-channel : {acc_dyn_c:.4f} ({acc_fp32-acc_dyn_c:+.4f})")
[dynamic : poids + activations INT8] (4s)
  w per-tensor  : 0.9027  (-0.0008)
  w per-channel : 0.9018  (+0.0001)
5. Calibration statique : figer les pas à l’avance
Les accélérateurs INT8 (et les kernels de convolution entiers en général) veulent des pas connus avant l’inférence — pas de maximum à calculer au vol. La calibration statique consiste à observer le réseau sur quelques centaines d’exemples non étiquetés, à mesurer la plage de chaque activation, puis à fixer les pas une fois pour toutes.
L’algorithme min/max est le plus simple : le pas couvre le maximum absolu observé. Rien n’est écrêté sur les données de calibration — mais un seul pixel exceptionnel dilate la plage et appauvrit la résolution de toute la couche. C’est ce défaut que la section suivante corrige.
Un détail de méthode : la calibration se fait sans augmentation (les crops et miroirs aléatoires n’existent pas à l’inférence) et en deux passes — la première mesure les maxima, la seconde construit les histogrammes sur une grille fixe, nécessaire pour la section KL.
NBINS, CAL_BATCHES =2048, 8def observe(nb, with_range=None):# Une passe sur les donnees de calibration (sans augmentation).# with_range=None -> amax par couche ; sinon histogramme sur la grille fixee. amaxs, hists, hooks = ({}, {}, []) train_tf = train_loader.dataset.transform train_loader.dataset.transform = tfmdef mk(name):def pre(module, inp): a = inp[0].detach().abs().flatten().float().cpu()if with_range isNone: amaxs[name] =max(amaxs.get(name, 0.0), a.max().item())else: r = with_range[name]if r >0: h, _ = torch.histogram(a, bins=NBINS, range=(0, r)) hists[name] = hists.get(name, 0) + h.numpy().astype(float)return prefor name, mod in model.named_modules():ifisinstance(mod, (nn.Conv2d, nn.Linear)): hooks.append(mod.register_forward_pre_hook(mk(name))) model.eval()with torch.no_grad():for i, (x, y) inenumerate(train_loader):if i >= nb:break model(x.to(DEV))for h in hooks: h.remove() train_loader.dataset.transform = train_tfreturn amaxs if with_range isNoneelse histstotals = observe(CAL_BATCHES) # passe 1 : amax par couchehists = observe(CAL_BATCHES, with_range=totals) # passe 2 : grille fixeprint(f"[calibration] {len(hists)} couches, {CAL_BATCHES} batchs, histogrammes {NBINS} bins")def _mk_hook_static(s):def pre(module, inp): inp[0].copy_(s * torch.clamp(torch.round(inp[0] / s), QMIN, QMAX))return predef eval_static(ref, loader, scales, wmode="channel"):# poids INT8 + activations INT8 avec les scales CALIBREES (fixees) qw = quantize_weights(ref, wmode) named =dict(qw.named_modules()) hooks = [named[n].register_forward_pre_hook(_mk_hook_static(s))for n, s in scales.items() if n in named] acc = evaluate(qw, loader)for h in hooks: h.remove()return accscales_mm = {n: a /127.0for n, a in totals.items()}t0 = time.perf_counter()acc_st_mm = eval_static(model, test_loader, scales_mm, "channel")print(f"[static min/max, w-channel] ({time.perf_counter()-t0:.0f}s) "f"{acc_st_mm:.4f} ({acc_fp32-acc_st_mm:+.4f})")
6. Calibration KL : couper la queue pour acheter de la résolution
Le min/max est optimal pour ne rien écrêter, mais dommageable pour la résolution : la queue d’une distribution d’activations est longue et presque vide — les codes entiers qu’elle occupe sont autant de pas perdus pour le corps. L’algorithme de calibration entropique de TensorRT tranche ce compromis quantitativement :
Histogramme fin (2048 bins) des valeurs absolues de l’activation, sur la grille fixée par la passe min/max.
Pour chaque coupe candidate\(i\) (de 128 à 2048 bins) :
la référence\(P\) est l’histogramme gardé \([0, i)\), avec toute la masse de la queue entassée dans le dernier bin gardé ;
le candidat\(Q\) est la version quantifiée en 128 niveaux uniformes sur \([0, i)\), puis ré-étendue : chaque bloc rend sa masse, étalée uniformément sur ses bins non vides ;
divergence \(\mathrm{KL}(P \parallel Q)\).
La coupe retenue est celle qui minimise la divergence ; le seuil est son bord droit.
Deux pièges, tous les deux instructifs, sont signalés dans le code : la queue doit peser sur \(P\)mais pas sur \(Q\) (c’est ce qui pénalise de couper trop tôt), et l’étalement ne touche que les bins non vides — un bin vide est un trou du comptage, pas un zéro de la distribution. Et quand le dernier bin gardé est vide, \(Q = 0\) là où \(P > 0\) : la divergence est \(+\infty\) et le candidat est rejeté — comportement exact de scipy.stats.entropy, qu’on reproduit explicitement.
def kl_curve(hist, nbins=NBINS, levels=128, start=128):# Port fidele de l'entropie-calibration TensorRT# (pytorch-quantization, calib/histogram.py). Renvoie KL(i) pour chaque coupe. bins = hist.astype(float).copy() bins[0] = bins[1] # quirk TensorRT : apaiser le pic du bin 0 (mort de ReLU) out = []for i inrange(start, nbins +1): digit = np.digitize(np.arange(i), np.linspace(0, i, levels +1)) -1 digit[bins[:i] ==0] =-1# piege 2 : les bins VIDES ne comptent pas keep = digit >=0 counts = np.bincount(digit[keep], minlength=levels) masses = np.bincount(digit[keep], weights=bins[:i][keep], minlength=levels) val = np.zeros(levels) nz = counts >0 val[nz] = masses[nz] / counts[nz] # masse du bloc, etalee sur ses bins non vides q = np.zeros(i) q[keep] = val[digit[keep]] p = bins[:i].copy() p[-1] += bins[i:].sum() # piege 1 : la queue va dans P, pas dans Q p = p / p.sum() q = q / q.sum()ifbool(((p >0) & (q ==0)).any()): out.append(np.inf) # scipy renverrait +inf : candidat rejetecontinue# semantique scipy (xlogy) : un bin de masse nulle contribue 0, jamais NaN m = p >0 out.append(float(np.sum(p[m] * np.log(p[m] / q[m]))))return np.array(out)def kl_threshold(hist, amax, nbins=NBINS, start=128):# dernier argmin (egalites -> seuil le plus grand), comme la reference curve = kl_curve(hist, nbins=nbins, start=start) idx =len(curve) -1-int(np.argmin(curve[::-1]))return amax * (start + idx) / nbinsscales_kl = {n: kl_threshold(h, totals[n]) /127.0for n, h in hists.items()}ratios =sorted(scales_kl[n] / scales_mm[n] for n in hists)print(f"[KL] seuil / range minmax : median {ratios[len(ratios)//2]:.0%} "f"| min {ratios[0]:.0%} | max {ratios[-1]:.0%}")print("[KL] masse coupee par couche (triée) :")rows =sorted(((n, scales_kl[n] / scales_mm[n], hists[n][int(scales_kl[n] / scales_mm[n] * NBINS):].sum() / hists[n].sum())for n in hists), key=lambda r: r[1])for n, r, m in rows[:4] + rows[-2:]:print(f" {n:<14} seuil {r:5.0%} du range masse coupee {m:6.3%}")
[KL] seuil / range minmax : median 75% | min 60% | max 100%
[KL] masse coupee par couche (triée) :
  s3.1.conv1     seuil   60% du range   masse coupee 0.000%
  s3.2.conv1     seuil   63% du range   masse coupee 0.001%
  s2.0.conv1     seuil   67% du range   masse coupee 0.001%
  s2.0.short.0   seuil   67% du range   masse coupee 0.001%
  fc             seuil   88% du range   masse coupee 0.005%
  stem           seuil  100% du range   masse coupee 0.000%
[static KL toutes couches, w-channel] 0.9012 (+0.0007)
Lecture. La calibration KL égalise le min/max (écart de 0,0005 sur ce run, dans le bruit de mesure) : en resserrant les seuils à 60-100 % du range (médiane 75 %), elle achète une résolution plus fine sur le corps des distributions — là où vit la masse — au prix d’un écrêtage de moins d’un centième de pourcent de la queue. C’est le comportement documenté de TensorRT : sur un CNN sain les deux calibrations sont interchangeables ; KL paie sur les réseaux aux activations à queue lourde.
L’aside du stem. Regardez la première ligne de la table : l’entrée du réseau choisit ~100 % du range. La raison est amusante et mesurable : l’entrée, c’est l’image normalisée — issue de pixels 8 bits, donc ~768 valeurs distinctes. Son « histogramme continu » est en réalité un peigne (la plupart des bins au-delà du corps sont vides), et la moitié des coupes candidates tombent sur un trou du peigne → \(Q = 0\) où \(P > 0\) → divergence \(+\infty\) → rejet. La calibration entropique n’a tout simplement pas de sens sur une donnée déjà discrète — dans un vrai pipeline INT8, l’entrée est quantifiée avec ses propres bornes (celles du capteur), pas calibrée par KL.
7. Où le déjeuner gratuit s’arrête : INT4
Réduisons encore : 15 codes par canal au lieu de 255 (7 niveaux positifs + signe). Les poids INT4 divisent encore la taille par deux — c’est le régime des LLM sur portables et du QLoRA rencontré dans la série FineTuning. Le même fake-quant, la même mesure :
Lecture. Voilà la falaise : 15 codes font perdre ~2,4 points, quand 255 n’en coûtaient aucun. L’erreur relative de quantification des poids monte d’un facteur ~18. La réponse industrielle à cette falaise n’est pas « plus de bits » mais l’entraînement conscient de la quantification (quantization-aware training, QAT) : quelques époques de fine-tuning où le forward passe par le fake-quant — le réseau apprend à vivre dans la grille. C’est le pont naturel vers la série PostTraining.
w_tot =sum(p.numel() for mod in model.modules()ifisinstance(mod, (nn.Conv2d, nn.Linear)) for p in mod.parameters())print(f"[taille] poids conv+fc : {w_tot:,}")print(f" FP32 : {w_tot*4/1e6:.2f} Mo INT8 : {w_tot/1e6:.2f} Mo "f"({w_tot*4/w_tot:.0f}x plus petit) INT4 : {w_tot/2e6:.2f} Mo")print()print("=== RECAPITULATIF ===")for lab, a in [("FP32", acc_fp32), ("w4 per-channel", acc_w4), ("w8 per-tensor", acc_wpt), ("w8 per-channel", acc_wpc), ("dynamic w-tensor", acc_dyn_t), ("dynamic w-channel", acc_dyn_c), ("static min/max w-channel", acc_st_mm), ("static KL w-channel", acc_st_kl)]:print(f" {lab:<26}{a:.4f} ({acc_fp32-a:+.4f})")
INT8 est essentiellement gratuit sur un CNN bien entraîné — poids et activations, per-tensor ou per-channel, dynamique ou statique : toutes les configurations tiennent dans ±0,001. Ce n’est pas la faiblesse du terrain : c’est le résultat industriel standard, et la raison pour laquelle l’INT8 est le régime par défaut du déploiement.
La discrimination existe au niveau numérique, pas au niveau de l’exactitude : per-channel divise l’erreur relative de poids par ~1,4 ; c’est la marge de sécurité de l’ingénieur, invisible dans le score.
La calibration est un compromis quantitatif : min/max n’écrête rien mais dilue la résolution ; KL coupe la queue (seuils à ~75 % du range en médiane, masse coupée < 0,01 %) pour raffiner le corps — et s’égalise au min/max sur l’exactitude.
La distribution doit être continue pour que KL ait un sens : sur l’entrée 8 bits (histogramme en peigne), la moitié des coupes sont rejetées à \(+\infty\) — l’algorithme lui-même signale le mauvais usage.
La falaise est à INT4 : ~2,4 points perdus en post-training pur, pour 8× de compression. On la repousse avec du fine-tuning (QAT), pas avec plus de bits.
Limites honnêtes. Le fake-quant simule l’arithmétique mais ne délivre ni la mémoire divisée par 4 (les tenseurs restent des float32 dont les valeurs vivent dans la grille INT8), ni l’accélération (les convolutions restent float) : les deux viennent des backends entiers (torch.quantization, TensorRT, ONNX Runtime), qui consomment exactement les \((s, z)\) calibrés ici. La calibration 8 batchs suffit sur ce réseau ; les réseaux à sorties à queue lourde (détection) sont le terrain où KL domine vraiment min/max.
Exercice 1 — Calibration par percentile
Min/max suit les outliers ; KL optimise un critère de distribution. Entre les deux, la calibration percentile : écrêter tout ce qui dépasse le p-ième percentile de la masse. À votre tour de la calibrer — puis de la comparer aux deux autres sur l’exactitude.
Objectif : écrire scales_percentile(hists, totals, p), renvoyant le même format que scales_mm. Question : à p = 99,9 %, tombe-t-on côté min/max ou côté KL ?
def scales_percentile(hists, totals, p=99.9):# TODO etudiant : renvoyer {nom: scale} ou le seuil est le p-ieme percentile# de l'histogramme de la couche (masse cumulee p%), pas le max absolu.# Indice : np.cumsum(hist) / hist.sum() donne la masse cumulee bin par bin.# Etape 1 : construire la cumsum normalisee.# Etape 2 : trouver le premier bin ou elle depasse p (np.searchsorted).# Etape 3 : convertir en seuil (amax * bin / NBINS) puis en scale (/ 127).returnNone# TODO etudiantscales_p999 = scales_percentile(hists, totals, p=99.9)if scales_p999 isnotNone: acc_p999 = eval_static(model, test_loader, scales_p999, "channel")print(f"[static percentile 99.9, w-channel] {acc_p999:.4f} ({acc_fp32-acc_p999:+.4f})")print(f" (a comparer : min/max {acc_st_mm:.4f}, KL {acc_st_kl:.4f})")else:print("Exercice a completer")
Exercice a completer
Exercice 2 — KL à 64 niveaux
La calibration KL dépend du nombre de niveaux de la grille cible. Refaites la recherche pour une cible 64 niveaux sur la couche fc et comparez le seuil choisi. Question : le seuil monte-t-il ou descend-il, et pourquoi ? (Indice : moins de niveaux = chaque niveau compte plus… la réponse n’est pas intuitive avant de l’avoir mesurée.)
def kl_threshold_64(hist, amax, nbins=NBINS):# TODO etudiant : meme recherche que kl_threshold, mais la cible de# quantification a 64 niveaux (levels=64) au lieu de 128.# Indice : kl_curve accepte levels= en parametre.# Etape 1 : appel de kl_curve avec la bonne cible.# Etape 2 : recuperer le DERNIER argmin (egalites -> seuil le plus grand).returnNone# TODO etudiantt64 = kl_threshold_64(hists["fc"], totals["fc"])if t64 isnotNone: t128 = kl_threshold(hists["fc"], totals["fc"])print(f"fc : seuil KL 128 niveaux = {t128:.4f} | 64 niveaux = {t64:.4f} "f"({t64/t128:.0%})")else:print("Exercice a completer")
Exercice a completer
Exercice 3 — Sensibilité par étage
Toutes les couches ne souffrent pas également de la quantification. Le diagnostic classique : appliquer la quantification statique à un étage à la fois (les autres en FP32) et classer les étages par chute d’exactitude — c’est la layer-wise sensitivity analysis, qui décide où investir en précision mixte.
Objectif : écrire sensibilite_par_etage(scales) renvoyant {etage: exactitude} pour s1, s2, s3. Question : la dégradation est-elle uniforme, ou un étage concentre-t-il la sensibilité ?
def sensibilite_par_etage(scales, stages=("s1", "s2", "s3")):# TODO etudiant : pour chaque etage, evaluer l'exactitude avec la quantification# statique appliquee a CET ETAGE SEUL (les autres couches en FP32).# Renvoyer {etage: exactitude}.# Indice : eval_static accepte un dict de scales -- donnez-lui seulement les# couches de l'etage : {n: s for n, s in scales.items() if n.startswith(etage)}.# Etape 1 : filtrer les scales de l'etage.# Etape 2 : appeler eval_static avec ce sous-ensemble.# Etape 3 : boucler sur les trois etages.returnNone# TODO etudiantsens = sensibilite_par_etage(scales_mm)if sens isnotNone:for st, a insorted(sens.items()):print(f" {st} seul : {a:.4f} ({acc_fp32-a:+.4f})")else:print("Exercice a completer")
Série PostTraining : la version industrielle de ce notebook — vraies représentations INT8/INT4, kernels quantifiés, QAT.
Série FineTuning (FT-00a) : le QLoRA y rencontre la falaise INT4 de la section 7 — et l’utilise.
Environnement : kernel python3 (torch + torchvision + matplotlib). L’entraînement complet exige un GPU (~8 min sur RTX 3090) ; sur CPU le notebook s’exécute avec une recette réduite (6 époques).