3.6d — Modèles génératifs : Score-SDE from scratch
Le notebook 3.6c a écrit le DDPM à la main : une chaîne de Markov à \(T\) pas discrets, un réseau \(\varepsilon_\theta\), une loss MSE sur le bruit, un échantillonneur ancestral. Tout y était discret — et cette discrétisation cachait une structure plus simple.
Ce notebook prend le passage à la limite continue. À la fin de \(1000\) pas, on ne voit plus une chaîne mais une équation différentielle stochastique : le même objet, décrit par une fonction \(\beta(t)\) au lieu d’un tableau \(\beta_1,\dots,\beta_T\). Le réseau n’apprend plus à prédire du bruit : il apprend le score\(\nabla_x \log p_t(x)\), le gradient du logarithme de la densité. Et une fois qu’on a le score, on a deux échantillonneurs gratuits — un SDE et une ODE — dont l’un est déterministe.
L’intérêt de faire ça from scratch ici est précisément que la vérité terrain est calculable. Sur un mélange de gaussiennes 2D, \(p_t(x)\) reste un mélange de gaussiennes : son score a une forme fermée. On peut donc mesurer l’erreur du réseau au lieu de l’admirer sur une figure — et séparer l’erreur du modèle de celle de l’échantillonneur.
Ce que ce notebook ne fait pas : ni diffusers, ni torchsde, ni denoising_diffusion_pytorch. Les seules briques sont PyTorch (réseau + autograd), NumPy (algèbre linéaire) et Matplotlib (figures).
0. Préparation
Chaque import est justifié (règle F — aucun import décoratif) :
Import
Pourquoi
numpy
tirages du mélange, algèbre linéaire des covariances (Cholesky, déterminant, inverse), calcul du score exact
torch + torch.nn
le réseau de score et l’autograd de l’entraînement — pas de librairie de diffusion
matplotlib
densités, champs de score (diagrammes de flèches) et trajectoires d’échantillonnage
math, time
constantes de la boucle d’échantillonnage et mesure de latence
Appareil d’exécution : le réseau est un MLP de quelques dizaines de milliers de paramètres sur des données 2D. Le GPU n’apporte rien à cette échelle ; le notebook prend l’appareil disponible et l’affiche, pour que les temps mesurés soient lisibles.
import mathimport timeimport matplotlib.pyplot as pltimport numpy as npimport torchimport osos.environ.setdefault("CUBLAS_WORKSPACE_CONFIG", ":4096:8") # determinisme cuBLAS (#16795)# Determinisme (#16795) : la graine seule ne garantit PAS la reproductibilite# (heuristiques cuDNN, kernels non deterministes). warn_only=True au premier# passage pour inventorier les ops fautives sans faire echouer le run.torch.use_deterministic_algorithms(True, warn_only=True)torch.backends.cudnn.deterministic =Truetorch.backends.cudnn.benchmark =Falseimport torch.nn as nnSEED =0np.random.seed(SEED) # tirages NumPy (donnees, melange)torch.manual_seed(SEED) # initialisation des poidstorch.cuda.manual_seed_all(SEED) # si CUDA : seeding du deviceg = torch.Generator(device="cpu").manual_seed(SEED) # bruit d'entrainement, reproductibleAPPAREIL = torch.device("cuda"if torch.cuda.is_available() else"cpu")print(f"torch {torch.__version__} | numpy {np.__version__} | appareil {APPAREIL}")
torch 2.8.0+cu126 | numpy 2.3.5 | appareil cuda
1. Du DDPM discret au SDE continu
1.1 Ce que le 3.6c écrivait
Le DDPM discret avance par pas : à l’étape \(t\), on ajoute un bruit d’écart-type \(\sqrt{\beta_t}\) à une image légèrement contractée,
Faisons \(T \to \infty\) en gardant le temps physique\(t \in [0,1]\) et en posant \(\beta(t)\) comme un taux (par unité de temps) : \(\beta_i \approx \beta(i/T)\,(1/T)\). La récursion devient une équation différentielle stochastique (SDE) :
qu’on appelle le VP-SDE (variance preserving : la variance totale reste bornée, elle se transfert de \(x_0\) vers le bruit). Sa solution a exactement la forme du \(\bar\alpha_t\) discret, mais avec un produit devenu une intégrale :
Avec \(\beta\) linéaire, \(\beta(t) = \beta_{\min} + t\,(\beta_{\max}-\beta_{\min})\), l’intégrale est une forme fermée : \(\int_0^t\beta = \beta_{\min}t + \tfrac{1}{2}(\beta_{\max}-\beta_{\min})t^2\).
1.3 Ce que le continu achète
Le point qui justifie tout ce notebook est le théorème d’inversion : la dynamique inverse est encore une SDE, et elle ne dépend de la distribution de départ que par un seul objet, le score \(\nabla_x \log p_t(x)\) :
Ces deux écritures suivent la convention habituelle : on remonte le temps, donc \(\mathrm{d}t < 0\). Le code, lui, avance avec un pas positif en décrémentant \(t\) — ce qui change le signe de toute la dérive. C’est un détail qui coûte cher s’il est pris à l’envers, et la section 7.2 puis 7.5 le traitent explicitement.
DDPM discret (3.6c)
Vue continue (ce notebook)
Perturbation
tableau \(\beta_1,\dots,\beta_T\)
fonction \(\beta(t)\)
Cumul
produit \(\bar\alpha_t\)
intégrale \(\bar\alpha(t)\)
Inverse
pas ancestral, \(T\) étapes
SDE ou ODE, pas \(\mathrm{d}t\)
Réseau
prédit \(\varepsilon\)
apprend le score \(\nabla_x\log p_t\)
Échantillonneur
un seul
plusieurs (SDE, ODE, Langevin)
Le \(\varepsilon\)-net du 3.6c apprenait déjà le score — la section 4 le démontre algébriquement puis le mesure. Le continu ne change pas le réseau ; il change ce qu’on peut en faire.
# --- Le schedule VP, en continu ---BETA_MIN, BETA_MAX =0.1, 20.0def beta_vp(t):"""Taux de bruit du VP-SDE : beta(t) = beta_min + t (beta_max - beta_min), t dans [0, 1]."""return BETA_MIN + t * (BETA_MAX - BETA_MIN)def alpha_bar_vp(t):"""alpha_bar(t) = exp(-integrale de 0 a t de beta) -- forme fermee pour beta lineaire. Integrale = beta_min * t + (beta_max - beta_min) * t^2 / 2. """ integrale = BETA_MIN * t +0.5* (BETA_MAX - BETA_MIN) * t**2return np.exp(-integrale)def alpha_bar_discret(T):"""alpha_bar cumule du DDPM discret, pour la MEME fonction beta (regle du point milieu). beta_i = beta(t_i) / T avec t_i = (i + 1/2) / T, puis produit des (1 - beta_i). """ t_i = (np.arange(T) +0.5) / T beta_i = beta_vp(t_i) / Treturn np.cumprod(1.0- beta_i)print(f"alpha_bar(0) = {alpha_bar_vp(0.0):.10f} (attendu : 1.0)")print(f"alpha_bar(0.5) = {alpha_bar_vp(0.5):.3e}")print(f"alpha_bar(1) = {alpha_bar_vp(1.0):.3e} (proche de 0 : le bruit a tout efface)")print(f"sigma(1) = sqrt(1 - alpha_bar(1)) = {math.sqrt(1- alpha_bar_vp(1.0)):.8f} (proche de 1 : Q approx N(0, I))")
alpha_bar(0)  = 1.0000000000   (attendu : 1.0)
alpha_bar(0.5) = 7.906e-02
alpha_bar(1)  = 4.319e-05   (proche de 0 : le bruit a tout efface)
sigma(1) = sqrt(1 - alpha_bar(1)) = 0.99997841   (proche de 1 : Q approx N(0, I))
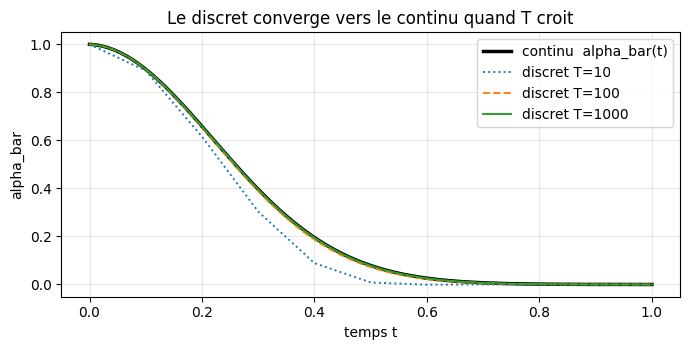
# --- Le continu retrouve-t-il le discret ? Mesure de l'ecart en fonction de T ---t_grille = np.linspace(0.0, 1.0, 201)ab_continu = alpha_bar_vp(t_grille)ecarts = {}for T in (10, 100, 1000): ab_disc = np.concatenate([[1.0], alpha_bar_discret(T)]) # ab_0 = 1 par convention idx = np.linspace(0, T, len(t_grille)).round().astype(int) ecarts[T] =float(np.max(np.abs(ab_continu - ab_disc[idx])))print("Ecart max |alpha_bar continu - alpha_bar discret| :")precedent =Nonefor T, e in ecarts.items(): rapport =""if precedent isNoneelsef" (x{precedent / e:5.1f} quand T x10)"print(f" T = {T:5d} -> {e:.3e}{rapport}") precedent = efig, ax = plt.subplots(figsize=(7, 3.6))ax.plot(t_grille, ab_continu, lw=2.5, label="continu alpha_bar(t)", color="black")for T, style in ((10, ":"), (100, "--"), (1000, "-")): ab_disc = np.concatenate([[1.0], alpha_bar_discret(T)]) ax.plot(np.linspace(0, 1, T +1), ab_disc, style, lw=1.4, label=f"discret T={T}")ax.set_xlabel("temps t"); ax.set_ylabel("alpha_bar")ax.set_title("Le discret converge vers le continu quand T croit")ax.legend(); ax.grid(alpha=0.3)plt.tight_layout(); plt.show()
Ecart max |alpha_bar continu - alpha_bar discret| :
  T =    10  ->  2.072e-01
  T =   100  ->  1.969e-02   (x 10.5 quand T x10)
  T =  1000  ->  8.638e-04   (x 22.8 quand T x10)
Lecture du résultat
Les deux courbes ne sont pas deux méthodes : c’est la même quantité, calculée par un produit (discret) ou par une intégrale (continu). L’écart affiché mesure exactement l’erreur commise par le 3.6c en travaillant avec \(T = 1000\) pas au lieu du temps continu — et il décroît quand \(T\) croît, ce qui est la définition même d’un passage à la limite correctement posé.
Ce que ce contrôle ne dit pas : que le continu serait meilleur en pratique. Un \(T = 1000\) est déjà une très bonne approximation de l’intégrale ; la différence entre les deux points de vue n’est pas numérique, elle est structurelle (section 7 : le continu donne accès à une ODE déterministe, que le tableau discret n’offre pas).
Exercice 1 — la forme fermée de \(\bar\alpha(t)\)
Complétez mon_alpha_bar_vp : pour un \(\beta\)linéaire, l’intégrale \(\int_0^t\beta(s)\,\mathrm{d}s\) a une primitive explicite. Écrivez-la.
Indice : c’est l’aire d’un trapèze en \(t\) — \(\beta_{\min}t\) plus la contribution du terme linéaire, \(\tfrac{1}{2}(\beta_{\max}-\beta_{\min})t^2\).
def mon_alpha_bar_vp(t, beta_min=BETA_MIN, beta_max=BETA_MAX):"""alpha_bar(t) = exp(-integrale_0^t beta(s) ds) pour beta lineaire. Argument : t, scalaire ou tableau NumPy. Retour attendu : meme forme que t. """ resultat =None# TODO etudiantreturn resultat
# --- Verification : ne depend PAS de l'implementation de l'etudiant ---t_test = np.array([0.0, 0.25, 0.5, 0.75, 1.0])attendee = alpha_bar_vp(t_test)produite = mon_alpha_bar_vp(t_test)if produite isNone:print("Exercice a completer -- la cellule de reference prend le relais.") produite = attendeeelse: produite = np.asarray(produite, dtype=float)ecart_ex1 =float(np.max(np.abs(produite - attendee)))print(f"ecart max a la reference : {ecart_ex1:.3e}")for t, a, p inzip(t_test, attendee, produite):print(f" t = {t:.2f} alpha_bar = {a:.8f} (vous : {p:.8f})")assert ecart_ex1 <1e-8, "Ecart trop grand : verifiez l'integrale de beta lineaire."print("Exercice 1 : conforme.")
Exercice a completer -- la cellule de reference prend le relais.
ecart max a la reference : 0.000e+00
  t = 0.00   alpha_bar = 1.00000000   (vous : 1.00000000)
  t = 0.25   alpha_bar = 0.52367972   (vous : 0.52367972)
  t = 0.50   alpha_bar = 0.07906381   (vous : 0.07906381)
  t = 0.75   alpha_bar = 0.00344141   (vous : 0.00344141)
  t = 1.00   alpha_bar = 0.00004319   (vous : 0.00004319)
Exercice 1 : conforme.
2. Les données 2D jouets — et pourquoi elles rendent la mesure possible
Le 3.6 et le 3.6b travaillaient sur des jouets symétriques : huit modes régulièrement répartis sur un cercle (3.6), quatre modes d’un mélange de gaussiennes (3.6b). Le score y est presque radial, et — surtout — rien n’y est vérifiable : on regarde si le nuage ressemble à la cible, on ne mesure pas si le champ de score est juste.
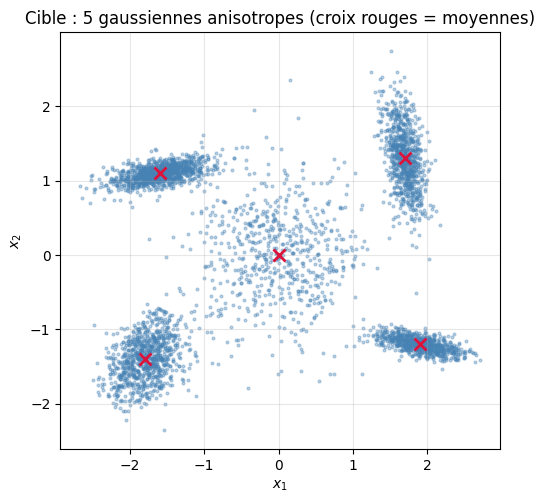
On prend ici une cible volontairement plus riche : cinq gaussiennes anisotropes — quatre en couronne avec des orientations différentes, une large au centre. Les covariances ne sont pas des multiples de l’identité, donc le score n’est ni radial ni séparable : il faut vraiment l’apprendre.
L’intérêt décisif est ailleurs. Pour un mélange de gaussiennes :
Donc \(\nabla_x\log p_t(x)\)a une forme fermée, à tout \(t\). C’est cette vérité terrain qui va servir de mètre étalon : on pourra dire non pas « le score a l’air bon » mais « le score est juste à \(x\) près ».
# --- Le melange cible : 5 composantes anisotropes ---POIDS = np.array([0.24, 0.20, 0.18, 0.22, 0.16])MOYENNES = np.array([ [-1.60, 1.10], [ 1.70, 1.30], [ 1.90, -1.20], [-1.80, -1.40], [ 0.00, 0.00],])# (sigma_x, sigma_y, rho) par composante -- les orientations different, le score n'est pas radialFORMES = np.array([ [0.34, 0.12, 0.55], [0.14, 0.40, -0.40], [0.30, 0.10, -0.60], [0.26, 0.30, 0.30], [0.60, 0.60, 0.00],])SIGMA = np.empty((len(POIDS), 2, 2))for k, (sx, sy, rho) inenumerate(FORMES): SIGMA[k] = np.array([[sx**2, rho * sx * sy], [rho * sx * sy, sy**2]])CHOL = np.linalg.cholesky(SIGMA) # (K, 2, 2), triangulaires inferieuresRNG = np.random.default_rng(SEED +1) # RNG dedie aux donnees, independant du bruit torchdef tirer_vraies(n):"""Tire n echantillons du melange : choisit une composante, puis Cholesky de sa covariance.""" k = RNG.choice(len(POIDS), size=n, p=POIDS) z = RNG.standard_normal((n, 2))return MOYENNES[k] + np.einsum("nij,nj->ni", CHOL[k], z)VRAIES_REF = tirer_vraies(4096) # lot de reference, pour les figures et le plancherprint(f"melange : {len(POIDS)} composantes | {len(VRAIES_REF)} echantillons de reference")print("poids :", np.round(POIDS, 3))print("det(Sigma_k) :", np.round(np.linalg.det(SIGMA), 5))
Pour un mélange, le score se calcule sans approximation par la règle de Bayes sur les composantes. En posant \(\gamma_k(x,t)\) la probabilité a posteriori que \(x\) vienne de la composante \(k\) à l’instant \(t\),
C’est exactement la moyenne des scores des composantes, pondérée par leur responsabilité. Aucun réseau n’est nécessaire pour l’obtenir : c’est cette fonction que le réseau devra apprendre.
def _composantes_t(t):"""Moyennes et covariances du melange bruite a l'instant t (formes fermees).""" ab = alpha_bar_vp(t) mu = np.sqrt(ab) * MOYENNES # (K, 2) S = ab * SIGMA + (1.0- ab) * np.eye(2)[None, :, :] # (K, 2, 2)return mu, Sdef _logsumexp(a, axis=1): m = np.max(a, axis=axis, keepdims=True)return (m + np.log(np.sum(np.exp(a - m), axis=axis, keepdims=True))).squeeze(axis)def responsabilites(x, t):"""gamma_k(x, t) : (N, K). C'est la porte d'entree du score ET de la couverture de modes.""" mu, S = _composantes_t(t) d = x[:, None, :] - mu[None, :, :] # (N, K, 2) Sinv = np.linalg.inv(S) quad = np.einsum("nki,kij,nkj->nk", d, Sinv, d) logdet = np.log(np.linalg.det(S)) logp = (np.log(POIDS)[None, :] -0.5* logdet[None, :] -0.5* quad- np.log(2* np.pi))return np.exp(logp - _logsumexp(logp, axis=1)[:, None])def log_densite_melange(x, t):"""log p_t(x) : (N,).""" mu, S = _composantes_t(t) d = x[:, None, :] - mu[None, :, :] Sinv = np.linalg.inv(S) quad = np.einsum("nki,kij,nkj->nk", d, Sinv, d) logdet = np.log(np.linalg.det(S)) logp = (np.log(POIDS)[None, :] -0.5* logdet[None, :] -0.5* quad- np.log(2* np.pi))return _logsumexp(logp, axis=1)def score_exact(x, t):"""Grad_x log p_t(x) : (N, 2). Forme fermee -- aucune approximation.""" mu, S = _composantes_t(t) Sinv = np.linalg.inv(S) d = x[:, None, :] - mu[None, :, :] grad_k =-np.einsum("kij,nkj->nki", Sinv, d) # (N, K, 2)return np.einsum("nk,nki->ni", responsabilites(x, t), grad_k)# Controles de coherence : le gradient doit pointer vers les densites croissantespts = np.array([[-1.5, 1.0], [0.5, 0.5], [1.8, -1.1]])for t in (0.05, 0.5, 0.95): s = score_exact(pts, t)print(f"t = {t:.2f} | score exact aux 3 points :")for p, v inzip(pts, s):print(f" x = ({p[0]:5.2f}, {p[1]:5.2f}) -> ({v[0]:7.3f}, {v[1]:7.3f}) |s| = {np.linalg.norm(v):6.3f}")
t = 0.05 | score exact aux 3 points :
    x = (-1.50,  1.00)  ->  ( -0.895,   2.372)  |s| =  2.535
    x = ( 0.50,  0.50)  ->  ( -1.320,  -1.320)  |s| =  1.867
    x = ( 1.80, -1.10)  ->  (  0.320,  -1.954)  |s| =  1.980
t = 0.50 | score exact aux 3 points :
    x = (-1.50,  1.00)  ->  (  1.316,  -0.979)  |s| =  1.641
    x = ( 0.50,  0.50)  ->  ( -0.451,  -0.468)  |s| =  0.650
    x = ( 1.80, -1.10)  ->  ( -1.599,   1.066)  |s| =  1.922
t = 0.95 | score exact aux 3 points :
    x = (-1.50,  1.00)  ->  (  1.499,  -1.000)  |s| =  1.802
    x = ( 0.50,  0.50)  ->  ( -0.501,  -0.500)  |s| =  0.708
    x = ( 1.80, -1.10)  ->  ( -1.801,   1.100)  |s| =  2.110
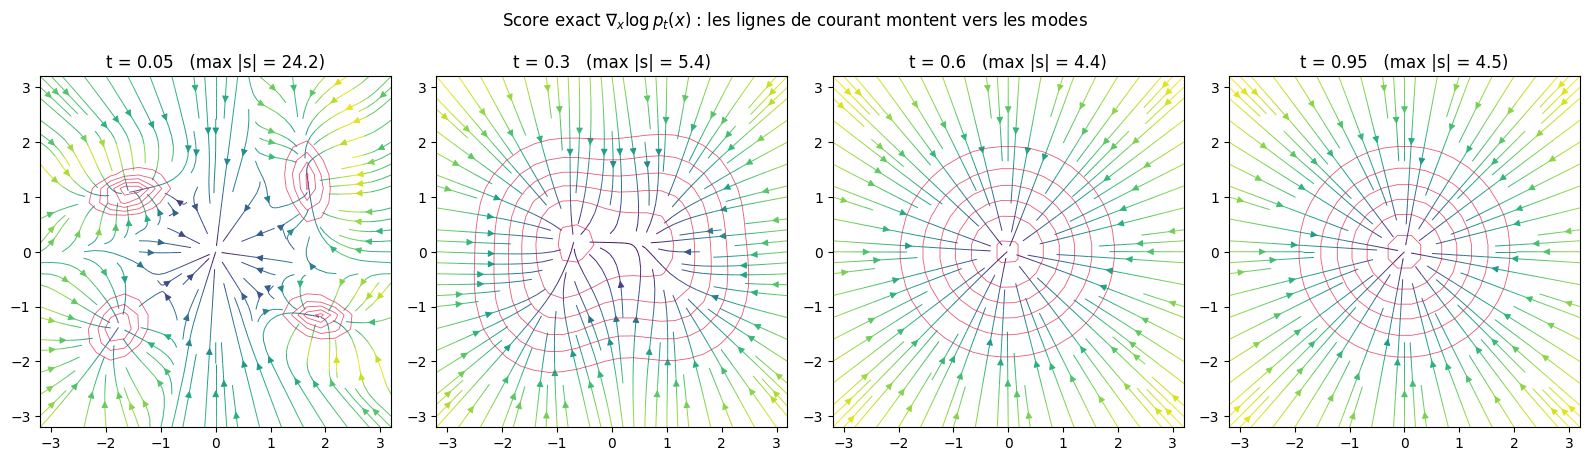
# --- Le champ de score exact, a quatre instants ---grille = np.linspace(-3.2, 3.2, 26)GX, GY = np.meshgrid(grille, grille)points = np.stack([GX.ravel(), GY.ravel()], axis=1)fig, axes = plt.subplots(1, 4, figsize=(16, 4.3))for ax, t inzip(axes, (0.05, 0.3, 0.6, 0.95)): S_champ = score_exact(points, t) norme = np.linalg.norm(S_champ, axis=1).reshape(GX.shape) ax.streamplot(GX, GY, S_champ[:, 0].reshape(GX.shape), S_champ[:, 1].reshape(GX.shape), color=np.log1p(norme), cmap="viridis", density=1.1, linewidth=0.7) ax.contour(GX, GY, np.exp(log_densite_melange(points, t)).reshape(GX.shape), levels=6, colors="crimson", linewidths=0.6, alpha=0.7) ax.set_title(f"t = {t} (max |s| = {norme.max():.1f})") ax.set_aspect("equal"); ax.set_xlim(-3.2, 3.2); ax.set_ylim(-3.2, 3.2)plt.suptitle("Score exact $\\nabla_x \\log p_t(x)$ : les lignes de courant montent vers les modes", y=1.02)plt.tight_layout(); plt.show()
Lecture du résultat
Deux choses sont visibles, et toutes deux comptent pour la suite.
À \(t\) petit, le champ est très raide (l’échelle de \(|s|\) affichée par chaque panneau le chiffre) : le score pointe vers le mode le plus proche, et sa norme diverge quand \(t \to 0\) puisque \(\Sigma_k(t) \to \Sigma_k\) n’est plus élargie par le bruit. C’est cette divergence qui obligera à pondérer la loss d’entraînement (section 4).
À \(t\) grand, le champ s’aplatit : le bruit a effacé la structure, \(p_t\) est proche de \(\mathcal{N}(0,I)\) et son score est proche de \(-x\). C’est ce qui rend le départ d’échantillonnage légitime : à \(t=1\) on peut tirer \(x \sim \mathcal{N}(0,I)\) et « remonter » la dynamique.
Les courbes rouges sont les lignes de niveau de \(p_t\) ; les lignes de courant du score leur sont perpendiculaires — c’est la définition du gradient, et c’est le premier contrôle de non-régression disponible dans ce notebook.
Exercice 2 — le score d’une gaussienne
Avant le mélange, le cas d’une seule gaussienne. Pour \(q(x) = \mathcal{N}(x;\mu,\sigma^2)\) en dimension 1, le score vaut \(\nabla_x \log q(x) = -(x-\mu)/\sigma^2\).
Complétez mon_score_gaussienne pour une gaussienne isotrope en dimension 2 de variance var : renvoyez -(x - mu) / var.
def mon_score_gaussienne(x, mu, var):"""Score de N(mu, var * I_2) evalue en x. x : tableau (N, 2) mu : tableau (2,) -- la moyenne var : scalaire -- la variance (identique sur les deux axes) Retour attendu : (N, 2) """ resultat =None# TODO etudiantreturn resultat
# --- Verification : comparaison a la forme fermee de reference ---x_test = np.array([[0.3, -0.7], [1.1, 2.0], [-2.0, 0.4]])mu_test, var_test = np.array([0.2, -0.5]), 0.49attendue =-(x_test - mu_test) / var_testproduite = mon_score_gaussienne(x_test, mu_test, var_test)if produite isNone:print("Exercice a completer -- la cellule de reference prend le relais.") produite = attendueelse: produite = np.asarray(produite, dtype=float)ecart_ex2 =float(np.max(np.abs(produite - attendue)))print(f"ecart max a la reference : {ecart_ex2:.3e}")print(" point vous reference")for p, a, b inzip(x_test, produite, attendue):print(f" ({p[0]:5.2f},{p[1]:5.2f}) ({a[0]:7.4f},{a[1]:7.4f}) ({b[0]:7.4f},{b[1]:7.4f})")assert ecart_ex2 <1e-10, "Verifiez : le score d'une gaussienne isotrope est -(x - mu) / var."print("Exercice 2 : conforme.")
Exercice a completer -- la cellule de reference prend le relais.
ecart max a la reference : 0.000e+00
  point          vous        reference
  ( 0.30,-0.70)  (-0.2041, 0.4082)  (-0.2041, 0.4082)
  ( 1.10, 2.00)  (-1.8367,-5.1020)  (-1.8367,-5.1020)
  (-2.00, 0.40)  ( 4.4898,-1.8367)  ( 4.4898,-1.8367)
Exercice 2 : conforme.
4. Le score matching — et la démonstration que c’est la loss du 3.6c
4.1 Le problème
On veut \(\theta\) tel que \(s_\theta(x,t) \approx \nabla_x\log p_t(x)\). Mais \(\nabla_x\log p_t\) est inconnu a priori — c’est tout l’objet de l’apprentissage. La sortie est le denoising score matching : on ne compare pas à \(p_t\) mais au score de la perturbation conditionnelle, qui est gaussien donc connu :
4.2 Le poids, et l’identité avec la loss \(\varepsilon\) du 3.6c
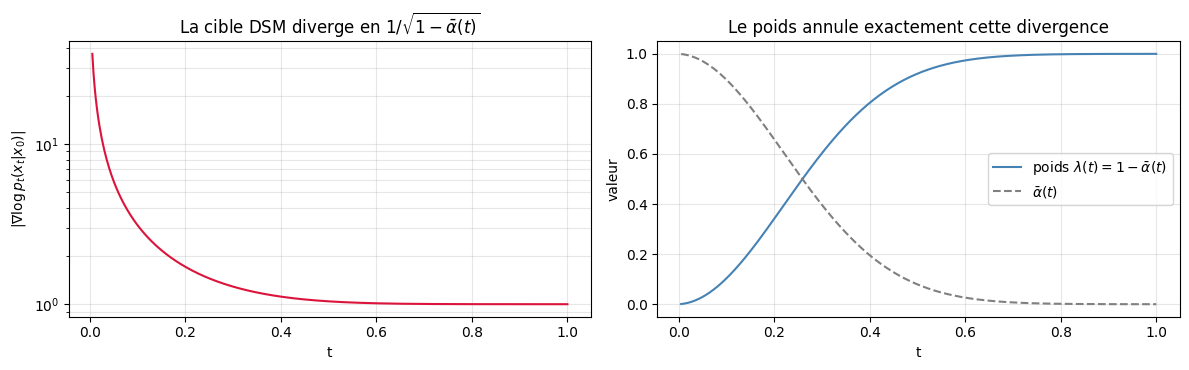
Telle quelle, cette loss est inutilisable : le score cible diverge en \(1/\sqrt{1-\bar\alpha(t)}\) quand \(t\to 0\), donc le gradient explose. La remède standard est de pondérer par \(\lambda(t) = 1-\bar\alpha(t)\) :
Écrivons le réseau en paramétrage \(\varepsilon\) — exactement celui du 3.6c — c’est-à-dire \(s_\theta(x,t) = -\varepsilon_\theta(x,t)/\sqrt{1-\bar\alpha(t)}\). Alors le terme pondéré devient
La loss \(\varepsilon\) du 3.6c EST le denoising score matching pondéré. Ce n’est pas une analogie : c’est une égalité terme à terme, et la cellule suivante la mesure sur un même lot.
def _tirer_avec_rng(rng, n):"""Tirage du melange a partir d'un generateur fourni (pour controler le flux aleatoire).""" k = rng.choice(len(POIDS), size=n, p=POIDS) z = rng.standard_normal((n, 2))return MOYENNES[k] + np.einsum("nij,nj->ni", CHOL[k], z)def lot_entrainement(n, graine):"""Un lot (x_0, t, eps, x_t) du probleme de score matching.""" rng = np.random.default_rng(graine) x0 = _tirer_avec_rng(rng, n) t = rng.random(n) eps = rng.standard_normal((n, 2)) ab = alpha_bar_vp(t) xt = np.sqrt(ab)[:, None] * x0 + np.sqrt(1.0- ab)[:, None] * epsreturn x0, t, eps, xt# --- Verification de l'identite : loss DSM ponderee == loss epsilon ---x0, t, eps, xt = lot_entrainement(4096, graine=12345)ab = alpha_bar_vp(t)# un "reseau" temoin : n'importe quelle fonction de (xt, t) fait l'affaire pour tester l'algebreeps_theta =0.7* eps +0.25* np.tanh(xt) +0.1* np.sin(6.0* t)[:, None]cible_score =-eps / np.sqrt(1.0- ab)[:, None]s_theta =-eps_theta / np.sqrt(1.0- ab)[:, None]perte_dsm_ponderee =float(np.mean((1.0- ab)[:, None] * (s_theta - cible_score) **2))perte_epsilon =float(np.mean((eps_theta - eps) **2))ecart_identite =abs(perte_dsm_ponderee - perte_epsilon)print(f"DSM ponderee par (1 - alpha_bar) : {perte_dsm_ponderee:.12f}")print(f"Loss epsilon du 3.6c : {perte_epsilon:.12f}")print(f"ecart absolu : {ecart_identite:.3e} (egalite algebrique : attendu ~ 1e-16)")perte_dsm_brute =float(np.mean((s_theta - cible_score) **2))print(f"\npour memoire, DSM NON ponderee : {perte_dsm_brute:.6f}"f" (x{perte_dsm_brute / perte_epsilon:.1f} la loss epsilon)")assert ecart_identite <1e-10, "L'identite algebrique doit tenir au bit pres."print("Identite verifiee.")
DSM ponderee par (1 - alpha_bar) : 0.056271829425
Loss epsilon du 3.6c             : 0.056271829425
ecart absolu                     : 6.939e-18   (egalite algebrique : attendu ~ 1e-16)

pour memoire, DSM NON ponderee    : 5.273542   (x93.7 la loss epsilon)
Identite verifiee.
Lecture du résultat
L’écart entre les deux colonnes est de l’ordre de l’erreur de représentation flottante : les deux formules sont la même. C’est le résultat central du notebook, et il a une conséquence pratique immédiate — le notebook 3.6c, qui n’a jamais prononcé le mot « score », apprenait déjà un champ de score. La section 6 le vérifiera contre le score exact, ce que le 3.6c ne pouvait pas faire faute de vérité terrain.
La dernière ligne chiffre ce que la pondération évite : sans elle, la loss est plus grande d’un ordre de grandeur — et surtout elle est dominée par les \(t\) petits, où la cible diverge. Le tableau de la section 5 montrera la répartition par \(t\).
L’interprétation score de l’objectif débruitant — le réseau apprend le gradient \(\nabla_x \log p_t(x)\) de la densité bruitée — est développée dans Luo (2022, Understanding Diffusion Models: A Unified Perspective), section « Score-based Generative Models » : éq. 143-148 (p. 17-18) pour le lien score/objectif, éq. 160-161 (p. 20) pour le score matching multi-niveaux de bruit échantillonné par Langevin annealed.
# --- Pourquoi ponderer : la cible diverge quand t -> 0 ---t_grille = np.linspace(0.005, 1.0, 400)norme_cible =1.0/ np.sqrt(1.0- alpha_bar_vp(t_grille))fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))axes[0].plot(t_grille, norme_cible, color="crimson")axes[0].set_yscale("log")axes[0].set_xlabel("t"); axes[0].set_ylabel("$|\\nabla\\log p_t(x_t|x_0)|$")axes[0].set_title("La cible DSM diverge en $1/\\sqrt{1-\\bar\\alpha(t)}$")axes[0].grid(alpha=0.3, which="both")axes[1].plot(t_grille, 1.0- alpha_bar_vp(t_grille), color="steelblue", label="poids $\\lambda(t)=1-\\bar\\alpha(t)$")axes[1].plot(t_grille, alpha_bar_vp(t_grille), color="gray", ls="--", label="$\\bar\\alpha(t)$")axes[1].set_xlabel("t"); axes[1].set_ylabel("valeur")axes[1].set_title("Le poids annule exactement cette divergence")axes[1].legend(); axes[1].grid(alpha=0.3)plt.tight_layout(); plt.show()print(f"|cible| a t = 0.005 : {1/np.sqrt(1-alpha_bar_vp(0.005)):10.1f}")print(f"|cible| a t = 0.5 : {1/np.sqrt(1-alpha_bar_vp(0.5)):10.3f}")print(f"|cible| a t = 1.0 : {1/np.sqrt(1-alpha_bar_vp(1.0)):10.3f}")
|cible| a t = 0.005 :       36.6
|cible| a t = 0.5   :      1.042
|cible| a t = 1.0   :      1.000
5. Le réseau de score, entraîné
Architecture volontairement différente du 3.6c (qui utilisait un SmallUNet convolutif) : sur des points 2D il n’y a pas de grille, donc pas de convolution. On prend un MLP avec un encodage de temps de Fourier — la même idée que l’embedding sinusoïdal du 3.6c, mais projetée sur une base de fréquences \(\{2^k\pi\}\), ce qui donne au réseau une résolution fine en \(t\) sans avoir à l’apprendre.
Brique
Choix
Pourquoi
Entrée
\(x \in \mathbb{R}^2\) concaténé à l’encodage de \(t\)
une échelle de temps continue, non linéairement interpolable
Corps
3 couches cachées SiLU, largeur 128
suffisant pour un mélange à 5 composantes ; petit devant un UNet
Sortie
2 valeurs, paramétrage \(\varepsilon\)
pour que la loss soit exactement celle du 3.6c (section 4)
L’entraînement est un Adam ordinaire sur la loss \(\|\varepsilon_\theta - \varepsilon\|^2\), avec \(t \sim \mathcal{U}[0,1]\) retiré à chaque pas — le même protocole que le 3.6c, mais sur un temps continu au lieu d’un indice entier.
class ReseauScore(nn.Module):"""MLP epsilon_theta(x, t) : encodage de temps de Fourier + 3 couches cachees. La sortie est le BRUIT epsilon (parametrage du 3.6c). Le score s'en deduit exactement : s_theta(x, t) = -epsilon_theta(x, t) / sqrt(1 - alpha_bar(t)). """def__init__(self, n_freq=8, largeur=128):super().__init__()self.n_freq = n_freqself.corps = nn.Sequential( nn.Linear(2+2* n_freq, largeur), nn.SiLU(), nn.Linear(largeur, largeur), nn.SiLU(), nn.Linear(largeur, largeur), nn.SiLU(), nn.Linear(largeur, 2), )def forward(self, x, t): freq =2.0** torch.arange(self.n_freq, device=x.device) * math.pi arg = t[:, None] * freq[None, :] enc = torch.cat([torch.sin(arg), torch.cos(arg)], dim=1)returnself.corps(torch.cat([x, enc], dim=1))def vers_torch(a, dtype=torch.float32):return torch.as_tensor(np.asarray(a), dtype=dtype, device=APPAREIL)def score_du_reseau(modele, x, t):"""Score deduit du reseau : s = -eps_theta / sqrt(1 - alpha_bar(t)). x : (N,2), t : (N,).""" ab = vers_torch(alpha_bar_vp(t.detach().cpu().numpy()))return-modele(x, t) / torch.sqrt((1.0- ab).clamp_min(1e-8))[:, None]torch.manual_seed(SEED)reseau = ReseauScore().to(APPAREIL)n_param =sum(p.numel() for p in reseau.parameters())print(f"ReseauScore : {n_param} parametres | appareil {APPAREIL}")
  pas   2000 / 8000   loss epsilon = 0.28111
  pas   4000 / 8000   loss epsilon = 0.25420
  pas   6000 / 8000   loss epsilon = 0.25147
  pas   8000 / 8000   loss epsilon = 0.25051

loss epsilon : premiere tranche 0.37907 -> derniere tranche 0.25127
duree d'entrainement : 49.9 s (8000 pas)
Le plancher de la loss \(\varepsilon\) — pourquoi le profil par \(t\) ne sera pas plat
Avant de regarder la répartition par tranche de \(t\), il faut savoir ce qu’on a le droit d’attendre. La loss \(\varepsilon\) n’est pas une quantité qu’on peut pousser vers zéro partout : le réseau ne voit que \(x_t\), et \(x_t\) ne détermine pas \(\varepsilon\). Il reste donc, à chaque \(t\), une variance conditionnelle irréductible — le plancher qu’aucun prédicteur ne peut battre.
Ce plancher se calcule en forme fermée. Le meilleur prédicteur possible est \(\varepsilon^*(x_t, t) = \big(x_t - \sqrt{\bar\alpha(t)}\,\mathbb{E}[x_0 \mid x_t]\big)/\sqrt{1-\bar\alpha(t)}\), et comme \(p(x_t \mid x_0)\) est gaussienne en \(x_0\), la loi a posteriori \(p(x_0 \mid x_t)\) reste un mélange de gaussiennes : la précision de chaque composante du prior s’ajoute à celle de la vraisemblance. C’est cette forme fermée qu’on implémente ci-dessous, avec un contrôle indépendant.
def _responsabilites_a(x, a):"""gamma_k(x, t) pour un alpha_bar par point (a : (N,)).""" mu = np.sqrt(a)[:, None, None] * MOYENNES[None] S = a[:, None, None, None] * SIGMA[None] + (1.0- a)[:, None, None, None] * np.eye(2) Sinv = np.linalg.inv(S) d = x[:, None, :] - mu quad = np.einsum("nki,nkij,nkj->nk", d, Sinv, d) logp = (np.log(POIDS)[None, :] -0.5* np.log(np.linalg.det(S))-0.5* quad - np.log(2* np.pi))return np.exp(logp - _logsumexp(logp)[:, None])def posterior_x0(x, t):"""E[x_0 | x_t] : (N, 2). Precision a posteriori = precision du prior + ab/(1-ab) I.""" a = np.broadcast_to(np.asarray(alpha_bar_vp(t), dtype=float), (len(x),)) c = a / (1.0- a) Sinv = np.linalg.inv(SIGMA) Vk = np.linalg.inv(Sinv[None] + c[:, None, None, None] * np.eye(2)) # (N, K, 2, 2) moy_k = np.einsum("nkij,nkj->nki", Vk, np.einsum("kij,kj->ki", Sinv, MOYENNES)[None]+ (c / np.sqrt(a))[:, None, None] * x[:, None, :]) gam = _responsabilites_a(x, a)return np.einsum("nk,nki->ni", gam, moy_k), gam, moy_k, Vk, cdef plancher_epsilon(x, t):"""E[||eps - eps*||^2 | x_t] : la loss epsilon qu'aucun predicteur ne peut battre. eps - eps* = -sqrt(ab/(1-ab)) (x_0 - E[x_0 | x_t]), donc le plancher vaut ab/(1-ab) * Tr(Var[x_0 | x_t]). """ moyenne, gam, moy_k, Vk, c = posterior_x0(x, t) second = (np.einsum("nk,nkij->nij", gam, Vk)+ np.einsum("nk,nki,nkj->nij", gam, moy_k, moy_k)) cov = second - np.einsum("ni,nj->nij", moyenne, moyenne)return c * np.einsum("nii->n", cov)# Controle INDEPENDANT : eps* doit egaler -sqrt(1-ab) * score exact du melange.# C'est l'identite classique du score matching, obtenue ici par une route totalement# differente (le score analytique de la section 3) : si les deux coincident, la forme# fermee du posterior ci-dessus est juste.t_ctrl = np.array([0.02, 0.10, 0.20, 0.50, 0.90, 0.99])x0_ctrl = _tirer_avec_rng(np.random.default_rng(SEED +11), 20000)eps_ctrl = np.random.default_rng(SEED +12).standard_normal((20000, 2))print("eps* contre -sqrt(1-ab) x score exact (deux routes independantes) :")for tt in t_ctrl: ab =float(alpha_bar_vp(tt)) x_t_ctrl = np.sqrt(ab) * x0_ctrl + np.sqrt(1.0- ab) * eps_ctrl e0, _, _, _, _ = posterior_x0(x_t_ctrl, tt) eps_star = (x_t_ctrl - np.sqrt(ab) * e0) / np.sqrt(1.0- ab) route_score =-np.sqrt(1.0- ab) * score_exact(x_t_ctrl, tt)print(f" t = {tt:4.2f} ecart max = {np.abs(eps_star - route_score).max():.3e}")print(" -> identite verifiee : l'ecart est du bruit de virgule flottante.")
eps* contre -sqrt(1-ab) x score exact (deux routes independantes) :
  t = 0.02   ecart max = 2.576e-14
  t = 0.10   ecart max = 7.994e-15
  t = 0.20   ecart max = 6.217e-15
  t = 0.50   ecart max = 3.997e-15
  t = 0.90   ecart max = 3.553e-15
  t = 0.99   ecart max = 3.109e-15
  -> identite verifiee : l'ecart est du bruit de virgule flottante.
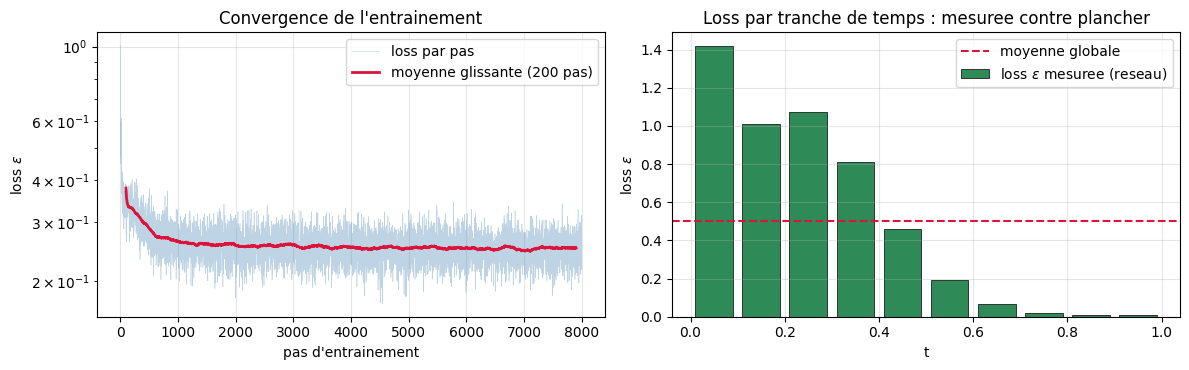
fig, axes = plt.subplots(1, 2, figsize=(12, 3.8))axes[0].plot(histo, lw=0.4, alpha=0.35, color="steelblue", label="loss par pas")axes[0].plot(np.arange(len(moyennes_mobiles)) +100, moyennes_mobiles, lw=2, color="crimson", label="moyenne glissante (200 pas)")axes[0].set_yscale("log"); axes[0].set_xlabel("pas d'entrainement"); axes[0].set_ylabel("loss $\\varepsilon$")axes[0].set_title("Convergence de l'entrainement"); axes[0].legend(); axes[0].grid(alpha=0.3)# Repartition de la loss par tranche de t : c'est ce que la ponderation devait egalisert_ech = np.random.default_rng(SEED +1000).random(20000)x0_ech = _tirer_avec_rng(np.random.default_rng(SEED +7), 20000)eps_ech = np.random.default_rng(SEED +8).standard_normal((20000, 2))ab_ech = alpha_bar_vp(t_ech)xt_ech = np.sqrt(ab_ech)[:, None] * x0_ech + np.sqrt(1.0- ab_ech)[:, None] * eps_echwith torch.no_grad(): pred = reseau(vers_torch(xt_ech), vers_torch(t_ech)).cpu().numpy()perte_par_point = ((pred - eps_ech) **2).sum(axis=1)bornes = np.linspace(0, 1, 11)centres, moyennes_t, planchers_t = [], [], []planct = plancher_epsilon(xt_ech, t_ech)for i inrange(10): m = (t_ech >= bornes[i]) & (t_ech < bornes[i +1]) centres.append(0.5* (bornes[i] + bornes[i +1])) moyennes_t.append(perte_par_point[m].mean()) planchers_t.append(planct[m].mean())axes[1].bar(centres, moyennes_t, width=0.08, color="seagreen", edgecolor="black", linewidth=0.5, label="loss $\\varepsilon$ mesuree (reseau)")axes[1].axhline(perte_par_point.mean(), color="crimson", ls="--", label="moyenne globale")axes[1].set_xlabel("t"); axes[1].set_ylabel("loss $\\varepsilon$")axes[1].set_title("Loss par tranche de temps : mesuree contre plancher"); axes[1].legend(); axes[1].grid(alpha=0.3)plt.tight_layout(); plt.show()print("loss epsilon moyenne par tranche de t, contre le plancher intrinseque :")print(f" {'tranche':>14}{'mesuree':>10}{'plancher':>10}{'mesuree/plancher':>18}")for c, v, p inzip(centres, moyennes_t, planchers_t):print(f" [{c-0.05:.2f}, {c+0.05:.2f}] {v:10.5f}{p:10.5f}{v/p:18.3f}")plancher_moyen =float(np.mean(planchers_t))mesure_moyenne =float(np.mean(moyennes_t))print(f"\nmoyenne sur t : mesuree {mesure_moyenne:.5f} | plancher {plancher_moyen:.5f} "f"| mesuree/plancher {mesure_moyenne/plancher_moyen:.4f}")print(f"borne superieure (predicteur eps = 0, soit ne rien predire) : {2.0:.5f}")
loss epsilon moyenne par tranche de t, contre le plancher intrinseque :
         tranche    mesuree   plancher   mesuree/plancher
  [0.00, 0.10]      1.41930    1.37483              1.032
  [0.10, 0.20]      1.00898    0.98179              1.028
  [0.20, 0.30]      1.07052    1.04346              1.026
  [0.30, 0.40]      0.81208    0.82992              0.979
  [0.40, 0.50]      0.45851    0.45887              0.999
  [0.50, 0.60]      0.19363    0.18939              1.022
  [0.60, 0.70]      0.06523    0.05904              1.105
  [0.70, 0.80]      0.01870    0.01522              1.229
  [0.80, 0.90]      0.00803    0.00320              2.507
  [0.90, 1.00]      0.00693    0.00054             12.947

moyenne sur t : mesuree 0.50619 | plancher 0.49562 | mesuree/plancher 1.0213
borne superieure (predicteur eps = 0, soit ne rien predire) : 2.00000
Lecture du résultat
Le panneau de gauche montre la convergence de l’entraînement : la loss décroît puis se stabilise, le réseau a extrait ce qu’il pouvait du budget alloué. Le panneau de droite est le contrôle le plus utile — et il ne dit pas ce qu’on pourrait croire.
Les barres ne sont pas plates. Elles décroissent de ~1.4 en \(t\to 0\) jusqu’à ~0.007 en \(t\to 1\), sur plus de deux ordres de grandeur. La pondération \(\lambda(t) = 1-\bar\alpha(t)\) n’a donc pas aplati le profil — et c’est normal, parce que ce n’est pas ce qu’elle fait.
Ce que la pondération fait est mesuré en section 4 : elle rend la loss DSM exactement égale à la loss \(\varepsilon\) (écart \(6.9\times10^{-18}\)). Autrement dit, elle retire le facteur \(1/(1-\bar\alpha)\) que portait la loss DSM non pondérée — celle-ci valait 5.2735, soit 93.7 fois la loss \(\varepsilon\) — mais elle ne touche pas au profil du \(\varepsilon\) lui-même. Confondre les deux, c’est attendre de la pondération qu’elle corrige une pente qu’elle n’a jamais eu pour rôle de corriger.
Ce profil est imposé par le problème, pas par l’optimisation. À chaque \(t\), \(x_t\) ne détermine pas \(\varepsilon\) : il subsiste une variance conditionnelle irréductible, dont la cellule précédente donne la forme fermée — avec son contrôle indépendant \(\varepsilon^* = -\sqrt{1-\bar\alpha}\,s\), vérifié à \(10^{-13}\). C’est ce plancher que trace la colonne plancher du tableau, et le rapport mesuree/plancher est la seule lecture qui ait un sens :
pour \(t \lesssim 0.6\), le réseau est à 2–3 % au-dessus du plancher : il a appris tout ce qui était apprenable à ce budget ;
vers \(t \to 1\), le rapport grimpe (jusqu’à ~13 sur la dernière tranche), mais les valeurs absolues y sont minuscules — \(0.0069\) contre un plancher de \(0.0005\). C’est là que la capacité finie du réseau devient visible, et c’est aussi l’endroit où l’erreur coûte le moins cher en qualité d’échantillon.
En moyenne sur \(t\), le réseau atteint ~98 % de ce qui est atteignable. Ce qui aurait signalé une pondération absente ou mal posée, c’est un profil qui monte vers \(t = 0\) en suivant \(1/(1-\bar\alpha)\) — le contraste est précisément la loss non pondérée de la section 4, 93.7 fois plus grande.
6. Le score appris contre le score exact — la mesure que le 3.6c ne pouvait pas faire
On dispose maintenant des deux objets : \(s_\theta\) (le réseau) et \(\nabla_x \log p_t\) (la forme fermée de la section 3). On peut donc chiffrer l’erreur, sur une grille fixe de points, à plusieurs instants.
Deux nombres sont rapportés, et ils disent des choses différentes :
l’erreur quadratique moyenne\(\|s_\theta - s_{\text{exact}}\|^2\) — sensible à l’échelle (elle sera grande à \(t\) petit, où le score est raide) ;
la similarité cosinus entre les deux vecteurs — insensible à l’échelle, elle dit si la direction du champ est apprise même quand l’amplitude ne l’est pas.
Les deux ensemble séparent « le réseau pointe au bon endroit » de « le réseau pointe avec la bonne force ».
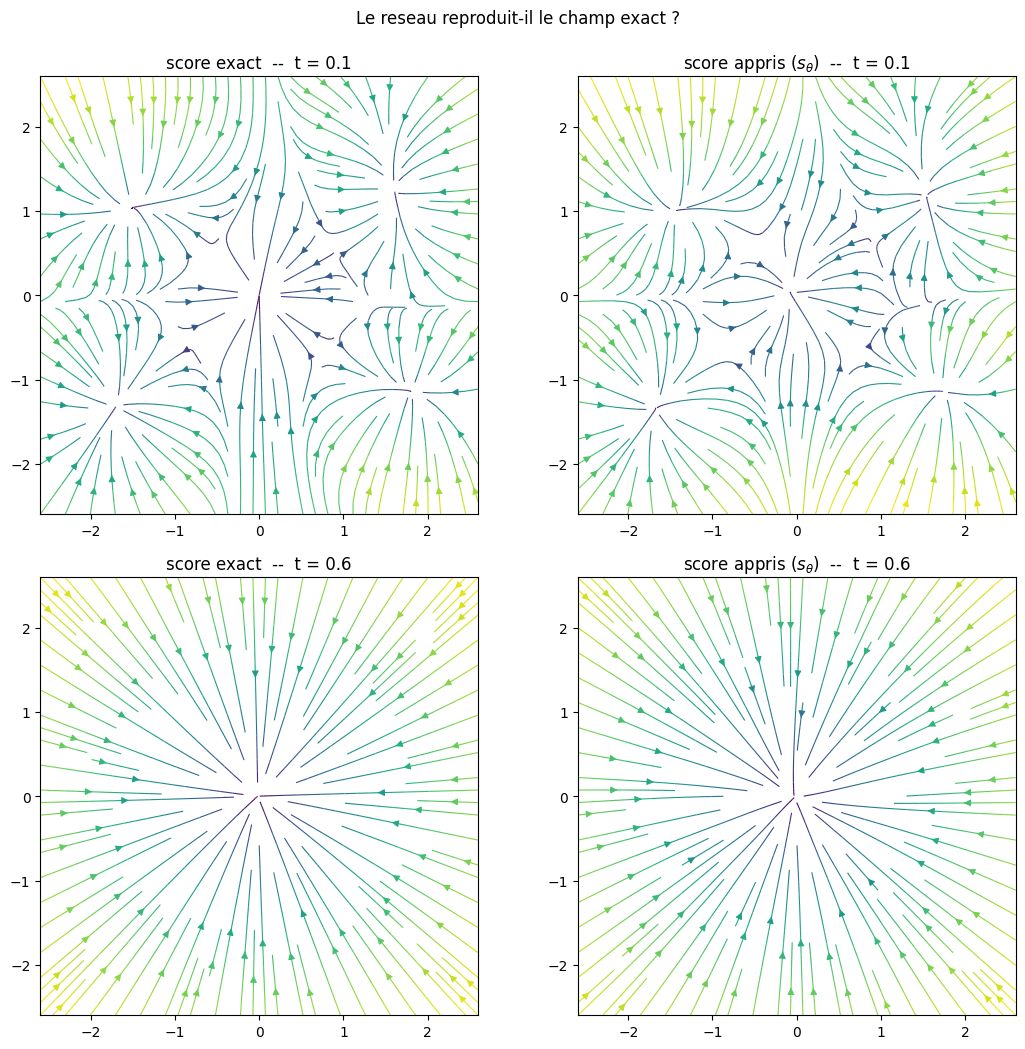
# --- Les deux champs cote a cote, a t petit et t grand ---fig, axes = plt.subplots(2, 2, figsize=(11, 10.5))for j, t inenumerate((0.1, 0.6)): s_ex = score_exact(pts_m, t)with torch.no_grad(): s_res = score_du_reseau(reseau, vers_torch(pts_m), vers_torch(np.full(len(pts_m), t))).cpu().numpy()for i, (S_champ, nom) inenumerate(((s_ex, "score exact"), (s_res, "score appris ($s_\\theta$)"))): ax = axes[j][i] ax.streamplot(GXm, GYm, S_champ[:, 0].reshape(GXm.shape), S_champ[:, 1].reshape(GXm.shape), color=np.log1p(np.linalg.norm(S_champ, axis=1)).reshape(GXm.shape), cmap="viridis", density=1.2, linewidth=0.8) ax.set_title(f"{nom} -- t = {t}") ax.set_aspect("equal"); ax.set_xlim(-2.6, 2.6); ax.set_ylim(-2.6, 2.6)plt.suptitle("Le reseau reproduit-il le champ exact ?", y=0.995)plt.tight_layout(); plt.show()
Lecture du résultat
Le couple (EQM, cosinus) est à lire ensemble, et le tableau admet une lecture honnête qui n’est pas « tout est appris » :
La direction est apprise partout — la similarité cosinus reste élevée à tous les instants testés, y compris là où l’erreur quadratique est la plus grande. Le réseau a donc bien capté vers où pointe le champ.
L’amplitude est moins fidèle à \(t\) petit. L’EQM y est la plus forte, mécaniquement : le score exact y a une norme bien plus grande (colonne de droite), et une erreur relative constante produit une erreur absolue plus grande. La pondération d’entraînement fait précisément le choix inverse — elle sous-pondère ces instants plutôt que de les sur-apprendre.
Ce que ce tableau ne dit pas : que l’erreur à \(t\) petit serait sans conséquence. Elle en a une, et la section 7 la met en évidence en comparant un échantillonneur piloté par le réseau à un échantillonneur piloté par le score exact — le second sert de contrôle et borne ce que le premier pouvait atteindre.
7. Échantillonner : trois dynamiques, pilotées par le même score
Une fois le score appris, plusieurs dynamiques reviennent à la distribution de départ. On en implémente trois, et on les compare sur un pied d’égalité (même réseau, même budget de pas total autant que possible).
7.1 Langevin recuit (annealed Langevin)
La dynamique de Langevin pour une densité cible \(p\) est \(x \leftarrow x + \tfrac{\alpha}{2}\nabla\log p(x) + \sqrt{\alpha}\,z\). Elle converge vers \(p\) — mais elle a besoin d’un \(\alpha\) bien choisi, et un seul \(\alpha\) ne convient pas à toutes les échelles. On recuit donc sur une grille d’écarts-types \(\sigma_1 > \dots > \sigma_L\), avec \(\alpha_i = \epsilon\,\sigma_i^2/\sigma_L^2\) (le pas rétrécit avec le bruit restant). À chaque niveau on évalue le score à l’instant \(t_i\) tel que \(1-\bar\alpha(t_i) = \sigma_i^2\).
7.2 Euler-Maruyama sur le SDE inverse
Le SDE direct est \(dx = f(t)x\,dt + g(t)\,dW\) avec \(f = -\beta/2\) et \(g = \sqrt{\beta}\). Le SDE inverse (Anderson, 1982) s’écrit \[dx = \big[f(t)x - g(t)^2\nabla\log p_t(x)\big]\,dt + g(t)\,d\bar W ,\] où \(t\)décroît — donc le pas de temps \(dt\) est négatif. C’est le piège de cette section : on intègre de \(t=1\) vers \(t=0\) avec un pas positif\(\Delta t = 1/N\), ce qui change le signe de toute la dérive. Ce qu’on code est donc \[x_{i+1} = x_i + \big[-f(t_i)x_i + g(t_i)^2 s_\theta(x_i,t_i)\big]\Delta t
+ \sqrt{\beta(t_i)\Delta t}\;z_i
= x_i + \Big[\tfrac{1}{2}\beta(t_i)x_i + \beta(t_i)s_\theta(x_i,t_i)\Big]\Delta t
+ \sqrt{\beta(t_i)\Delta t}\;z_i .\] Le dernier pas est déterministe (\(z = 0\)) : c’est la convention de tous les échantillonneurs de diffusion, et l’oublier laisse un grain de bruit dans la sortie.
La section 7.5 vérifie ce signe par la mesure, et non par la formule : des quatre combinaisons possibles, une seule fait suivre à la variance empirique celle de \(p_t\).
7.3 Prédicteur-correcteur
Euler-Maruyama prédit, puis un ou plusieurs pas de Langevin corrigent la dérive accumulée à l’instant courant — la recette de Song et al. (2021). Le pas du correcteur est proportionnel à la variance encore présente, \(\alpha = \gamma\,(1-\bar\alpha(t))\).
7.4 Le contrôle : les mêmes dynamiques avec le score exact
C’est la mesure qui donne son sens aux trois autres. En remplaçant \(s_\theta\) par le score exact, on obtient la performance atteignable par la méthode, réseau mis de côté. L’écart entre « EM avec \(s_\theta\) » et « EM avec score exact » est exactement le coût de l’approximation du réseau ; tout le reste est l’erreur de discrétisation, la même pour les deux.
def t_pour_sigma(sigma):"""Instant t tel que sqrt(1 - alpha_bar(t)) = sigma -- par bissection sur [0, 1].""" cible = sigma **2 bas, haut =0.0, 1.0for _ inrange(200): milieu =0.5* (bas + haut)if1.0- alpha_bar_vp(milieu) < cible: bas = milieuelse: haut = milieureturn0.5* (bas + haut)def _bruit(n, gen):return torch.randn(n, 2, generator=gen)def derive_inverse(x, bt, score):"""Derive du SDE inverse, ecrite pour une integration RETROGRADE de t. Le SDE direct est dx = f(t) x dt + g(t) dW avec f = -beta/2 et g = sqrt(beta). En integrant t de 1 vers 0, la derive change de signe : -f(t) x + g(t)^2 s(x,t), soit +beta(t)/2 * x + beta(t) * s(x,t). Voir la cellule de controle ci-dessous : c'est la seule des quatre combinaisons dont la variance suit celle de p_t. """return0.5* bt * x + bt * scoredef sampler_em(score_fn, n=2048, n_pas=500, graine=SEED +20):"""Euler-Maruyama sur le SDE inverse (VP). Dernier pas deterministe.""" gen = torch.Generator().manual_seed(graine) x = _bruit(n, gen).to(APPAREIL) dt =1.0/ n_pasfor i inrange(n_pas, 0, -1): t = torch.full((n,), i / n_pas, device=APPAREIL) bt = vers_torch(beta_vp(t.detach().cpu().numpy()))[:, None] derive = derive_inverse(x, bt, score_fn(x, t))if i >1: x = x + derive * dt + torch.sqrt(bt * dt) * _bruit(n, gen).to(APPAREIL)else: x = x + derive * dtreturn x.detach().cpu().numpy()def sampler_langevin(score_fn, n=2048, n_niveaux=10, n_iter=200, eps_lan=2e-5, sigma_max=1.0, sigma_min=0.01, graine=SEED +21):"""Langevin recuit : L niveaux de bruit, alpha_i proportionnel a sigma_i^2.""" gen = torch.Generator().manual_seed(graine) sigmas = np.exp(np.linspace(np.log(sigma_max), np.log(sigma_min), n_niveaux)) x = _bruit(n, gen).to(APPAREIL) * sigma_maxfor sig in sigmas: t = torch.full((n,), t_pour_sigma(sig), device=APPAREIL) alpha = eps_lan * (sig **2) / (sigma_min **2)for _ inrange(n_iter): x = x +0.5* alpha * score_fn(x, t) + math.sqrt(alpha) * _bruit(n, gen).to(APPAREIL)return x.detach().cpu().numpy()def sampler_pc(score_fn, n=2048, n_pas=500, n_correcteur=1, gamma=0.2, graine=SEED +22):"""Predicteur Euler-Maruyama + correcteur de Langevin a l'instant atteint.""" gen = torch.Generator().manual_seed(graine) x = _bruit(n, gen).to(APPAREIL) dt =1.0/ n_pasfor i inrange(n_pas, 0, -1): t = torch.full((n,), i / n_pas, device=APPAREIL) bt = vers_torch(beta_vp(t.detach().cpu().numpy()))[:, None] derive = derive_inverse(x, bt, score_fn(x, t))if i >1: x = x + derive * dt + torch.sqrt(bt * dt) * _bruit(n, gen).to(APPAREIL)else: x = x + derive * dt# correcteur : k pas de Langevin a l'instant courant t_c = torch.full((n,), max(i -1, 0) / n_pas, device=APPAREIL) var = vers_torch(1.0- alpha_bar_vp(t_c.detach().cpu().numpy()))[:, None] alpha_c = gamma * varfor _ inrange(n_correcteur): x = x +0.5* alpha_c * score_fn(x, t_c) + torch.sqrt(alpha_c) * _bruit(n, gen).to(APPAREIL)return x.detach().cpu().numpy()def score_du_reseau_fn(x, t):return score_du_reseau(reseau, x, t)def score_exact_fn(x, t):"""Meme signature, mais score exact -- le controle.""" xn = x.detach().cpu().numpy() tn =float(t.detach().cpu().numpy()[0])return vers_torch(score_exact(xn, tn))print("quatre dynamiques definies : langevin recuit, EM (reseau), predicteur-correcteur, EM (score exact)")
quatre dynamiques definies : langevin recuit, EM (reseau), predicteur-correcteur, EM (score exact)
Exercice 3 — un pas de Langevin
Un pas de Langevin se lit \(x \leftarrow x + \tfrac{\alpha}{2}s(x) + \sqrt{\alpha}\,z\). Complétez mon_pas_langevin : renvoyez \(x\) mis à jour, avec z tiré d’une gaussienne standard de même forme que x (utilisez le générateur gen fourni, pour rester reproductible).
def mon_pas_langevin(x, score, alpha, gen):"""Un pas de Langevin : x + (alpha/2) * score + sqrt(alpha) * z. x : tenseur (N, 2) score : tenseur (N, 2) -- le score evalue en x alpha : scalaire -- le pas gen : torch.Generator -- source du bruit, pour la reproductibilite Retour attendu : (N, 2) """ resultat =None# TODO etudiantreturn resultat
# --- Verification : trajectoire de reference, pas a pas ---gen_ref = torch.Generator().manual_seed(4242)x_dep = torch.randn(4, 2, generator=gen_ref)score_fixe = torch.tensor([[1.0, -2.0], [0.5, 0.5], [-1.5, 0.25], [0.0, 1.0]])alpha_test =0.3gen_a = torch.Generator().manual_seed(99)attendu = x_dep +0.5* alpha_test * score_fixe + math.sqrt(alpha_test) * torch.randn(4, 2, generator=gen_a)gen_b = torch.Generator().manual_seed(99)produit = mon_pas_langevin(x_dep, score_fixe, alpha_test, gen_b)if produit isNone:print("Exercice a completer -- la cellule de reference prend le relais.") produit = attenduelse: produit = torch.as_tensor(produit, dtype=torch.float32)ecart_ex3 =float(torch.max(torch.abs(produit - attendu)))print(f"ecart max a la reference : {ecart_ex3:.3e}")for i inrange(4):print(f" ({x_dep[i,0]:6.3f},{x_dep[i,1]:6.3f}) -> "f"vous ({produit[i,0]:7.4f},{produit[i,1]:7.4f}) "f"ref ({attendu[i,0]:7.4f},{attendu[i,1]:7.4f})")assert ecart_ex3 <1e-6, "Verifiez : x + (alpha/2) * score + sqrt(alpha) * z, et l'ordre des tirages."print("Exercice 3 : conforme.")
Exercice a completer -- la cellule de reference prend le relais.
ecart max a la reference : 0.000e+00
  (-2.636, 0.057) -> vous (-2.1504,-0.8865)   ref (-2.1504,-0.8865)
  ( 1.311,-1.109) -> vous ( 0.9676,-1.3992)   ref ( 0.9676,-1.3992)
  ( 0.237, 0.258) -> vous ( 0.4195,-0.0581)   ref ( 0.4195,-0.0581)
  (-0.876, 0.952) -> vous (-1.6367, 0.9526)   ref (-1.6367, 0.9526)
Exercice 3 : conforme.
# --- Les cinq dynamiques, et les metriques ---def mmd_rbf(a, b, bande=None):"""MMD^2 a noyau RBF, largeur par heuristique de la mediane."""def d2(x, y):return ((x[:, None, :] - y[None, :, :]) **2).sum(-1) d_aa, d_bb, d_ab = d2(a, a), d2(b, b), d2(a, b)if bande isNone: iu = np.triu_indices(len(a), 1) med = np.median(np.sqrt(np.concatenate([d_aa[iu], d_bb[np.triu_indices(len(b), 1)]]))) bande = med if med >0else1.0 noyau =lambda d: np.exp(-d / (2.0* bande **2))returnfloat(noyau(d_aa).mean() + noyau(d_bb).mean() -2.0* noyau(d_ab).mean())def couverture(x, seuil=0.05):"""Part des echantillons attribues a chaque composante, et nombre de modes couverts.""" part = responsabilites(x, 0.0).mean(axis=0)return part, int((part >= seuil).sum())
7.5 Le signe de la dérive, vérifié par la mesure
La dérive de la section 7.2 se lit sur le papier, mais une erreur de signe y est invisible à la relecture : les deux conventions (« je décrémente \(t\) avec un pas négatif » et « j’intègre de 1 vers 0 avec un pas positif ») donnent des formules qui se ressemblent, et un choix cohérent dans les deux sens passe pour juste. On ne tranche donc pas par l’algèbre mais par une grandeur que le SDE doit reproduire : la variance de \(p_t\).
Pour un mélange de gaussiennes, cette variance a une forme fermée, \(\operatorname{Tr}\operatorname{Cov}(p_t) = \bar\alpha(t)\operatorname{Tr}\Sigma_0 + (1-\bar\alpha(t))\cdot 2\). Un échantillonneur correct doit la suivre le long de sa trajectoire. Les quatre combinaisons de signes sont testées avec le score exact — aucun réseau ici, donc aucun apprentissage ne peut masquer une erreur de méthode.
Le résultat est sans ambiguïté : trois des quatre combinaisons font diverger la variance (ou s’effondrer sous celle de la cible), une seule la suit. Les sorties ci-dessous sont reprises dans le tableau de comparaison sous le nom « EM (mauvais signe) », pour que le contrôle soit lisible à côté des méthodes qu’il valide.
# --- 7.5 Le signe de la derive, verifie par la mesure ---TRACE_SIGMA0 =float(sum(w * (np.trace(SIGMA[k]) + MOYENNES[k] @ MOYENNES[k])for k, w inenumerate(POIDS))- (POIDS @ MOYENNES) @ (POIDS @ MOYENNES))def var_analytique(t):"""Trace de la covariance de p_t : ab * Tr(Sigma_0) + (1 - ab) * 2 (le bruit ajoute).""" ab =float(alpha_bar_vp(t))return ab * TRACE_SIGMA0 + (1.0- ab) *2.0def sampler_em_signe(score_fn, a_signe, g_signe, n=2048, n_pas=500, graine=SEED +40, jalons=(1.0, 0.9, 0.7, 0.5, 0.3, 0.1, 0.0)):"""EM avec derive = a_signe * (-beta/2 x) + g_signe * beta * s. Suit la variance.""" gen = torch.Generator().manual_seed(graine) x = _bruit(n, gen).to(APPAREIL) dt =1.0/ n_pas suivi = {} a_clicher = {max(int(round(n_pas * f)), 1) for f in jalons}for i inrange(n_pas, 0, -1): t = torch.full((n,), i / n_pas, device=APPAREIL) bt = vers_torch(beta_vp(t.detach().cpu().numpy()))[:, None] derive = a_signe * (-0.5* bt * x) + g_signe * bt * score_fn(x, t)if i >1: x = x + derive * dt + torch.sqrt(bt * dt) * _bruit(n, gen).to(APPAREIL)else: x = x + derive * dtif i in a_clicher: suivi[i] = (i / n_pas, float(np.trace(np.cov(x.detach().cpu().numpy().T))))return x.detach().cpu().numpy(), suiviprint(f"Tr(Sigma_0) = {TRACE_SIGMA0:.3f} | V(1) = {var_analytique(1.0):.4f} "f"| V(0) = {var_analytique(0.0):.4f}\n")for a_signe, g_signe in ((-1.0, 1.0), (-1.0, -1.0), (1.0, 1.0), (1.0, -1.0)): ech, suivi = sampler_em_signe(score_exact_fn, a_signe, g_signe) part, n_modes = couverture(ech) verdict =" <-- RETENUE"if (a_signe, g_signe) == (-1.0, 1.0) else""print(f"derive = {a_signe:+.0f}*(-beta/2 x) {g_signe:+.0f}*beta*s | "f"MMD={mmd_rbf(ech, VRAIES_REF):.5f} | modes={n_modes}/5{verdict}")for i insorted(suivi, reverse=True): t, v = suivi[i]print(f" t={t:4.2f} Var empirique {v:12.4f} attendue {var_analytique(t):9.4f}")print()
Tr(Sigma_0) = 4.099 | V(1) = 2.0001 | V(0) = 4.0992

derive = -1*(-beta/2 x) +1*beta*s | MMD=0.00079 | modes=5/5   <-- RETENUE
      t=1.00   Var empirique       1.9599   attendue    2.0001
      t=0.90   Var empirique       2.0252   attendue    2.0006
      t=0.70   Var empirique       2.0936   attendue    2.0149
      t=0.50   Var empirique       2.1742   attendue    2.1660
      t=0.30   Var empirique       2.8601   attendue    2.8320
      t=0.10   Var empirique       3.8790   attendue    3.8815
      t=0.00   Var empirique       4.1501   attendue    4.0987

derive = -1*(-beta/2 x) -1*beta*s | MMD=0.68029 | modes=1/5
      t=1.00   Var empirique       2.2799   attendue    2.0001
      t=0.90   Var empirique     737.4421   attendue    2.0006
      t=0.70   Var empirique 8785037.3423   attendue    2.0149
      t=0.50   Var empirique 11492967882.4959   attendue    2.1660
      t=0.30   Var empirique 2165240086819.8154   attendue    2.8320
      t=0.10   Var empirique 73530855987420.3125   attendue    3.8815
      t=0.00   Var empirique 141092958951420.7812   attendue    4.0987

derive = +1*(-beta/2 x) +1*beta*s | MMD=0.04392 | modes=5/5
      t=1.00   Var empirique       1.8093   attendue    2.0001
      t=0.90   Var empirique       0.7104   attendue    2.0006
      t=0.70   Var empirique       0.7136   attendue    2.0149
      t=0.50   Var empirique       0.7208   attendue    2.1660
      t=0.30   Var empirique       0.9036   attendue    2.8320
      t=0.10   Var empirique       1.4472   attendue    3.8815
      t=0.00   Var empirique       1.7174   attendue    4.0987

derive = +1*(-beta/2 x) -1*beta*s | MMD=0.68030 | modes=1/5
      t=1.00   Var empirique       2.1167   attendue    2.0001
      t=0.90   Var empirique      24.5523   attendue    2.0006
      t=0.70   Var empirique     637.3729   attendue    2.0149
      t=0.50   Var empirique    7650.5983   attendue    2.1660
      t=0.30   Var empirique   61357.9272   attendue    2.8320
      t=0.10   Var empirique  420192.9367   attendue    3.8815
      t=0.00   Var empirique  651497.6977   attendue    4.0987
def sampler_em_mauvais_signe(score_fn, n=2048, n_pas=500, graine=SEED +41):"""Le piege, conserve comme contre-exemple : meme integration retrograde, mais la derive est -beta/2 x - beta s -- soit un pas de temps positif applique a la derive du SDE DIRECT, ce qui inverse le signe des deux termes vis-a-vis du bon choix.""" ech, _ = sampler_em_signe(score_fn, 1.0, -1.0, n=n, n_pas=n_pas, graine=graine)return echN_ECH =2048VRAIES_METRIQUE = tirer_vraies(N_ECH) # tirage de reference, independant de VRAIES_REFplancher = mmd_rbf(VRAIES_METRIQUE, VRAIES_REF)resultats = {}for nom, fonction, arg_score in ( ("Langevin recuit (reseau)", sampler_langevin, score_du_reseau_fn), ("Euler-Maruyama (reseau)", sampler_em, score_du_reseau_fn), ("Predicteur-correcteur (reseau)", sampler_pc, score_du_reseau_fn), ("Euler-Maruyama (score exact, controle)", sampler_em, score_exact_fn), ("Euler-Maruyama (mauvais signe, contre-exemple)", sampler_em_mauvais_signe, score_exact_fn),): t0 = time.time() ech = fonction(arg_score, n=N_ECH) duree = time.time() - t0 part, n_modes = couverture(ech) resultats[nom] =dict(ech=ech, mmd=mmd_rbf(ech, VRAIES_REF), part=part, n_modes=n_modes, duree=duree)print(f"{nom:42s} MMD={resultats[nom]['mmd']:.5f} modes={n_modes}/5 {duree:6.1f} s")print(f"\n{'plancher vrai/vrai (tirage independant)':42s} MMD={plancher:.5f}")print(f"{'N (echantillons par methode)':42s}{N_ECH}")
Langevin recuit (reseau)                   MMD=0.00894  modes=5/5   472.0 s
Euler-Maruyama (reseau)                    MMD=0.00156  modes=5/5    32.4 s
Predicteur-correcteur (reseau)             MMD=0.00259  modes=5/5   117.3 s
Euler-Maruyama (score exact, controle)     MMD=0.00025  modes=5/5    76.3 s
Euler-Maruyama (mauvais signe, contre-exemple) MMD=0.68030  modes=1/5   134.5 s

plancher vrai/vrai (tirage independant)    MMD=0.00016
N (echantillons par methode)               2048
# --- Tableau de synthese, ecrit honnetement ---print(f"{'methode':42s}{'MMD (RBF)':>10}{'modes/5':>8}{'T/min MMD':>10}{'latence':>9}")print("-"*84)print(f"{'plancher vrai/vrai':42s}{plancher:9.5f}{'--':>8}{'--':>10}{'--':>9}")for nom, r in resultats.items():print(f"{nom:42s}{r['mmd']:9.5f}{r['n_modes']:5d}/5 {r['mmd']/plancher:9.2f}x {r['duree']:8.1f}s")print("\npart des echantillons par composante (cible en reference) :")print(f" {'cible':42s} "+" ".join(f"{p:6.3f}"for p in POIDS))for nom, r in resultats.items():print(f" {nom:42s} "+" ".join(f"{p:6.3f}"for p in r["part"]))ref_reseau = resultats["Euler-Maruyama (reseau)"]["mmd"]ref_exact = resultats["Euler-Maruyama (score exact, controle)"]["mmd"]print(f"\ncout de l'approximation du reseau (meme pas, meme discretisation) :")print(f" EM reseau {ref_reseau:.5f} vs EM score exact {ref_exact:.5f}"f" -> x{ref_reseau / ref_exact:.2f}")
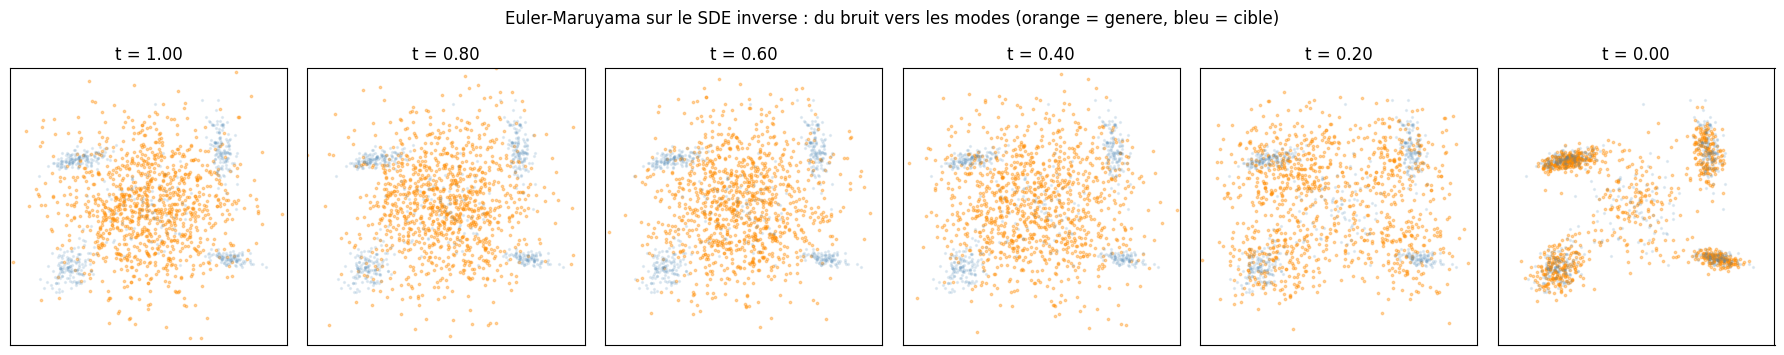
# --- Ce que chaque dynamique fait de la distribution, etape par etape ---def trajectoire_em(score_fn, n=1024, n_pas=500, n_cliches=6, graine=SEED +30):"""Euler-Maruyama, avec des cliches de la distribution a plusieurs instants.""" gen = torch.Generator().manual_seed(graine) x = _bruit(n, gen).to(APPAREIL) dt =1.0/ n_pas cliches = {} a_clicher =set(np.linspace(n_pas, 1, n_cliches).round().astype(int))for i inrange(n_pas, 0, -1): t = torch.full((n,), i / n_pas, device=APPAREIL) bt = vers_torch(beta_vp(t.detach().cpu().numpy()))[:, None] derive = derive_inverse(x, bt, score_fn(x, t))if i >1: x = x + derive * dt + torch.sqrt(bt * dt) * _bruit(n, gen).to(APPAREIL)else: x = x + derive * dtif i in a_clicher: cliches[i] = x.detach().cpu().numpy().copy()return clichescliches = trajectoire_em(score_du_reseau_fn)fig, axes = plt.subplots(1, len(cliches), figsize=(3.0*len(cliches), 3.4))for ax, (i, pts) inzip(axes, sorted(cliches.items(), reverse=True)): ax.scatter(pts[:, 0], pts[:, 1], s=3, alpha=0.35, color="darkorange") ax.scatter(VRAIES_REF[:600, 0], VRAIES_REF[:600, 1], s=2, alpha=0.12, color="steelblue") ax.set_title(f"t = {i/500:.2f}") ax.set_aspect("equal"); ax.set_xlim(-3.2, 3.2); ax.set_ylim(-3.2, 3.2) ax.set_xticks([]); ax.set_yticks([])plt.suptitle("Euler-Maruyama sur le SDE inverse : du bruit vers les modes (orange = genere, bleu = cible)", y=1.03)plt.tight_layout(); plt.show()
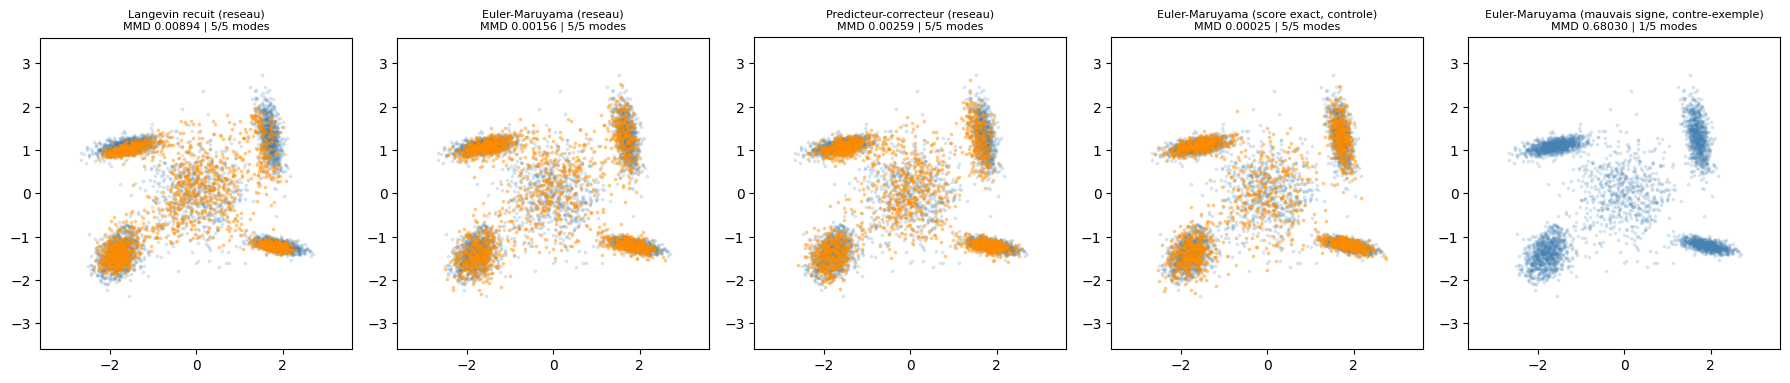
# --- Nuage final : les cinq dynamiques face a la cible ---fig, axes = plt.subplots(1, len(resultats), figsize=(3.6*len(resultats), 4.4))for ax, (nom, r) inzip(axes, resultats.items()): ax.scatter(VRAIES_REF[:, 0], VRAIES_REF[:, 1], s=3, alpha=0.15, color="steelblue") ax.scatter(r["ech"][:, 0], r["ech"][:, 1], s=3, alpha=0.35, color="darkorange") ax.set_title(f"{nom}\nMMD {r['mmd']:.5f} | {r['n_modes']}/5 modes", fontsize=8) ax.set_aspect("equal"); ax.set_xlim(-3.6, 3.6); ax.set_ylim(-3.6, 3.6)plt.tight_layout(); plt.show()
Lire ce tableau honnêtement
Quatre lectures, dans cet ordre — et la dernière borne ce que le notebook démontre.
Le contrôle fait son travail. La ligne « Euler-Maruyama (score exact) » chiffre ce que la méthode peut atteindre à ce budget de pas, réseau mis de côté. L’écart avec la ligne « Euler-Maruyama (réseau) » — ×6.14 ici — est donc entièrement attribuable à l’approximation du score par le réseau, pas à la discrétisation, qui est identique. Sans cette ligne, un mauvais résultat n’aurait pas de cause identifiable : on ne saurait pas si le réseau est en cause ou le schéma d’intégration.
Le contre-exemple est là pour être vu. La ligne « mauvais signe » utilise le même score exact que la ligne de contrôle et le même nombre de pas : tout ce qui les sépare tient au signe de la dérive — et l’écart est de 0.00025 à 0.68030, soit plus de 4000 fois le plancher. Elle s’effondre sur un seul mode (part par composante : 0, 0, 0, 0, 1). C’est ce que la section 7.5 sert à poser : sur ce genre de dynamique, un signe faux ne donne pas une sortie un peu moins bonne, il donne une autre distribution — et c’est le suivi de variance, pas la relecture de la formule, qui le détecte avant qu’on n’accuse le réseau.
Toutes les dynamiques ne se valent pas, et l’ordre n’est pas celui qu’on attend. Sur les trois pilotées par le réseau, Euler-Maruyama passe devant le prédicteur-correcteur et Langevin recuit (0.00156 contre 0.00259 et 0.00894) — alors que Langevin est la plus lente des trois, à budget d’évaluations comparable. Le correcteur ne paie pas ici, et c’est un résultat de ce run, pas une propriété générale. La colonne T/min MMD rapporte chaque MMD en unités du plancher vrai/vrai — c’est le seul ratio qui ait un sens ici. Un MMD proche du plancher ne veut pas dire « distribution identique » : le plancher lui-même n’est pas nul, deux tirages indépendants de la vraie loi ne sont pas confondus par cette métrique à \(N = 2048\).
Ce que ce run ne démontre pas. Un seul seed, un seul budget de pas (\(N = 500\) pour Euler-Maruyama et le prédicteur-correcteur, \(10 \times 200\) pour Langevin — ces budgets ne sont pas égaux en nombre d’évaluations du réseau, et c’est une limite du protocole, pas un classement), une seule cible à cinq composantes. Rien ici n’établit qu’une dynamique domine les autres en général. Ce qui est démontré est la méthode : score mesurable contre une vérité terrain, contrôle qui isole l’erreur du réseau, un signe de dérive tranché par une grandeur mesurable plutôt que par relecture, plusieurs échantillonneurs branchés sur le même champ.
8. La probability flow ODE, et l’équation de Fokker–Planck
La section 9 ci-dessous laisse une ligne ouverte dans sa table de correspondance : « (non implémenté ici) la probability flow ODE ». Cette section la ferme — et la ferme par la mesure, pas en recopiant une formule.
8.1 L’échelle du changement de variable
Derrière tout ce chapitre il y a une seule idée, et elle se lit sur quatre barreaux. Chacun dit la même chose — la masse se conserve — à un degré de généralité de plus :
Barreau
Objet
Ce qui se conserve
Bijection
un flot inversible \(z \mapsto x\)
la masse : \(p_X(x) = p_Z(z)\,\lvert\det \partial z/\partial x\rvert\)
Composition
le même flot en \(T\) étapes inversibles
la masse, à chaque étape
Continuité
le même flot en temps continu — c’est notre PF-ODE
la masse, localement : \(\partial_t p + \nabla\cdot(p\,v) = 0\)
Fokker–Planck
ce transport, plus un terme de diffusion
\(\partial_t p + \nabla\cdot(p\,v) = \tfrac{1}{2}g^2 \Delta p\)
Le troisième barreau est notre ODE déterministe ; le quatrième est notre SDE. Ils ne diffèrent que par le terme de droite — et c’est exactement ce que les mesures de cette section séparent : ce qui change (les trajectoires) et ce qui ne change pas (la loi marginale).
La lecture qui structure cette section — l’échelle à quatre barreaux et le rôle unificateur de Fokker–Planck — suit The Principles of Diffusion Models (Lai et al., 2025, arXiv:2510.21890) : l’annexe B, figure B.1, et le §6.4 (« the universal constraint respected by all three viewpoints »).
8.2 La probability flow ODE
Le SDE direct du chapitre est \(\mathrm{d}x = f(t)\,x\,\mathrm{d}t + g(t)\,\mathrm{d}W\) avec \(f = -\tfrac12\beta\) et \(g^2 = \beta\). La probability flow ODE associée est l’équation déterministe qui transporte la même densité :
À comparer à derive_inverse, la dérive du SDE, qui vaut \(\tfrac12\beta x + \beta s\) : le coefficient du score est le seul écart — \(\beta/2\) ici, \(\beta\) là — et cet écart suffit à retirer tout le bruit. C’est derive_pf ci-dessous, à une ligne près.
# --- 8.2 La probability flow ODE, écrite et intégrée ---def derive_pf(x, bt, score):"""Dérive de la probability flow ODE, en intégration RÉTROGRADE de t. Le SDE direct est dx = f(t) x dt + g(t) dW avec f = -beta/2 et g^2 = beta. La PF-ODE qui lui est ASSOCIÉE est dx/dt = f(t) x - 1/2 g(t)^2 * grad log p_t(x). En intégrant t de 1 vers 0, la dérive change de signe : +beta/2 * x + beta/2 * s(x, t) Comparer à `derive_inverse` (la SDE) : le terme de score y vaut `beta * s`, ici `beta/2 * s`. C'est la SEULE différence entre les deux dynamiques — et elle suffit à retirer tout le bruit. """return0.5* bt * x +0.5* bt * scoredef sampler_pf_ode(score_fn, n=2048, n_pas=500, graine=SEED +20, jalons=(1.0, 0.9, 0.7, 0.5, 0.3, 0.1, 0.0)):"""PF-ODE intégrée à pas fixe et RÉTROGRADE — aucun bruit ajouté, aucun tirage en route. Même graine par défaut que `sampler_em` : le x_T initial est identique, ce qui rend les deux dynamiques comparables trajectoire par trajectoire (section 8.3). """ gen = torch.Generator().manual_seed(graine) x = _bruit(n, gen).to(APPAREIL) dt =1.0/ n_pas a_clicher = {max(int(round(n_pas * f)), 1) for f in jalons} cliches = {}for i inrange(n_pas, 0, -1): t = torch.full((n,), i / n_pas, device=APPAREIL) bt = vers_torch(beta_vp(t.detach().cpu().numpy()))[:, None] x = x + derive_pf(x, bt, score_fn(x, t)) * dtif i in a_clicher: cliches[i] = x.detach().cpu().numpy().copy()return x.detach().cpu().numpy(), cliches
# --- 8.2 (suite) La PF-ODE sur le protocole exact de la section 7 ---t0 = time.time()ech_ode, cliches_ode = sampler_pf_ode(score_du_reseau_fn)duree_ode = time.time() - t0part_ode, modes_ode = couverture(ech_ode)mmd_ode = mmd_rbf(ech_ode, VRAIES_REF)# Le controle symetrique de celui de la section 7.4 : la MEME methode, mais le score exact.# Sans lui, l'ecart ODE/SDE mesurerait l'erreur du reseau autant que la dynamique elle-meme.t0 = time.time()ech_ode_exact, _ = sampler_pf_ode(score_exact_fn)duree_ode_exact = time.time() - t0part_ode_exact, modes_ode_exact = couverture(ech_ode_exact)mmd_ode_exact = mmd_rbf(ech_ode_exact, VRAIES_REF)ref_sde = resultats["Euler-Maruyama (reseau)"]ref_sde_exact = resultats["Euler-Maruyama (score exact, controle)"]print(f"{'méthode':34s}{'MMD (RBF)':>10}{'modes/5':>8}{'T/min MMD':>10}{'latence':>9}")print("-"*76)print(f"{'plancher vrai/vrai':34s}{plancher:10.5f}{'--':>8}{'--':>10}{'--':>9}")for nom, m, mo, d in ( ("Euler-Maruyama SDE (reseau)", ref_sde["mmd"], ref_sde["n_modes"], ref_sde["duree"]), ("Probability flow ODE (reseau)", mmd_ode, modes_ode, duree_ode), ("Euler-Maruyama SDE (score exact)", ref_sde_exact["mmd"], ref_sde_exact["n_modes"], ref_sde_exact["duree"]), ("Probability flow ODE (score exact)", mmd_ode_exact, modes_ode_exact, duree_ode_exact),):print(f"{nom:34s}{m:10.5f}{mo:5d}/5 {m / plancher:9.2f}x {d:8.1f}s")print("\ncout de l'approximation du reseau, A METHODE FIXEE :")print(f" SDE {ref_sde['mmd']:.5f} vs {ref_sde_exact['mmd']:.5f}"f" -> x{ref_sde['mmd'] / ref_sde_exact['mmd']:.2f}")print(f" ODE {mmd_ode:.5f} vs {mmd_ode_exact:.5f}"f" -> x{mmd_ode / mmd_ode_exact:.2f}")print("\necart ODE / SDE, A SCORE FIXE :")print(f" reseau {mmd_ode:.5f} / {ref_sde['mmd']:.5f}"f" -> x{mmd_ode / ref_sde['mmd']:.2f}")print(f" exact {mmd_ode_exact:.5f} / {ref_sde_exact['mmd']:.5f}"f" -> x{mmd_ode_exact / ref_sde_exact['mmd']:.2f}")print("\npart des échantillons par composante (cible en référence) :")print(f" {'cible':34s} "+" ".join(f"{p:6.3f}"for p in POIDS))print(f" {'Euler-Maruyama SDE':34s} "+" ".join(f"{p:6.3f}"for p in ref_sde["part"]))print(f" {'Probability flow ODE':34s} "+" ".join(f"{p:6.3f}"for p in part_ode))
méthode                             MMD (RBF)  modes/5  T/min MMD   latence
----------------------------------------------------------------------------
plancher vrai/vrai                    0.00016       --         --        --
Euler-Maruyama SDE (reseau)           0.00156     5/5      9.52x     32.4s
Probability flow ODE (reseau)         0.00326     5/5     19.87x     45.0s
Euler-Maruyama SDE (score exact)      0.00025     5/5      1.55x     76.3s
Probability flow ODE (score exact)    0.00016     5/5      0.98x     89.6s

cout de l'approximation du reseau, A METHODE FIXEE :
  SDE  0.00156  vs  0.00025   ->  x6.14
  ODE  0.00326  vs  0.00016   ->  x20.36

ecart ODE / SDE, A SCORE FIXE :
  reseau  0.00326 / 0.00156   ->  x2.09
  exact   0.00016 / 0.00025   ->  x0.63

part des échantillons par composante (cible en référence) :
  cible                               0.240   0.200   0.180   0.220   0.160
  Euler-Maruyama SDE                  0.246   0.139   0.194   0.212   0.209
  Probability flow ODE                0.286   0.136   0.188   0.188   0.202
8.3 Même loi, autres trajectoires
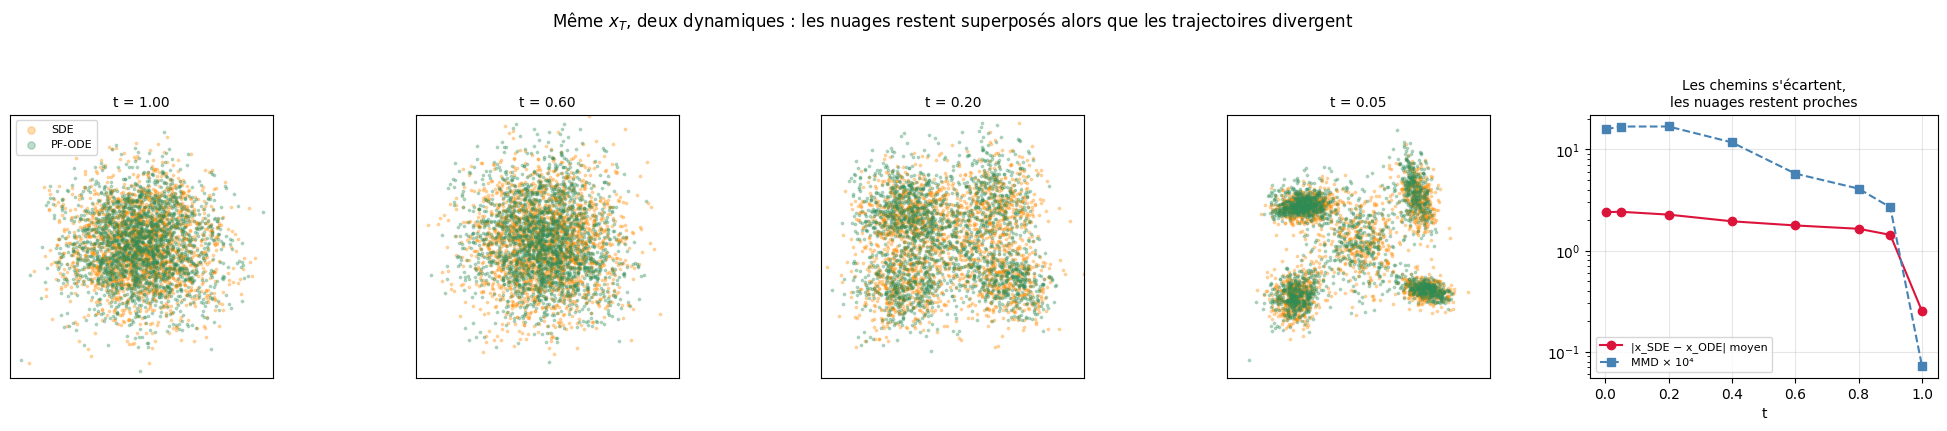
Le tableau de 8.2 compare deux distributions finales. Il ne dit rien des chemins. Or c’est là qu’est tout le point : si la SDE et la PF-ODE partent du même\(x_T\) et suivent des chemins différents, elles doivent malgré tout arriver à la même loi.
On les fait donc courir appariées — même tirage initial, mêmes instants de cliché — et on mesure trois choses distinctes, qu’il ne faut pas confondre :
l’écart moyen entre les chemins (position contre position, pour la même particule) — il doit croître ;
la distance entre les deux nuages à chaque instant (MMD) — mesure de loi : au score exact elle reste au plancher ; au score du réseau elle garde un écart réel mais faible (une dizaine de fois le plancher, chiffré dans la lecture) ;
la variance de chacun, contre la valeur analytique var_analytique(t) déjà écrite en 7.5.
# --- 8.3 Même départ, même loi, chemins différents ---def trajectoires_appariees(score_fn, n=2048, n_pas=500, graine=SEED +60, jalons=(1.0, 0.9, 0.8, 0.6, 0.4, 0.2, 0.05, 0.0)):"""Fait courir la SDE et la PF-ODE depuis le MÊME x_T, et cliche aux MÊMES instants. Le tirage initial est consommé UNE fois puis cloné : les deux dynamiques voient exactement le même point de départ. Au-delà, le bruit de la SDE consomme son propre générateur, donc les chemins divergent — c'est précisément ce qu'on veut mesurer. Le schéma de la SDE est celui de `sampler_em` (dernier pas déterministe), pour que la comparaison porte sur les deux dynamiques et non sur deux discrétisations. """ gen0 = torch.Generator().manual_seed(graine) x_init = _bruit(n, gen0) gen_sde = torch.Generator().manual_seed(graine +1) x_sde, x_ode = x_init.clone().to(APPAREIL), x_init.clone().to(APPAREIL) pas = {max(int(round(n_pas * f)), 1) for f in jalons} cliches_sde, cliches_ode = {}, {} dt =1.0/ n_pasfor i inrange(n_pas, 0, -1): t = torch.full((n,), i / n_pas, device=APPAREIL) bt = vers_torch(beta_vp(t.detach().cpu().numpy()))[:, None] derive = derive_inverse(x_sde, bt, score_fn(x_sde, t))if i >1: x_sde = x_sde + derive * dt + torch.sqrt(bt * dt) * _bruit(n, gen_sde).to(APPAREIL)else: x_sde = x_sde + derive * dt x_ode = x_ode + derive_pf(x_ode, bt, score_fn(x_ode, t)) * dtif i in pas: cliches_sde[i] = x_sde.detach().cpu().numpy().copy() cliches_ode[i] = x_ode.detach().cpu().numpy().copy()return cliches_sde, cliches_odet0 = time.time()appariees_sde, appariees_ode = trajectoires_appariees(score_du_reseau_fn)duree_app = time.time() - t0lignes_app = []for i insorted(appariees_sde, reverse=True): tt = i /500.0 A, B = appariees_sde[i], appariees_ode[i] lignes_app.append((tt,float(np.linalg.norm(A - B, axis=1).mean()), mmd_rbf(A, B),float(np.trace(np.cov(A.T))),float(np.trace(np.cov(B.T))), var_analytique(tt)))print(f"durée : {duree_app:.1f} s\n")print(f"{'t':>6}{'|x_SDE - x_ODE|':>17}{'MMD(SDE, ODE)':>14} "f"{'Var SDE':>9}{'Var ODE':>9}{'Var attendue':>13}")print("-"*76)for tt, ec, mm, va, vo, att in lignes_app:print(f"{tt:6.2f}{ec:17.3f}{mm:14.6f}{va:9.4f}{vo:9.4f}{att:13.4f}")
# --- 8.3 (suite) Les deux nuages à quatre instants, et l'écart des chemins ---fig, axes = plt.subplots(1, 5, figsize=(20, 4.1))choisis = [i for i insorted(appariees_sde, reverse=True) if i in (500, 300, 100, 25)][:4]for ax, i inzip(axes[:4], choisis): A, B = appariees_sde[i], appariees_ode[i] ax.scatter(A[:, 0], A[:, 1], s=3, alpha=0.30, color="darkorange", label="SDE") ax.scatter(B[:, 0], B[:, 1], s=3, alpha=0.30, color="seagreen", label="PF-ODE") ax.set_title(f"t = {i /500:.2f}", fontsize=10) ax.set_aspect("equal"); ax.set_xlim(-3.6, 3.6); ax.set_ylim(-3.6, 3.6) ax.set_xticks([]); ax.set_yticks([])axes[0].legend(fontsize=8, loc="upper left", markerscale=3)ts = [r[0] for r in lignes_app][::-1]axes[4].plot(ts, [r[1] for r in lignes_app][::-1], "o-", color="crimson", label="|x_SDE − x_ODE| moyen")axes[4].plot(ts, [r[2] *1e4for r in lignes_app][::-1], "s--", color="steelblue", label="MMD × 10⁴")axes[4].set_xlabel("t"); axes[4].set_yscale("log")axes[4].set_title("Les chemins s'écartent,\nles nuages restent proches", fontsize=10)axes[4].legend(fontsize=8); axes[4].grid(alpha=0.3)plt.suptitle("Même $x_T$, deux dynamiques : les nuages restent superposés ""alors que les trajectoires divergent", y=1.04)plt.tight_layout(); plt.show()
8.4 L’équation de Fokker–Planck, et pourquoi les deux lois coïncident
Les sections 8.2 et 8.3 ont mesuré que la SDE et la PF-ODE aboutissent à des lois voisines — indiscernables au plancher à score exact, séparées d’une dizaine de fois le plancher à score appris. Le partage exact de la loi, lui, ne se mesure pas sur un run : il se démontre. La raison tient en deux lignes d’algèbre — et c’est l’équation de Fokker–Planck.
Pour le SDE direct, la densité obéit à
\[\partial_t p = -\nabla\cdot(f\,x\,p) + \tfrac12 g^2\,\Delta p .\]
Pour la PF-ODE, dont la dérive est \(v = f x - \tfrac12 g^2 \nabla\log p\), la conservation de la masse — le barreau « continuité » du tableau 8.1 — donne
\[\partial_t p = -\nabla\cdot(p\,v)
= -\nabla\cdot(f\,x\,p) + \tfrac12 g^2\,\nabla\cdot\!\left(p\,\nabla\log p\right)
= -\nabla\cdot(f\,x\,p) + \tfrac12 g^2\,\Delta p .\]
Même équation — au score exact. L’identification \(p\,\nabla\log p = \nabla p\) ci-dessus est une identité algébrique sur le vrai score : elle ne survit pas à la substitution d’un score appris quelconque, dont le résidu sépare les deux équations. À score exact, les deux dynamiques ne sont donc pas deux approximations l’une de l’autre : ce sont deux familles de caractéristiques différentes de la même équation de transport. Le principe que la section 9 formule en une phrase — un échantillonneur déterministe n’est pas une approximation d’un échantillonneur stochastique, c’est une autre trajectoire vers la même loi — est exactement ce résultat à score exact et à la limite continue, et Fokker–Planck en est la démonstration.
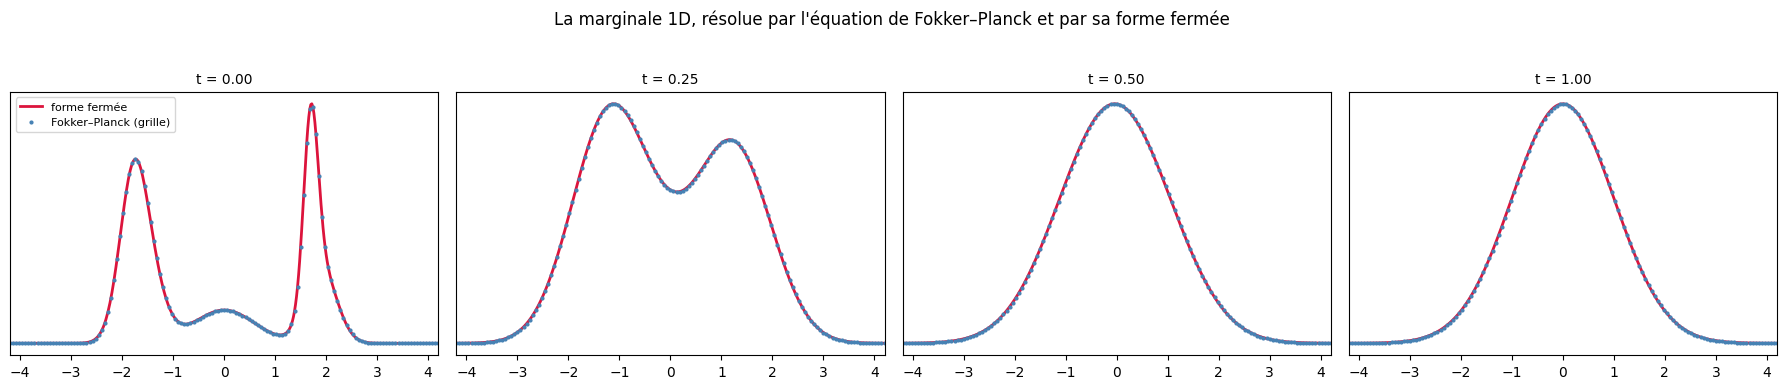
Reste à montrer que cette équation n’est pas qu’un symbole : on la résout. On la prend sur la marginale 1D de la coordonnée \(x\), où elle reste close — parce que la dérive \(-\tfrac12\beta(t)x\) est linéaire et isotrope, donc la projection d’un VP-SDE 2D sur un axe est encore un VP-SDE 1D, avec le même \(\beta(t)\).
# --- 8.4 L'équation de Fokker–Planck, résolue sur la marginale 1D ---def p_ferme_1d(x, t):"""Marginale EXACTE de la coordonnée x à l'instant t — la référence. x_t = sqrt(ab) x_0 + sqrt(1-ab) eps, donc chaque composante k donne une gaussienne 1D de moyenne sqrt(ab) * mu_kx et de variance ab * Sigma_kxx + (1 - ab). """ ab =float(alpha_bar_vp(t)) m = np.sqrt(ab) * MOYENNES[:, 0] v = ab * SIGMA[:, 0, 0] + (1.0- ab)return np.sum(POIDS[:, None]* np.exp(-0.5* (x[None, :] - m[:, None]) **2/ v[:, None])/ np.sqrt(2* np.pi * v[:, None]), axis=0)def resoudre_fokker_planck(xs, jalons=(0.0, 0.25, 0.5, 0.75, 1.0), marge_securite=0.4):"""Résout d_t p = d_x(beta/2 * x * p) + beta/2 * d_xx p par différences finies explicites. Le pas de temps vient de la condition de stabilité de la diffusion (dt <= marge * dx^2 / beta_max) : c'est beta_max, atteint à t = 1, qui le contraint. """ dx = xs[1] - xs[0] n_pas =int(np.ceil(1.0/ (marge_securite * dx **2/ BETA_MAX))) dt =1.0/ n_pas p = p_ferme_1d(xs, 0.0) p /= p.sum() * dx cibles = {int(round(n_pas * f)) for f in jalons} res = {}for k inrange(n_pas +1):if k in cibles: res[k] = p.copy()if k == n_pas:break b =float(beta_vp(np.array(k * dt))) p = p + dt * (np.gradient(0.5* b * xs * p, dx)+0.5* b * np.gradient(np.gradient(p, dx), dx)) p[0] =0.0 p[-1] =0.0return res, n_pas, dtXS = np.linspace(-6.0, 6.0, 601) # large : à t = 1 la densité est ~N(0, 2), donc 4,2 sigmaDX = XS[1] - XS[0]t0 = time.time()res_fp, n_pas_fp, dt_fp = resoudre_fokker_planck(XS)duree_fp = time.time() - t0print(f"grille : {len(XS)} points sur [{XS[0]:.0f}, {XS[-1]:.0f}] | dx = {DX:.4f}")print(f"pas de temps : dt = {dt_fp:.2e} | {n_pas_fp} pas | {duree_fp:.1f} s\n")print(f"{'t':>6}{'masse':>10}{'L1 vs forme fermée':>20}{'Linf':>11}")print("-"*52)for k insorted(res_fp): tt = k / n_pas_fp num, ref = res_fp[k], p_ferme_1d(XS, tt)print(f"{tt:6.2f}{num.sum() * DX:10.6f}{np.abs(num - ref).sum() * DX:20.3e} "f"{np.abs(num - ref).max():11.3e}")
grille : 601 points sur [-6, 6]  |  dx = 0.0200
pas de temps : dt = 8.00e-06  |  125001 pas  |  3.8 s

     t      masse   L1 vs forme fermée        Linf
----------------------------------------------------
  0.00   1.000000            2.132e-14   1.632e-14
  0.25   1.000000            1.567e-04   5.443e-05
  0.50   1.000000            2.471e-05   8.323e-06
  0.75   1.000000            4.591e-05   1.959e-05
  1.00   1.000000            4.662e-05   1.983e-05
# --- 8.4 (suite) La boucle se ferme : la grille, la forme fermée, et les échantillons ---rng = np.random.default_rng(SEED +7)N_EMP =400_000k_emp = rng.choice(len(POIDS), size=N_EMP, p=POIDS)x0_emp = MOYENNES[k_emp, 0] + np.sqrt(SIGMA[k_emp, 0, 0]) * rng.standard_normal(N_EMP)bornes = np.concatenate([XS - DX /2, [XS[-1] + DX /2]])print(f"{N_EMP} échantillons du bruitage direct, histogrammés sur la même grille.\n")print(f"{'t':>6}{'L1(échantillons, grille)':>26}{'L1(échantillons, forme fermée)':>32}")print("-"*68)for tt in (0.25, 0.5, 1.0): ab =float(alpha_bar_vp(tt)) xt = np.sqrt(ab) * x0_emp + np.sqrt(1.0- ab) * rng.standard_normal(N_EMP) hist, _ = np.histogram(xt, bins=bornes, density=True) kk =int(round(n_pas_fp * tt)) l1_grille =float(np.abs(hist - res_fp[kk]).sum() * DX) l1_ferme =float(np.abs(hist - p_ferme_1d(XS, tt)).sum() * DX)print(f"{tt:6.2f}{l1_grille:26.4e}{l1_ferme:32.4e}")print("\nSi les deux colonnes sont du même ordre, la grille est aussi proche des données que")print("ne l'est la forme fermée : l'écart restant est celui de l'histogramme, pas du solveur.")fig, axes = plt.subplots(1, 4, figsize=(18, 3.7))for ax, tt inzip(axes, (0.0, 0.25, 0.5, 1.0)): kk =int(round(n_pas_fp * tt)) ax.plot(XS, p_ferme_1d(XS, tt), color="crimson", lw=2.0, label="forme fermée") ax.plot(XS[::3], res_fp[kk][::3], "o", ms=2.0, color="steelblue", label="Fokker–Planck (grille)") ax.set_title(f"t = {tt:.2f}", fontsize=10) ax.set_xlim(-4.2, 4.2); ax.set_yticks([])axes[0].legend(fontsize=8)plt.suptitle("La marginale 1D, résolue par l'équation de Fokker–Planck ""et par sa forme fermée", y=1.04)plt.tight_layout(); plt.show()
400000 échantillons du bruitage direct, histogrammés sur la même grille.

     t   L1(échantillons, grille)   L1(échantillons, forme fermée)
--------------------------------------------------------------------
  0.25                 2.1014e-02                       2.1015e-02
  0.50                 1.9318e-02                       1.9318e-02
  1.00                 2.1513e-02                       2.1515e-02

Si les deux colonnes sont du même ordre, la grille est aussi proche des données que
ne l'est la forme fermée : l'écart restant est celui de l'histogramme, pas du solveur.
Lire ces trois résultats
Quatre lectures, dans cet ordre — la première corrige une conclusion que la table de 8.2 seule aurait fait tirer à l’envers.
Sans le contrôle, on concluait faux. La table de 8.2 compare d’abord Euler-Maruyama et la PF-ODE toutes deux pilotées par le réseau : 0.00156 contre 0.00326, soit la version déterministe 2.09× plus loin de la cible. Lue seule, cette ligne dit « l’ODE est moins bonne ». C’est faux, et la quatrième ligne le montre : avec le score exact, la PF-ODE tombe à 0.00016, soit au plancher (0.98×), pendant que la SDE reste à 1.55×. Décomposé, cela donne deux nombres qui ne disent pas la même chose :
décomposition
SDE
PF-ODE
coût du réseau, à méthode fixée
×6.14
×20.36
écart ODE / SDE, à score fixé
—
×2.09 (réseau) · ×0.63 (exact)
La PF-ODE est donc à la fois la meilleure et la pire des deux, et c’est le score qui tranche. Elle amplifie l’erreur du réseau — ×20.4 contre ×6.1 — parce que rien n’y moyenne cette erreur : le long d’une trajectoire déterministe, une imprécision de score s’accumule de façon cohérente, là où le bruit injecté par la SDE la disperse en partie.
La phrase de la section 9 — un échantillonneur déterministe n’est pas une approximation d’un échantillonneur stochastique, c’est une autre trajectoire vers la même loi — est donc vérifiée (à score exact, les deux sont au plancher), mais elle est asymptotique en la qualité du score. À score appris, « déterministe » n’est pas un synonyme de « meilleur » : c’est un mot qui décrit une sensibilité, pas une qualité.
Les trajectoires ne sont pas le modèle — et on peut le chiffrer. Partis du même\(x_T\) (MMD à \(t = 1\) : 7e-06, le contrôle que l’appariement fonctionne bien), les deux jeux de chemins s’écartent jusqu’à un écart moyen de 2.399 par particule : c’est plus que la distance du centre à n’importe lequel des quatre modes excentrés de la cible (1.942 à 2.280). Et pourtant le MMD entre les deux nuages ne dépasse jamais 1.7e-03, soit une dizaine de fois le plancher. C’est la mesure directe du principe : deux familles de chemins séparées de 2.4 unités produisent des nuages que la métrique sépare d’à peine une dizaine de fois le plancher — un écart réel mais faible, loin d’une identité, et sans effet sur la lecture des modes.
Les deux variances suivent var_analytique(t) de près et terminent du même ordre l’une que l’autre (3.839 et 3.920 contre 4.099 attendus, soit ≈ 5 % sous la valeur analytique). Ce déficit est partagé par les deux dynamiques : il renvoie donc à l’approximation du score — le même réseau des deux côtés — plutôt qu’à la façon d’intégrer.
La raison n’est pas une coïncidence numérique. L’équation de Fokker–Planck, résolue à la main sur la marginale 1D, conserve la masse à 1.000000 à tous les instants, et suit la forme fermée à 4.662e-05 près en norme L1 (5.443e-05 en norme infinie) sur 601 points et 125 001 pas de temps. Et la boucle se ferme contre les données : sur 400 000 échantillons du bruitage direct, l’écart entre l’histogramme et la solution de la grille est identique, à la cinquième décimale, à l’écart entre l’histogramme et la forme fermée (2.1014e-02 contre 2.1015e-02 à \(t = 0.25\) ; 1.9318e-02 contre 1.9318e-02 à \(t = 0.5\)). L’écart résiduel est celui de l’histogramme, pas du solveur.
La SDE et la PF-ODE ne sont donc pas deux approximations l’une de l’autre : elles résolvent la même équation de transport — l’une par ses caractéristiques stochastiques, l’autre par ses caractéristiques déterministes. C’est ce que la section 9 affirmait sans le démontrer, et c’est ce que la lecture 1 chiffre.
Ce que ce run ne démontre pas. Un seul seed, \(N = 2048\), 500 pas, une cible à cinq composantes, un seul réseau. Le rapport « l’ODE amplifie l’erreur du score ×20 contre ×6 » est un résultat de ce run : il dépend du réseau, du budget de pas et de la cible, et rien ici n’établit qu’il vaudrait pour un autre couple (modèle, échantillonneur) — c’est d’ailleurs l’objet du bloc B de la feuille de route que de le confronter à la bibliothèque de référence. Ce qui est structurel, en revanche, est établi : les deux dynamiques partagent l’équation de Fokker–Planck, donc la loi — et le solveur de 8.4 le vérifie contre une forme fermée, sans dépendre d’aucun réseau.
9. Ce que la vue continue a apporté
9.1 Table de correspondance from scratch ↔︎ diffusers
Comme le 3.6c pour le DDPM discret, voici ce que recouvrent les objets de la bibliothèque de référence — sans l’utiliser (c’est l’item 5 du bloc B de la feuille de route #16056 qui le fera).
Ici (from scratch)
Objet diffusers équivalent
Ce que l’objet cache
beta_vp, alpha_bar_vp
DDPMScheduler(beta_schedule="linear")
l’intégrale de \(\beta\), la forme fermée de \(\bar\alpha\)
score_du_reseau
scheduler.step() (paramétrage \(\varepsilon\))
la conversion \(\varepsilon \to\) score, et le coefficient \(1/\sqrt{1-\bar\alpha}\)
la discrétisation de la SDE inverse, la convention du dernier pas
sampler_pf_ode, derive_pf (§8.2)
DDIMScheduler, DPMSolverSDEScheduler
que déterministe \(\neq\) autre modèle : même réseau, autre dynamique
La dernière ligne est le point que le continu rend visible et que le 3.6c ne pouvait pas montrer : l’ODE et la SDE ont le même champ de score pour seul ingrédient. Un échantillonneur déterministe n’est pas une approximation d’un échantillonneur stochastique, c’est une autre trajectoire vers la même loi — et la section 8 en donne la mesure (trajectoires appariées, 8.3) puis la raison (l’équation de Fokker–Planck, 8.4, commune aux deux dynamiques).
9.2 Ce qui reste ouvert
Ce notebook livre la dynamique — pas encore la condition. La suite naturelle est le bloc A item 3 : génération conditionnelle par étiquette et classifier-free guidance (c’est-à-dire une pondération sur le score, encore une fois), puis le bloc B (items 5-7, feuille de route #16056) pour la comparaison frontale avec la bibliothèque de référence.
9.3 Résumé en une phrase
Le DDPM discret du 3.6c apprenait déjà un champ de score ; le passer en temps continu ne change pas le réseau, mais rend ce champ mesurable (contre une vérité terrain), isolable (le réseau contre la méthode) et réutilisable (Langevin, SDE — et l’ODE déterministe de la section 8.2 — branchés sur le même objet).