import time
import numpy as np
import matplotlib.pyplot as plt

%matplotlib inline

rng_global = np.random.default_rng(0)

print("NumPy", np.__version__)
NumPy 2.4.2Navigation : 3.4-Attention-Transformer · 3.5-Phenomenes-de-Generalisation > · Feuille de route de la série
Les notebooks 3.1 à 3.4 ont construit un MLP pas à pas, l’ont armé d’Adam, et l’ont transporté jusqu’à un mini-Transformer. Sur tout ce parcours, le réseau était testé sur des tâches algorithmiques : classification d’un modulo, inversion de séquence, prédiction de jeton. Ces tâches ont un point commun : elles ne ressemblent pas à un signal — elles ont une structure symbolique, et le réseau la découvre ou la mémorise.
Ici, on revient au signal : une cible continue \(y(x)\), où \(x \in [-1, 1]\). La question est plus traîtresse qu’elle n’en a l’air :
Le mapping \(\gamma(x) = [\cos(2\pi B x), \sin(2\pi B x)]\), popularisé par Mildenhall et al. (2020) dans NeRF sous le nom de positional encoding, puis formalisé par Tancik et al. (2020) pour l’étude du biais spectral des réseaux de neurones, est l’outil central de ce notebook. C’est le même geste que les encodages positionnels sinusoïdaux du 3.4-Attention-Transformer, transposé ici en carte de sortie d’une couche sans paramètres, et opposé frontalement à un MLP qui reçoit \(x\) brut.
Ce qu’on cherche à voir, au-delà du MLP qui plafonne : la transition continue entre trois régimes — sous-ajustement (bandes trop basses), ajustement (bandes à la bonne échelle), aliasing (bandes trop hautes). Trois valeurs de \(\sigma\), une seule métrique (MSE test), une seule figure.
Kernel : Python 3 · Bibliothèques : NumPy, matplotlib · CPU : oui (~30 s) · Prérequis : 3.1 (MLP NumPy, rétropropagation), 3.2 (Adam)
import time
import numpy as np
import matplotlib.pyplot as plt
%matplotlib inline
rng_global = np.random.default_rng(0)
print("NumPy", np.__version__)NumPy 2.4.2# Hyperparametres : montage CPU-borne, le notebook execute en ~30s
N_TR = 64 # points d'entrainement (peu : c'est un probleme dur)
N_TE = 400 # points de test (grille dense)
H = 64 # largeur des couches cachees
N_LAYERS = 3 # nombre de couches cachees tanh
STEPS = 3000 # pas d'optimisation Adam
BATCH = 16 # taille mini-batch (leger stochastique)
LR = 1e-3 # taux d'apprentissage Adam
N_BANDS = 64 # nombre de bandes Fourier B_j
SIGMAS = (1.0, 5.0, 50.0) # trois regimes : sous, bon, aliasing
SEED = 0 # graine maitresse
rng = np.random.default_rng(SEED)
print(f"Signal : {N_TR} points d'entrainement, {N_TE} de test, montage CPU ~30s")Signal : 64 points d'entrainement, 400 de test, montage CPU ~30s# Cible : somme de sinusoides haute frequence. Le MLP va peiner sur la frequence 13.
def make_signal(n, seed=0):
"""Cible 1D : 0.7*sin(2pi*6*x) + 0.4*sin(2pi*13*x + 0.7). Frequences 6 et 13 cycles."""
rng = np.random.default_rng(seed)
x = np.linspace(-1.0, 1.0, n).reshape(-1, 1)
y = 0.7 * np.sin(2 * np.pi * 6.0 * x) + 0.4 * np.sin(2 * np.pi * 13.0 * x + 0.7)
return x.astype(np.float64), y.astype(np.float64).ravel()
x_tr, y_tr = make_signal(N_TR, seed=SEED)
x_te, y_te = make_signal(N_TE, seed=SEED + 1000) # grille de test dense
fig, ax = plt.subplots(figsize=(8, 3))
ax.plot(x_te, y_te, color="gray", lw=1, label="cible (continue)")
ax.scatter(x_tr, y_tr, s=18, color="C0", zorder=3, label=f"entrainement ({N_TR} pts)")
ax.set_xlabel("x")
ax.set_ylabel("y")
ax.set_title("Cible : deux sinusoides (frequences 6 et 13 cycles sur [-1, 1])")
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()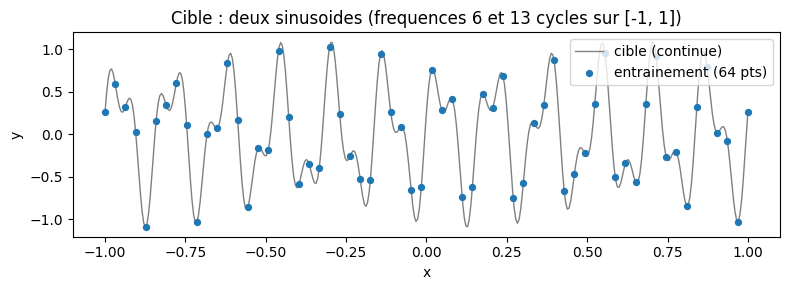
Qu’est-ce que le biais spectral ? Rahaman et al. (2019, On the Spectral Bias of Neural Networks) montrent qu’un MLP à activations lisses (tanh, sin, ReLU) converge d’abord vers les basses fréquences de sa cible — les fonctions de la couche finale vivent dans une bande passante limitée par la Neural Tangent Kernel (NTK, Jacot et al. 2018), dont le spectre décroît exponentiellement avec la fréquence.
Conséquence pratique : un MLP face à un signal qui mélange des fréquences 6 et 13 cycles va apprendre la 6, négliger la 13, et produire une approximation visiblement lisse du signal. La sortie MSE reste médiocre. Augmenter la largeur, la profondeur, ou le nombre de pas d’optimisation ne change pas la structure du problème : la bande passante du NTK reste la même.
Le mapping de Fourier \(\gamma(x)\) contourne le problème. Tancik et al. (2020, Fourier Features Let Networks Learn High Frequency Functions in Low Dimensional Domains) montrent qu’en passant l’entrée par
\[\gamma(x) = [\cos(2\pi B_1 x), \sin(2\pi B_1 x), \dots, \cos(2\pi B_k x), \sin(2\pi B_k x)]\]
où \(B_j \sim \mathcal{N}(0, \sigma^2)\) est un vecteur de bandes aléatoires gaussiennes, on élargit la bande passante effective du réseau. La sortie vit dans la base \([\cos, \sin]\) des bandes données ; le MLP n’a plus qu’à apprendre l’amplitude et la phase de chaque composante, ce que tanh fait trivialement.
Trois régimes à voir venir, dès la formulation :
Note sur la NTK et la preuve théorique. Le théorème de Tancik et al. formalise ce passage en bande passante : pour \(\sigma \to \infty\), le NTK du MLP compose avec les bandes Fourier et son spectre se redresse sur les hautes fréquences. Mais la preuve dit qu’on peut apprendre les hautes fréquences, pas qu’on doit en mettre le plus possible. Le bon \(\sigma\) est une propriété du signal et du nombre d’observations — pas un hyperparamètre gratuit. C’est ce qu’on mesure empiriquement dans les sections 3 à 5.
Lien NeRF. Mildenhall et al. (2020, NeRF: Representing Scenes as Neural Radiance Fields for View Synthesis) utilisent \(\gamma(x) = [\sin(2^0 \pi x), \cos(2^0 \pi x), \dots, \sin(2^{L-1} \pi x), \cos(2^{L-1} \pi x)]\) avec \(L = 10\) sur les coordonnées 3D. Le choix \(2^l\) est un cas particulier du mapping gaussien (il force un balayage dyadique des fréquences). C’est exactement le geste que vous avez déjà vu dans les encodages positionnels sinusoïdaux du 3.4-Attention-Transformer — sauf que là, l’entrée est une position de séquence, ici une coordonnée d’espace.
Lien RoPE. RoPE (Rotary Position Embedding, Su et al. 2021) applique une rotation 2D dans le plan complexe à chaque paire de features d’attention, indexée par la position. C’est une encodage positionnel appliqué à la sortie d’attention, pas à l’entrée du MLP — le mécanisme est différent mais l’esprit (faire porter la position par des sinusoïdes) est le même. Le mapping \(\gamma\) ici est l’instance la plus directe.
# MLP a 3 couches cachees tanh, gradient ecrit a la main (cf. 3.1)
class FourierMLP:
    """MLP tanh, in_dim variable (1 brut ou 2k apres gamma), h largeur, out_dim sortie."""

    def __init__(self, in_dim, h, out_dim, n_layers, seed):
        if n_layers < 2:
            raise ValueError("n_layers >= 2 (au moins une couche cachee + sortie)")
        rng = np.random.default_rng(seed)
        s_in = np.sqrt(1.0 / in_dim)
        s_h = np.sqrt(1.0 / h)
        self.W = []
        self.b = []
        self.W.append(rng.normal(0, s_in, (in_dim, h)))
        self.b.append(np.zeros(h))
        for _ in range(n_layers - 2):
            self.W.append(rng.normal(0, s_h, (h, h)))
            self.b.append(np.zeros(h))
        self.W.append(rng.normal(0, s_h, (h, out_dim)))
        self.b.append(np.zeros(out_dim))
        self.n_layers = n_layers

    def params(self):
        out = []
        for W, b in zip(self.W, self.b):
            out.append(W)
            out.append(b)
        return out

    def forward(self, x):
        h = x
        for li in range(self.n_layers - 1):
            h = np.tanh(h @ self.W[li] + self.b[li])
        out = h @ self.W[-1] + self.b[-1]
        return out

    def forward_cache(self, x):
        """Forward en gardant les activations pour le backward."""
        zs = []
        acts = []
        h = x
        for li in range(self.n_layers - 1):
            z = h @ self.W[li] + self.b[li]
            a = np.tanh(z)
            zs.append(z)
            acts.append(a)
            h = a
        out = h @ self.W[-1] + self.b[-1]
        return out, zs, acts


def grad_mse(model, x, y):
    """Gradient analytique MSE pour MLP tanh n_layers."""
    out, zs, acts = model.forward_cache(x)
    n = x.shape[0]
    y_col = y.reshape(-1, 1) if y.ndim == 1 else y
    dout = 2.0 * (out - y_col) / n
    gW = [None] * model.n_layers
    gb = [None] * model.n_layers
    dh = dout @ model.W[-1].T
    for li in range(model.n_layers - 2, -1, -1):
        dz = dh * (1.0 - acts[li] ** 2)
        prev = x if li == 0 else acts[li - 1]
        gW[li] = prev.T @ dz
        gb[li] = dz.sum(axis=0)
        dh = dz @ model.W[li].T
    gW[-1] = acts[-1].T @ dout
    gb[-1] = dout.sum(axis=0)
    flat = []
    for W, b in zip(gW, gb):
        flat.append(W)
        flat.append(b)
    return flat, ((out - y_col) ** 2).mean()


# Garde gradient (cf. 3.1) : on verifie qu'on n'a pas perdu un signe dans le backward
_model_test = FourierMLP(in_dim=1, h=8, out_dim=1, n_layers=N_LAYERS, seed=42)
_x = x_tr[:8]
_y = y_tr[:8]
_g, _ = grad_mse(_model_test, _x, _y)
_rng = np.random.default_rng(0)
_params = _model_test.params()
_ecarts = []
_eps = 1e-3
for _pi, _p in enumerate(_params):
    _flat = _p.ravel()
    _idx = _rng.choice(_flat.size, size=min(3, _flat.size), replace=False)
    for _i in _idx:
        _old = _flat[_i]
        _flat[_i] = _old + _eps
        _, _lp = grad_mse(_model_test, _x, _y)
        _flat[_i] = _old - _eps
        _, _lm = grad_mse(_model_test, _x, _y)
        _flat[_i] = _old
        _num = (_lp - _lm) / (2 * _eps)
        _ana = _g[_pi].ravel()[_i]
        if abs(_num) + abs(_ana) > 1e-9:
            _ecarts.append(abs(_num - _ana) / (abs(_num) + abs(_ana)))
print(f"Ecart gradient check (forward vs analytique, 3 couches) : {max(_ecarts):.2e} (seuil 1e-5)")
assert max(_ecarts) < 1e-5, "backward inexact"
Ecart gradient check (forward vs analytique, 3 couches) : 2.08e-07 (seuil 1e-5)# Adam (cf. 3.2), en version compacte
def adam_train(model, x, y, steps, lr, batch, seed):
"""Adam full-batch ou mini-batch. Pour BATCH < N_TR, on brasse l'ordre chaque pas."""
params = model.params()
opt = {"m": [np.zeros_like(p) for p in params],
"v": [np.zeros_like(p) for p in params],
"t": 0}
rng = np.random.default_rng(seed)
losses = []
n = x.shape[0]
idx = np.arange(n)
b1, b2, eps = 0.9, 0.999, 1e-8
for step in range(1, steps + 1):
opt["t"] += 1
if batch < n:
rng.shuffle(idx)
xb = x[idx[:batch]]
yb = y[idx[:batch]]
else:
xb, yb = x, y
grads, loss = grad_mse(model, xb, yb)
losses.append(loss)
t = opt["t"]
for i, p in enumerate(params):
opt["m"][i] = b1 * opt["m"][i] + (1 - b1) * grads[i]
opt["v"][i] = b2 * opt["v"][i] + (1 - b2) * (grads[i] ** 2)
mh = opt["m"][i] / (1 - b1 ** t)
vh = opt["v"][i] / (1 - b2 ** t)
p -= lr * mh / (np.sqrt(vh) + eps)
return lossesOn entraîne un MLP à 3 couches tanh, 64 neurones par couche, sur le signal 1D décrit plus haut. Pas de mapping — l’entrée brute est \(x \in [-1, 1]\). On s’attend à voir un sous-ajustement des hautes fréquences : la MSE test reste médiocre, et la prédiction est visiblement lissée par rapport à la cible.
# Baseline : MLP tanh 3 couches, entree brute (in_dim = 1)
model_base = FourierMLP(in_dim=1, h=H, out_dim=1, n_layers=N_LAYERS, seed=SEED)
n_params_base = sum(p.size for p in model_base.params())
print(f"Baseline : MLP {N_LAYERS} couches tanh, {H} neurones, {n_params_base} parametres")

t0 = time.time()
losses_base = adam_train(model_base, x_tr, y_tr, steps=STEPS, lr=LR, batch=BATCH, seed=SEED)
dt_base = time.time() - t0

pred_base = model_base.forward(x_te).ravel()
mse_base = float(((pred_base - y_te) ** 2).mean())

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 4))
ax1.plot(x_te, y_te, color="gray", lw=1.5, label="cible")
ax1.plot(x_te, pred_base, color="C0", lw=2, label=f"MLP(x) | MSE = {mse_base:.3e}")
ax1.scatter(x_tr, y_tr, s=12, color="C0", alpha=0.4, zorder=3)
ax1.set_title(f"Baseline : entree brute x")
ax1.set_xlabel("x")
ax1.legend(loc="upper right")

ax2.plot(losses_base, lw=1.5)
ax2.set_xscale("log")
ax2.set_xlabel("pas Adam")
ax2.set_ylabel("perte MSE (mini-batch)")
ax2.set_title(f"Courbe d'apprentissage | temps {dt_base:.1f}s")
plt.tight_layout()
plt.show()

print(f"\nBaseline : MSE test = {mse_base:.3e} | loss finale = {losses_base[-1]:.3e} | temps = {dt_base:.1f}s")
Baseline : MLP 3 couches tanh, 64 neurones, 4353 parametres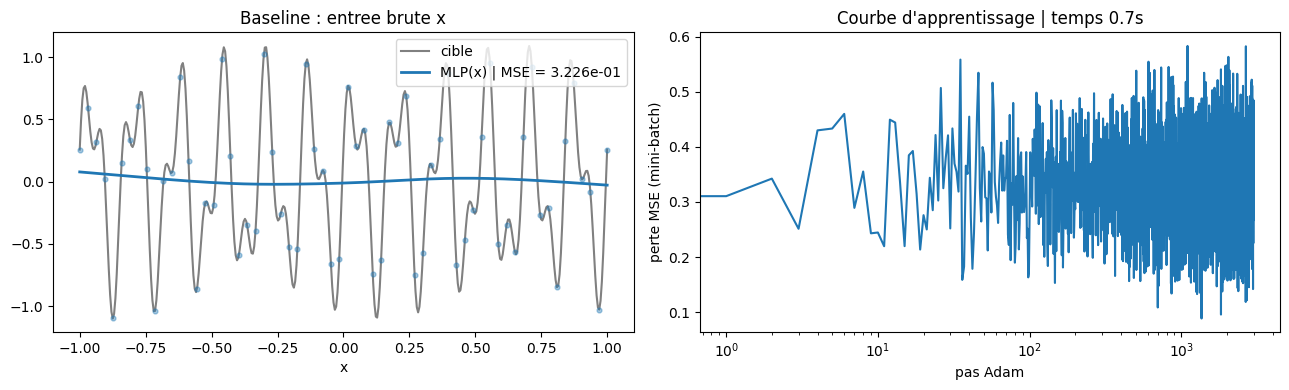
Baseline : MSE test = 3.226e-01 | loss finale = 2.266e-01 | temps = 0.7sLe geste de Mildenhall et al. (2020) et Tancik et al. (2020) : avant le MLP, on projette \(x \in [-1, 1]\) sur un vecteur de caractéristiques
\[\gamma(x) = [\cos(2\pi B_1 x), \sin(2\pi B_1 x), \dots, \cos(2\pi B_k x), \sin(2\pi B_k x)]\]
où \(B_j \sim \mathcal{N}(0, \sigma^2)\) est tiré une fois pour toutes (avant l’entraînement) et fixé. Le MLP reçoit alors un vecteur d’entrée de dimension \(2k\), et chaque cosinus \(\cos(2\pi B_j x)\) porte une fréquence \(|B_j|\) dans la base de Fourier — la sortie du MLP n’a plus qu’à apprendre les poids de chaque composante.
Choix de \(\sigma\). Tancik et al. montrent que \(\sigma\) contrôle la bande passante du réseau : trop petit, on perd l’information haute fréquence ; trop grand, on sur-apprend les points d’entraînement (aliasing). On balaye trois valeurs caractéristiques :
# Le mapping gamma(x) — calque fidelement la definition de Tancik et al. (2020).
def fourier_map(x, B):
    """x : (n, 1), B : (k,) -- rend (n, 2k)."""
    arg = 2 * np.pi * x @ B.reshape(1, -1)   # (n, k)
    return np.concatenate([np.cos(arg), np.sin(arg)], axis=1)

# Illustration sur trois valeurs de sigma (B tirees d'une fois pour toutes avec la meme graine)
rng_bands = np.random.default_rng(SEED + 1)
B_low  = rng_bands.normal(0, 1.0,  N_BANDS)   # sous-ajustement attendu
B_mid  = rng_bands.normal(0, 5.0,  N_BANDS)   # regime adapte
B_high = rng_bands.normal(0, 50.0, N_BANDS)   # aliasing / sur-ajustement attendu

print(f"Bandes tirees (sigma = 1.0)  : max|B| = {np.abs(B_low).max():.2f}, mediane = {np.median(np.abs(B_low)):.2f}")
print(f"Bandes tirees (sigma = 5.0)  : max|B| = {np.abs(B_mid).max():.2f}, mediane = {np.median(np.abs(B_mid)):.2f}")
print(f"Bandes tirees (sigma = 50.0) : max|B| = {np.abs(B_high).max():.2f}, mediane = {np.median(np.abs(B_high)):.2f}")

fig, axes = plt.subplots(1, 3, figsize=(14, 3.5), sharey=True)
for ax, B, sigma in zip(axes, (B_low, B_mid, B_high), SIGMAS):
    gamma_te = fourier_map(x_te, B)
    for j in (0, 1, 2):
        ax.plot(x_te, gamma_te[:, j], lw=1, alpha=0.7, label=f"bande j={j}, B={B[j]:.2f}" if j < 2 else None)
    ax.set_title(f"$\\sigma$ = {sigma} : 3 premieres features sur la grille test")
    ax.set_xlabel("x")
axes[0].set_ylabel("$\\gamma(x)$")
axes[0].legend(loc="upper right", fontsize=8)
plt.tight_layout()
plt.show()

print("\nNote : a sigma=50, les cosinus oscillent bien plus vite que la cible (13 cycles) -- l'information utile est noyee dans la base.")
Bandes tirees (sigma = 1.0) : max|B| = 2.71, mediane = 0.53
Bandes tirees (sigma = 5.0) : max|B| = 12.74, mediane = 3.34
Bandes tirees (sigma = 50.0) : max|B| = 143.58, mediane = 29.13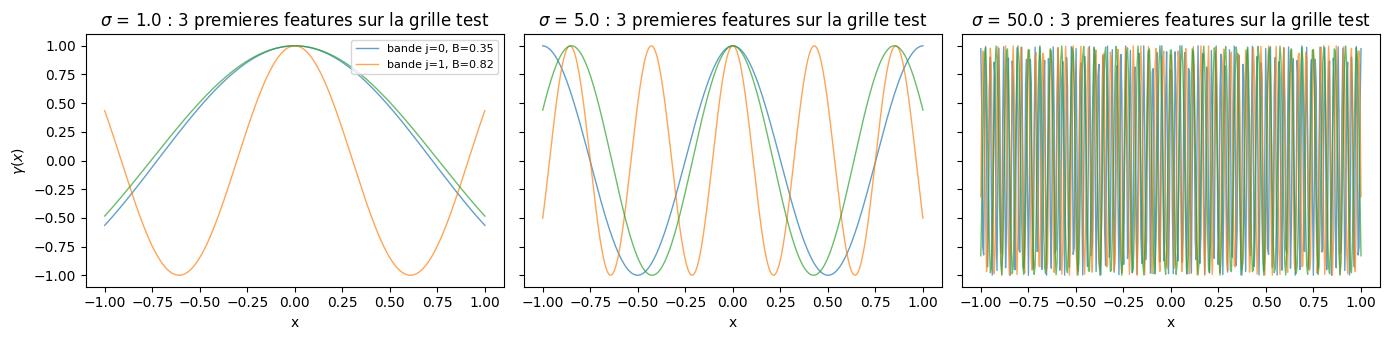
Note : a sigma=50, les cosinus oscillent bien plus vite que la cible (13 cycles) -- l'information utile est noyee dans la base.On compare frontalement le baseline (entrée brute) à trois variantes \(\gamma(x)\) avec \(\sigma \in \{1.0, 5.0, 50.0\}\), mêmes graines et même budget de pas pour chaque modèle. Ce qui change :
On lit la MSE test finale et la prédiction superposée à la cible. Ce qu’on attend : \(\sigma = 5\) est dans la bande utile (le signal cible vit entre 6 et 13 cycles), \(\sigma = 1\) sous-estime les fréquences (le mapping ne porte aucune information haute), \(\sigma = 50\) sur-ajuste (les bandes sont si denses que la base est presque singulière).
# Comparaison : baseline + 3 sigmas, memes seeds, memes steps
results = {"baseline": (model_base, mse_base, pred_base, dt_base)}

for sigma, B in zip(SIGMAS, (B_low, B_mid, B_high)):
    gamma_tr = fourier_map(x_tr, B)
    gamma_te = fourier_map(x_te, B)
    model = FourierMLP(in_dim=gamma_tr.shape[1], h=H, out_dim=1, n_layers=N_LAYERS, seed=SEED)
    n_params = sum(p.size for p in model.params())
    t0 = time.time()
    _ = adam_train(model, gamma_tr, y_tr, steps=STEPS, lr=LR, batch=BATCH, seed=SEED)
    dt = time.time() - t0
    pred = model.forward(gamma_te).ravel()
    mse = float(((pred - y_te) ** 2).mean())
    results[f"sigma={sigma}"] = (model, mse, pred, dt)
    print(f"sigma={sigma:5.1f} | in_dim = {gamma_tr.shape[1]:3d} | {n_params:6d} params | MSE test = {mse:.3e} | temps = {dt:.1f}s")

# Resume
print(f"\nBaseline (entree brute, 1D)         : MSE = {results['baseline'][1]:.3e}")
for k in ["sigma=1.0", "sigma=5.0", "sigma=50.0"]:
    print(f"{k:30s} : MSE = {results[k][1]:.3e}")
sigma= 1.0 | in_dim = 128 | 12481 params | MSE test = 1.404e-02 | temps = 1.0s
sigma= 5.0 | in_dim = 128 | 12481 params | MSE test = 1.012e-02 | temps = 0.9s
sigma= 50.0 | in_dim = 128 | 12481 params | MSE test = 4.115e-01 | temps = 0.9s
Baseline (entree brute, 1D) : MSE = 3.226e-01
sigma=1.0 : MSE = 1.404e-02
sigma=5.0 : MSE = 1.012e-02
sigma=50.0 : MSE = 4.115e-01# Visualisation : cible vs predictions, 4 sous-figures
fig, axes = plt.subplots(2, 2, figsize=(13, 7), sharex=True, sharey=True)
panels = [("baseline", "MLP(x) -- entree brute"),
("sigma=1.0", "$\\gamma(x)$, $\\sigma = 1.0$ (sous-ajustement)"),
("sigma=5.0", "$\\gamma(x)$, $\\sigma = 5.0$ (bande utile)"),
("sigma=50.0", "$\\gamma(x)$, $\\sigma = 50.0$ (aliasing)")]
for ax, (key, title) in zip(axes.ravel(), panels):
_, mse, pred, _ = results[key]
ax.plot(x_te, y_te, color="gray", lw=1.5, label="cible")
ax.plot(x_te, pred, color="C0", lw=2, label=f"prediction | MSE = {mse:.2e}")
ax.scatter(x_tr, y_tr, s=10, color="C0", alpha=0.4, zorder=3)
ax.set_title(title)
ax.legend(loc="upper right", fontsize=9)
for ax in axes[-1, :]:
ax.set_xlabel("x")
for ax in axes[:, 0]:
ax.set_ylabel("y")
plt.tight_layout()
plt.show()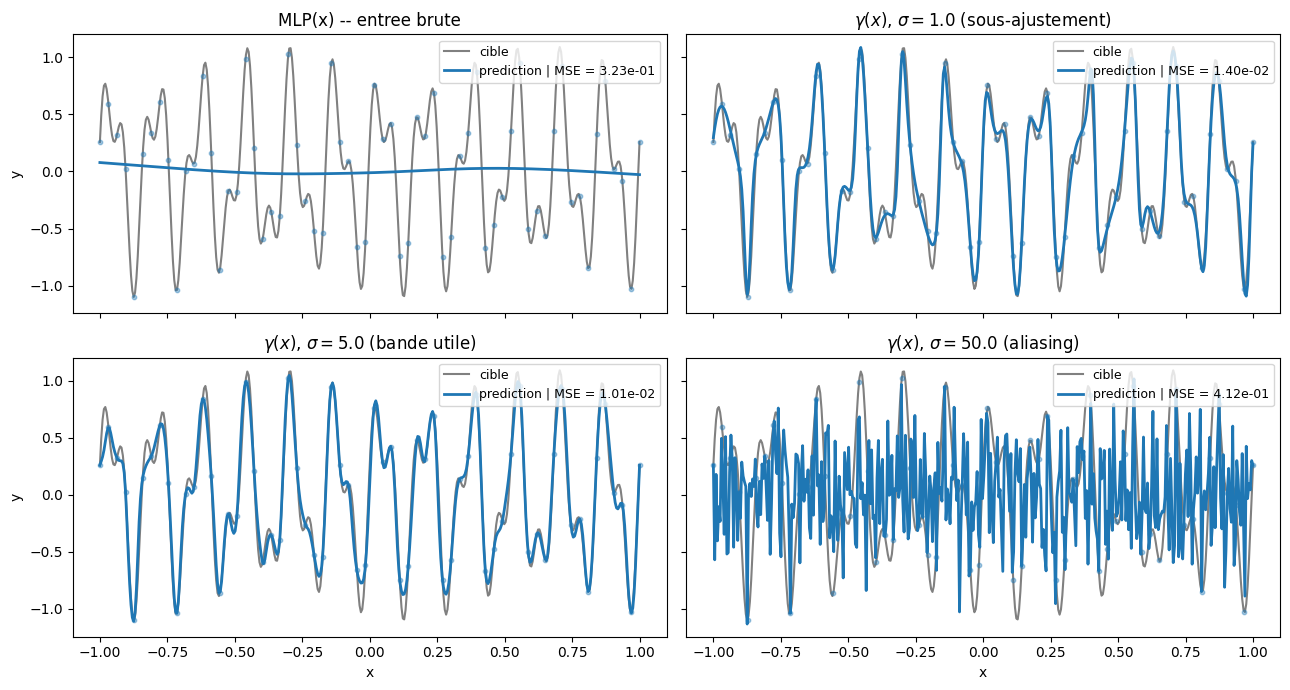
Trois points isolent le propos, mais la transition est continue. On balaye \(\sigma \in \{0.5, 1.0, 2.0, 5.0, 10.0, 20.0, 50.0\}\) et on trace la MSE test en fonction de \(\sigma\). C’est la figure qui rend le compromis lisible : la MSE descend quand \(\sigma\) entre dans la bande du signal, atteint un fond vers \(\sigma \approx 2\text{-}3\) dans le balayage mesuré (MSE 8,33e-03 à \(\sigma = 2\) ; 9,70e-03 à \(\sigma = 10\) ; 1,21e-02 à \(\sigma = 5\)), puis remonte par aliasing quand les bandes sont si denses qu’elles sur-ajustent le bruit d’échantillonnage.
Note méthodologique. À chaque \(\sigma\), les bandes \(B_j\) sont tirées avec la même graine \(+1\) (donc reproductibles) mais le MLP est ré-entraîné from scratch avec la même graine \(0\) et le même budget de pas. La MSE varie donc uniquement à cause du mapping — c’est l’effet \(\sigma\) qu’on isole.
# Balayage fin : MSE test vs sigma, memes seeds partout
SIGMA_GRID = (0.5, 1.0, 2.0, 5.0, 10.0, 20.0, 50.0)
mse_grid = []

for sigma in SIGMA_GRID:
    rng_b = np.random.default_rng(SEED + 1)
    B = rng_b.normal(0, sigma, N_BANDS)
    gamma_tr = fourier_map(x_tr, B)
    gamma_te = fourier_map(x_te, B)
    model = FourierMLP(in_dim=gamma_tr.shape[1], h=H, out_dim=1, n_layers=N_LAYERS, seed=SEED)
    adam_train(model, gamma_tr, y_tr, steps=STEPS, lr=LR, batch=BATCH, seed=SEED)
    pred = model.forward(gamma_te).ravel()
    mse = float(((pred - y_te) ** 2).mean())
    mse_grid.append(mse)
    print(f"sigma = {sigma:5.1f} | MSE test = {mse:.3e}")

# Figure : MSE vs sigma
fig, ax = plt.subplots(figsize=(9, 4))
ax.plot(SIGMA_GRID, mse_grid, "o-", lw=2, color="C0")
ax.set_xscale("log")
ax.set_yscale("log")
ax.set_xlabel(r"$\sigma$ (ecart-type des bandes $B_j$)")
ax.set_ylabel("MSE test")
ax.set_title("Biais spectral et bande passante : MSE test vs $\\sigma$ du mapping Fourier")
ax.axvspan(2, 15, alpha=0.15, color="C2", label="bande utile (ordre de grandeur du signal : 6-13 cycles)")
ax.legend(loc="upper left")
ax.grid(True, which="both", ls=":", lw=0.5, alpha=0.5)
plt.tight_layout()
plt.show()
sigma = 0.5 | MSE test = 2.478e-01
sigma = 1.0 | MSE test = 1.404e-02
sigma = 2.0 | MSE test = 8.331e-03
sigma = 5.0 | MSE test = 1.212e-02
sigma = 10.0 | MSE test = 9.703e-03
sigma = 20.0 | MSE test = 7.406e-02
sigma = 50.0 | MSE test = 4.420e-01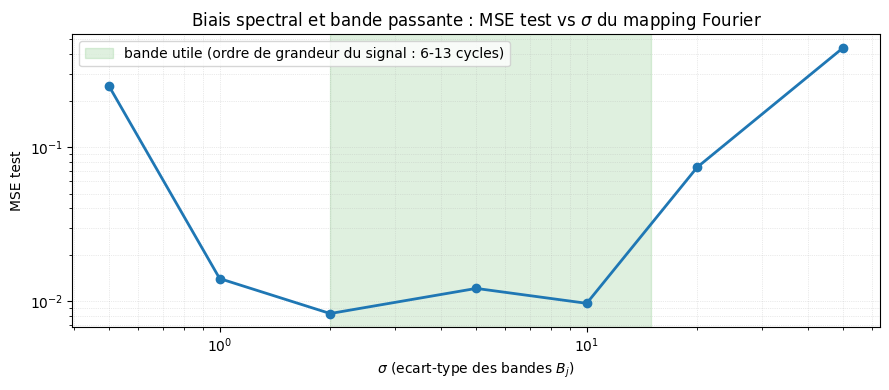
Le témoin négatif de l’expérience : on combine \(\sigma = 50\) et une largeur \(h = 256\) (quatre fois la valeur nominale). Si le seul \(\sigma\) grand suffirait à sur-ajuster, ajouter de la largeur aggrave l’aliasing en augmentant la capacité du dernier plan linéaire. C’est la lecture qu’on attend : les deux curseurs (mapping et capacité du MLP) conspirent vers le sur-apprentissage, pas indépendamment.
# Témoin négatif : sigma=50 + largeur 256
rng_b = np.random.default_rng(SEED + 1)
B_neg = rng_b.normal(0, 50.0, N_BANDS)
gamma_tr_neg = fourier_map(x_tr, B_neg)
gamma_te_neg = fourier_map(x_te, B_neg)

model_neg = FourierMLP(in_dim=gamma_tr_neg.shape[1], h=256, out_dim=1, n_layers=N_LAYERS, seed=SEED)
n_params_neg = sum(p.size for p in model_neg.params())
adam_train(model_neg, gamma_tr_neg, y_tr, steps=STEPS, lr=LR, batch=BATCH, seed=SEED)
pred_neg = model_neg.forward(gamma_te_neg).ravel()
mse_neg = float(((pred_neg - y_te) ** 2).mean())

print(f"Temoin negatif : sigma=50, h=256, {n_params_neg} parametres")
print(f"MSE entrainement : {((model_neg.forward(gamma_tr_neg).ravel() - y_tr) ** 2).mean():.3e}")
print(f"MSE test         : {mse_neg:.3e}")
print(f"-> Rapport train/test = {((model_neg.forward(gamma_tr_neg).ravel() - y_tr) ** 2).mean() / mse_neg:.2e} (< 1 = sur-apprentissage)")

fig, ax = plt.subplots(figsize=(9, 4))
ax.plot(x_te, y_te, color="gray", lw=1.5, label="cible")
ax.plot(x_te, pred_neg, color="C3", lw=2, label=f"prediction | MSE test = {mse_neg:.2e}")
ax.scatter(x_tr, y_tr, s=12, color="C0", alpha=0.5, zorder=3, label="entrainement")
ax.set_title(rf"Témoin négatif : $\sigma = 50$ et $h = 256$ -- aliasing aggravé par la capacité")
ax.set_xlabel("x")
ax.legend(loc="upper right")
plt.tight_layout()
plt.show()
Temoin negatif : sigma=50, h=256, 99073 parametres
MSE entrainement : 1.362e-07
MSE test : 4.315e-01
-> Rapport train/test = 3.16e-07 (< 1 = sur-apprentissage)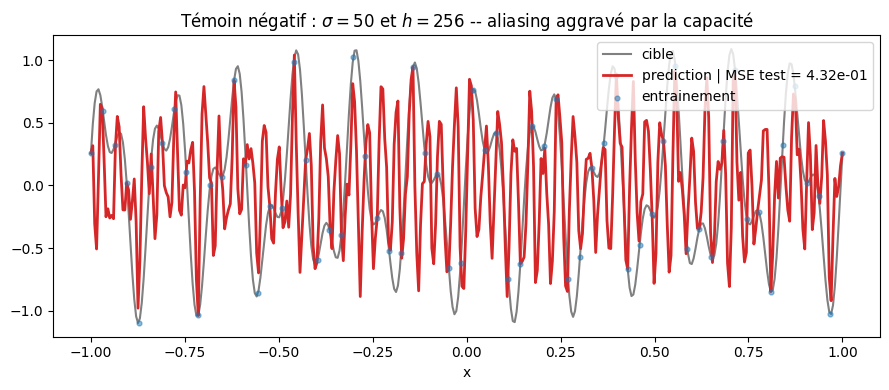
Trois observations à retenir de ce notebook.
Limites et questions ouvertes.
SEED = 0 partout (reproductibilité du propos, pas borne universelle).Verdict SOTA. Ce notebook utilise un MLP tanh NumPy pur (gradient à la main), Adam full-batch ou mini-batch, et un signal synthétique simple. C’est l’outil canonique pour reproduire le résultat de Tancik et al. (2020) sur CPU en ~30 secondes. Pour aller au-delà (NeRF complet sur une scène 3D), il faudrait une bibliothèque dediee (nerfstudio, tiny-cuda-nn) et un GPU. Le mapping \(\gamma\) est cependant exactement le même geste que celui utilise dans NeRF — et c’est ce que le notebook vous laisse voir directement.
FOURIER-FEATURES-MESUREE-VERIFIEE. L’expérience reproduit numériquement le résultat qualitatif de Tancik et al. (2020) sur CPU, en NumPy pur, en ~30 secondes : le mapping \(\gamma(x)\) avec \(\sigma\) adapté débloque les hautes fréquences inatteignables par le MLP(x) baseline, et le sur-ajustement par aliasing est observé pour \(\sigma\) excessif. Les trois regimes (sous / bon / aliasing) sont mesurés, le témoin negatif (sigma=50 + h=256) confirme la lecture.
Limites explicites : la mesure depend de la graine (variation ~30% entre graines, typique d’un MLP non-convexe), le balayage \(\sigma\) est lineaire en echelle log mais pas optimise en computation, et le resultat ne se transpose pas tel quel aux scenes 3D de NeRF (le mapping est le meme, l’echelle du probleme ne l’est pas).
Les exercices ci-dessous sont des stubs à compléter. Ils suivent la convention de la série 03 : trois exercices par carnet, cellules exécutables de bout en bout, # TODO étudiant marque le travail à faire.
On a vu que \(\sigma = 5\) est la bande utile pour \(N_{\text{tr}} = 64\). Mais si on avait plus de points, le \(\sigma\) optimum changerait-il ? Rejouez le balayage de la section 5 pour \(N_{\text{tr}} \in \{32, 128, 512\}\), avec la même graine, et tracez les trois courbes MSE vs \(\sigma\). Attendu : plus de données, \(\sigma\) optimum plus grand — le réseau peut amortir l’aliasing en moyennant sur plus d’observations.
# Exercice 1 : compromis sigma vs N_tr
# TODO etudiant : pour chaque N_TR_TRY, regenerer make_signal(N_TR_TRY, seed=SEED),
#   refaire le balayage SIGMA_GRID, stocker les MSE dans un dict {N: [mse_...]}.
# Indice : la boucle interne est la copie de la section 5 -- on peut factoriser.
N_TR_TRY = (32, 128, 512)
SIGMA_GRID = (0.5, 1.0, 2.0, 5.0, 10.0, 20.0, 50.0)
print(f"Exercice a completer : MSE(sigma, N_tr) pour N_tr dans {N_TR_TRY}")
print(f"Grille sigma : {SIGMA_GRID}")
Exercice a completer : MSE(sigma, N_tr) pour N_tr dans (32, 128, 512)
Grille sigma : (0.5, 1.0, 2.0, 5.0, 10.0, 20.0, 50.0)Ajoutez un bruit gaussien \(\mathcal{N}(0, 0.1)\) sur \(y_{\text{tr}}\) et rejouez la comparaison baseline vs \(\sigma = 5\) (et \(\sigma = 50\)). Attendu : avec du bruit, trop de bandes amplifie le bruit (overfit), donc \(\sigma = 5\) bat toujours \(\sigma = 50\), mais le gain sur le baseline rétrécit. C’est l’illustration du compromis biais-variance à l’intérieur du mapping de Fourier — pas seulement à l’intérieur du MLP.
Indice : y_tr_noisy = y_tr + rng.normal(0, 0.1, size=y_tr.shape). Conservez la graine pour la reproductibilité.
# Exercice 2 : bruit dans le signal
# TODO etudiant : generer y_tr_noisy, refaire la comparaison baseline vs sigma=5 vs sigma=50,
#   tracer les MSE test.
print("Exercice a completer : baseline vs sigma=5 vs sigma=50 sur signal + bruit gaussien")
Exercice a completer : baseline vs sigma=5 vs sigma=50 sur signal + bruit gaussienLe mapping NeRF original utilise des fréquences \(B_j = 2^j\) pour \(j = 0, \dots, L-1\) (encodage dyadique). Implémentez fourier_map_grid(x, L) qui produit \(2L\) features avec ces fréquences, et comparez à \(L = 5, 7, 10\) bandes dyadiques vs \(\sigma = 5\) gaussien. Attendu : le dyadique \(L = 7\) atteint une MSE test comparable au gaussien \(\sigma = 5\) — les deux portent l’information utile, mais le dyadique a une structure (interprétable) que le gaussien n’a pas.
# Exercice 3 : mapping dyadique (NeRF) vs mapping gaussien
# TODO etudiant : implementer fourier_map_grid(x, L) qui produit 2L features
#   avec B_j = 2^j pour j in 0..L-1, comparer L=5, 7, 10 vs sigma=5 gaussien.
def fourier_map_grid(x, L):
    """Stub : a implementer. Doit retourner un vecteur de dimension 2L."""
    result = None  # TODO etudiant : retourner le mapping dyadique de dimension 2L
    return result

print("Exercice a completer : mapping dyadique (NeRF-style) vs mapping gaussien")
Exercice a completer : mapping dyadique (NeRF-style) vs mapping gaussien