ICT-41b — Crosscoder : diffuser deux modèles, distilled reasoning vs base
Arc A2 — géométrie du latent (Epic #16741), suite directe d’ICT-41, SAE mono-modèle (issue #16747, en cours d’intégration via la PR #16859). Paper source : R05 — Baek & Tegmark, Towards Understanding Distilled Reasoning Models: A Representational Approach (arXiv:2503.03730).
ICT-41 isolait la géométrie d’UN modèle avec un SAE. Ici on met deux modèles côte à côte dans un même dictionnaire de features : le modèle distillé DeepSeek-R1-Distill-Qwen-1.5B (qui a « appris à raisonner » par distillation de traces DeepSeek-R1) et sa base Qwen2.5-Math-1.5B (avant distillation). L’outil est le crosscoder : chaque feature possède un décodeur par modèle, et le rapport des normes des décodeurs — le NRN — dit si une feature est partagée (les deux modèles l’utilisent pareil), distillée-only (le distillé l’a acquise pendant la distillation) ou base-only.
La question causale du papier : les features distillées-only portent-elles le comportement « over-thinking » du raisonnement long ? On la teste à échelle mini — et on verra que certaines réponses du papier ne se reproduisent pas à cette échelle : c’est précisément l’intérêt méthodologique.
Statut épistémique — Sans verdict à ce jour : aucune ligne de la matrice de dissociations ne concerne ce notebook ; son statut épistémique sera porté par la matrice le cas échéant.
Prérequis & avertissement d’exécution
GPU requis (~4 Go de VRAM libres) — deux modèles 1.5B chargés séquentiellement en bf16, puis en lockstep CPU+GPU pour l’ablation causale. Environnement : coursia-ml-training (torch 2.6 + transformers 5.2 + datasets 5.0).
Durée totale ~20-25 min : capture d’activations (~8 min), entraînement du crosscoder (~6 min), analyses, ablation lockstep (~4 min).
Les poids Hugging Face (7 Go au total) sont attendus dans le cache HF local ; sinon le premier téléchargement les récupère. On fixe HF_HOME vers le cache provisionné de la machine si absent.
Échelle mini assumée : 307 200 tokens capturés vs 200 M dans le papier, dictionnaire K=4096 vs 32768. Chaque section signale honnêtement ce que l’échelle permet et ne permet pas de conclure.
import json, os, timeimport numpy as npos.environ.setdefault("HF_HOME", "D:/hf-cache-crosscoder")os.environ.setdefault("CUBLAS_WORKSPACE_CONFIG", ":4096:8")import torch# Determinisme strict (patron flotte QC) : sans lui, chaque re-execution# re-entraine un crosscoder legerement different et les lectures chiffrees# du notebook seraient perimees des la passe suivante.torch.use_deterministic_algorithms(True)torch.backends.cudnn.deterministic =Truetorch.backends.cudnn.benchmark =Falsetorch.backends.cuda.matmul.allow_tf32 =Falsetorch.backends.cudnn.allow_tf32 =Falseimport tempfileWORK = os.path.join(tempfile.gettempdir(), "ict42")os.makedirs(WORK, exist_ok=True)SEED =0torch.manual_seed(SEED)np.random.seed(SEED)print("cuda:", torch.cuda.is_available(), "| work:", WORK)
Notation : \(i \in \{A, B\}\) avec \(A\) = base, \(B\) = distillé ; \(a^{(i)}(x_j)\) = activation du residual stream en entrée de la couche mi-profondeur (couche 14 sur 28 pour nos deux modèles) au token \(x_j\).
La perte (5) couple reconstruction (MSE) et parcimonie pondérée par l’activation — chaque feature paie \(\sum_i \lVert W_{\mathrm{dec}}^{(i),k}\rVert_2\) proportionnellement à \(f_k(x_j)\) :
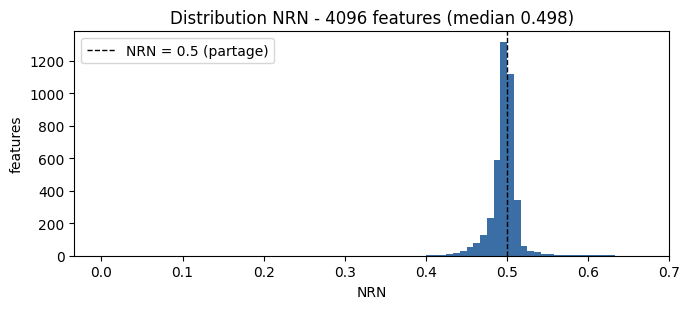
Lecture du NRN : \(0{,}5\) = partagé ; \(\to 1\) = distillée-only ; \(\to 0\) = base-only. C’est l’axe qui trie tout le notebook.
N_TRACES, MAX_TOK =800, 384# corpus mini : 307 200 tokensK_FEATURES, STEPS, LAM, LR, BS =4096, 8000, 2e-3, 1e-3, 2048THRESH_SURGICAL, THRESH_WIDE =0.6, 0.5PAIR = [("distilled", "deepseek-ai/DeepSeek-R1-Distill-Qwen-1.5B"), ("base", "Qwen/Qwen2.5-Math-1.5B")]print(f"corpus {N_TRACES} traces x {MAX_TOK} tok max, K={K_FEATURES}, "f"steps={STEPS}, lambda={LAM}")
corpus 800 traces x 384 tok max, K=4096, steps=8000, lambda=0.002
2. Corpus : les traces OpenThoughts, pas les énoncés
R05 entraîne son crosscoder sur 200 M de tokens d’open-thoughts/OpenThoughts-114k — des traces de raisonnement générées par DeepSeek-R1. Détail de schéma qui a son importance : le dataset est au format ShareGPT (conversations : tours user/assistant), pas un champ problem.
On capture donc énoncé + début de trace (384 tokens) : c’est dans la trace que vivent les marqueurs « Wait », « Therefore », « Alternatively », « But » qui serviront à l’annotation. On filtre le boilerplate TACO (des dizaines d’énoncés identiques « Generate an executable Python function… ») et les doublons.
from datasets import load_datasetTACO ="Generate an executable Python function"ds = load_dataset("open-thoughts/OpenThoughts-114k", split="train", streaming=True)texts, seen = [], set()for ex in ds: conv = ex.get("conversations") or []iflen(conv) <2or conv[0].get("from") !="user"or conv[1].get("from") !="assistant":continue user, asst = conv[0]["value"].strip(), conv[1]["value"].strip()ifnot (40<=len(user) <=600) or user.startswith(TACO) or user in seen:continue seen.add(user) texts.append(user +"\n\n"+ asst)iflen(texts) >= N_TRACES:breakassertlen(texts) >= N_TRACES //2json.dump(texts, open(os.path.join(WORK, "texts.json"), "w", encoding="utf-8"), ensure_ascii=False)print("traces retenues:", len(texts))
traces retenues: 800
Exercice 1 — un sélecteur mono-domaine
Le corpus ci-dessus mélange maths, code, sciences. Pour cibler les features de raisonnement mathématique, écrire select_math(texts) qui ne garde que les traces dont l’énoncé contient au moins un indice mathématique (par ex. $, \(, equation, integer, triangle…), puis relancer la capture sur ce sous-corpus et comparer la distribution NRN.
Indice : inspecter texts[:20] pour voir à quoi ressemblent les énoncés ; la comparaison NRN se fait avec la cellule histogramme de la section 4.
def select_math(texts, min_len=40):# TODO etudiant : retourner la sous-liste des traces mathematiques# Etape 1 : definir une liste de mots-indices (equation, integer, triangle, ...)# Etape 2 : ne garder que texts contenant au moins un indice# Etape 3 : verifier qu'il reste assez de traces (>100) sinon elargir result =None# TODO etudiantreturn resultsel = select_math(texts)print("Exercice a completer - select_math renvoie:", sel)
Exercice a completer - select_math renvoie: None
3. Capture du residual stream, couche mi-profondeur
Les deux modèles partagent la même famille de tokenizer (Qwen2.5) : sur nos 4 prompts de fumée, les ids étaient identiques token à token — condition nécessaire pour aligner les positions des deux modèles dans le crosscoder. On capture hidden_states[mid] = l’entrée de la couche 14 (sur 28), en bf16 GPU, séquentiellement.
from transformers import AutoModelForCausalLM, AutoTokenizerdef capture(role, repo, texts): tok = AutoTokenizer.from_pretrained(repo) model = AutoModelForCausalLM.from_pretrained(repo, dtype=torch.bfloat16, device_map="cuda").eval() mid = model.config.num_hidden_layers //2 rows, seg = [], [] torch.cuda.reset_peak_memory_stats()with torch.no_grad():for t in texts: enc = tok(t, return_tensors="pt", truncation=True, max_length=MAX_TOK).to("cuda") out = model(**enc, output_hidden_states=True) rows.append(out.hidden_states[mid][0].float().cpu().numpy()) seg.append(len(enc.input_ids[0])) acts = np.concatenate(rows, axis=0) d_model = model.config.hidden_size pic =round(torch.cuda.max_memory_allocated() /2**20)del model; torch.cuda.empty_cache() np.save(os.path.join(WORK, f"acts_{role}.npy"), acts) np.save(os.path.join(WORK, f"seg_{role}.npy"), np.asarray(seg, dtype=np.int32))print(f"{role}: mid={mid} d={d_model} tokens={acts.shape[0]} VRAMpic={pic}MiB")return actst0 = time.time()acts = {}for role, repo in PAIR: acts[role] = capture(role, repo, texts)print(f"capture en {time.time()-t0:.0f}s")
base: mid=14 d=1536 tokens=307200 VRAMpic=3288MiB
capture en 138s
Lecture (ancrée sur cette exécution). VRAM pic : 3 734 MiB (distillé) puis 3 288 MiB (base) — la cohabitation avec le serveur d’embeddings résident est juste, d’où le chargement séquentiel et le empty_cache() entre les deux ; capture totale ~2,5 min. Les 800 tronçons de 384 tokens donnent exactement 307 200 positions par modèle. L’alignement des tokenizers a été vérifié en amont (ids égaux sur prompts témoins) : la position \(j\) désigne le même token pour \(A\) et \(B\).
4. Le mini-crosscoder (Eq 3-5)
Implémentation littérale : encodeurs \(W_{\mathrm{enc}}^{(A)}, W_{\mathrm{enc}}^{(B)}\) (le ReLU agit sur la somme des deux projections), décodeurs \(W_{\mathrm{dec}}^{(A)}, W_{\mathrm{dec}}^{(B)}\), pénalité de parcimonie = normes L2 des colonnes décodeur pondérées par \(f_k\). Adam + cosine, 8000 pas, lots de 2048 positions.
Lecture (ancrée sur cette exécution). Trois chiffres à retenir du run : EV 0,988 base / 0,976 distillé (le crosscoder reconstruit presque tout le stream), 17,8 % de features mortes, densité d’activation ~2,8 % en fin d’entraînement. La distribution NRN est piquée à 0,498 — comme la Fig. 1 du papier : la grande majorité des features sont partagées, avec une queue fine de chaque côté (0,9 % au-dessus de 0,55, 2,1 % en dessous de 0,45).
Leçon d’échelle (vérifiée en amont) : avec 64k tokens et \(\lambda = 3\cdot10^{-4}\), la queue distilled-only est vide (0 feature > 0,55) — il a fallu monter à ~300k tokens et\(\lambda = 2\cdot10^{-3}\) pour la voir émerger, au prix d’un léger recul de l’EV. La spécialisation des décodeurs n’est pas gratuite : c’est la parcimonie qui la force.
Exercice 2 — NRN en normes L2
L’Eq 6 utilise les normes L1 des décodeurs. Recalculer le NRN avec les normes L2 (W_dd.norm(dim=0) au lieu de W_dd.abs().sum(0)) et comparer : le classement des 10 features distilled-only change-t-il ? Quelques features passent-elles le seuil 0,55 dans un sens ou l’autre ?
Indice : np.argsort sur les deux versions ; comparer les ensembles avec np.intersect1d.
def nrn_with(norm_fn):# TODO etudiant : renvoyer le vecteur NRN (Eq 7) avec la norme demandee# Etape 1 : rdn = norm_fn(W_dd) / norm_fn(W_db) (colonnes decoder)# Etape 2 : nrn = rdn / (1 + rdn) result =None# TODO etudiantreturn resultnrn_l2 = nrn_with(lambda W: W.norm(dim=0))print("Exercice a completer - nrn_l2 =", Noneif nrn_l2 isNoneelse nrn_l2.shape)
Exercice a completer - nrn_l2 = None
5. Annotation : où les features distilled-only s’activent-elles ?
Deux jambes d’annotation : (i) la fenêtre d’activation maximale de chaque top-feature (à la Table 1 du papier), (ii) un test quantitatif d’enrichissement — les positions des marqueurs « Wait / Therefore / Alternatively / But » sont-elles plus activées que les autres sur les features distilled-only ?
from transformers import AutoTokenizertok = AutoTokenizer.from_pretrained(PAIR[1][1])MARKERS = {"Wait": [], "Therefore": [], "Alternatively": [], "But": []}off =0for t, L inzip(texts, np.load(os.path.join(WORK, "seg_base.npy"))): ids = tok(t, return_tensors="pt", truncation=True, max_length=MAX_TOK).input_ids[0]for p, s inenumerate(tok.convert_ids_to_tokens(ids)): clean = s.replace("Ġ", "").replace("Ċ", " ")for mk in MARKERS:if clean == mk or (clean.startswith(mk) andlen(clean) <=len(mk) +2): MARKERS[mk].append(off + p) off +=int(L)for mk, v in MARKERS.items():print(f"marqueur {mk}: {len(v)} positions")
Lecture — un résultat MIXTE, affiché tel quel (ancré sur cette exécution). Sur nos 36 features distilled-only, le ratio d’enrichissement vaut Therefore 1,68 · But 0,95 · Alternatively 0,71 · Wait 0,54 : un seul marqueur sur quatre (Therefore, \(n = 103\) positions) est réellement enrichi, les trois autres sont neutres ou déplétés. Là où le crosscoder 32768-features/200M-tokens du papier trouve des features « self-reflection » qui tirent les « Wait », le nôtre n’offre qu’un signal partiel et fragile : l’enrichissement Therefore repose sur peu de positions, et le marqueur le plus iconique du R1 (« Wait ») est au contraire déplété (0,54).
C’est la jambe 2 de la leçon méthodo (section 8) : une fenêtre d’activation suggère, un test quantitatif décide — et ici il décide « signal partiel, pas la lecture sémantique du papier ». Afficher « les features distilled-only capturent le raisonnement » sur la seule base de Therefore aurait été de la complaisance ; afficher les quatre ratios est la mesure honnête.
order = np.argsort(-nrn)picks =list(order[:6])offs, all_ids = [], []o =0for t in texts: ids = tok(t, return_tensors="pt", truncation=True, max_length=MAX_TOK).input_ids[0] offs.append((o, o +len(ids))); all_ids.append(ids); o +=len(ids)f_pick = torch.zeros(n, len(picks), device="cuda")with torch.no_grad(): CH =131072for s inrange(0, n, CH): f_c = torch.relu(a_b[s:s+CH] @ W_eb.T + a_d[s:s+CH] @ W_ed.T + b_e) f_pick[s:s+CH] = f_c[:, picks]for j, k inenumerate(picks): pos =int(f_pick[:, j].argmax()) ti =next(i for i, (s0, _) inenumerate(offs) if s0 <= pos < offs[i][1]) s0, _ = offs[ti] lo, hi =max(0, pos - s0 -22), pos - s0 +8 win = tok.decode(all_ids[ti][lo:hi]).replace("\n", " ")print(f"[k={k}] NRN={nrn[k]:.3f} actmax={float(f_pick[pos, j]):.1f}")print(f" ...{win}...")
[k=3697] NRN=0.667 actmax=20.6
    ...Return your final response within \boxed{}. One tourist covers a distance of 20 km 2...
[k=131] NRN=0.638 actmax=18.3
    ... minimum value of \( 3(f(x))^2 + 2 g(x) \) is \( -\frac{19}{6} \...
[k=3561] NRN=0.630 actmax=17.0
    ... Some Cs are upper-case and some are lower-case, and each is written in one of two colors, green and yellow. It is given that there...
[k=1062] NRN=0.626 actmax=22.5
    ... who can't split a pile anymore. We need to determine if the first player can guarantee a win, and if so, how they should play.  ...
[k=1894] NRN=0.623 actmax=42.9
    ...sin x \). So, it's a product of two terms: \( a \cos^2 x - 3 \) and \( \sin...
[k=3282] NRN=0.617 actmax=19.3
    ... The hypotenuse \( BC \) has length \( a \), and the altitude from \( A \) to \( BC \) has length \(...
Lecture des fenêtres (cette exécution). Les top-features distilled-only (NRN 0,62-0,67) s’ancrent sur des énoncés mathématiques structurés : instruction de format \boxed{} (k=3697), extremum \(3f(x)^2+2g(x)\) (k=131), coloration vert/jaune de lettres (k=3561), jeu de partages « who can’t split a pile anymore… first player guarantee a win » (k=1062), identité trigonométrique (k=1894), hypoténuse et altitude (k=3282). La spécialisation distillée s’est donc portée sur la structure des problèmes, pas sur les marqueurs Wait/Therefore purs que la Table 1 du papier isole à 200M tokens — cohérent avec l’enrichissement partiel mesuré juste avant.
6. Ablation causale lockstep — « What is 5 - 1? »
La jambe causale : pendant la génération du modèle distillé, on retire du residual stream (entrée couche 14) la contribution des features ablatées :
\[h' = h - \sum_{k \, \mathrm{ablatées}} f_k \cdot W_{\mathrm{dec}}^{(B),k}\]
Intervention delta chirurgicale — on ne remplace pas le stream par la reconstruction, on ne soustrait que les features ciblées. Le crosscoder exige les activations des deux modèles : le base tourne sur CPU en lockstep (la VRAM est déjà occupée). Deux seuils : chirurgical (NRN > 0,6, 11 features) et large (NRN > 0,5, seuil du papier, 1 665 features ≈ 41 % du dictionnaire).
--- baseline (aucune): 79 tokens ---
 5 minus 1 is 4. So, the answer is 4. |  |  | To find the value of \(5 - 1\), follow these steps: |  | 1. **Subtract the numbers:** |    \[ |    5 - 1 = 4 |    \] |  | 2. **Conclusion:** |    \[ |    \boxed{4} |    \]
[chirurgical NRN>0.6: 11 features ablatees, 55s]
--- chirurgical NRN>0.6: 79 tokens ---
 5 minus 1 is 4. So, the answer is 4. |  |  | To find the value of \(5 - 1\), follow these steps: |  | 1. **Subtract the numbers:** |    \[ |    5 - 1 = 4 |    \] |  | 2. **Final Answer:** |    \[ |    \boxed{4} |    \]
[large NRN>0.5 (seuil papier): 1665 features ablatees, 162s]
--- large NRN>0.5 (seuil papier): 150 tokens ---
 Let's see. Okay, so I have 5 apples, and I eat one. How does that make? Hmm, maybe I should think about it in terms of numbers. So, 5 minus 1 is... 4? Wait, no, that's not right. 5 minus 1 is is 4? Or is it 5? Wait, no, 5 minus 1 is is 4? Wait, no, 5 minus 1 is is 4? Wait, no, 5 minus 1 is is 4? Wait, no, 5 minus 1 is is 4? Wait, no, 5 minus 1 is is 4? Wait, no, 5 minus
Lecture (ancrée sur cette exécution). Trois régimes nettement séparés :
Régime
Features ablatées
Durée
Tokens générés
Comportement
baseline
0
—
79
réponse directe, déjà concise
chirurgical NRN > 0,6
11
≈1 min
79
préservé (dérive cosmétique : « Final Answer » au lieu de « Conclusion »)
large NRN > 0,5
1665
≈3 min
150 (plafond)
dégénérescence en boucle : « 5 minus 1 is is 4? Wait, no… » répété, pas d’EOS
Deux enseignements honnêtes : (1) ce checkpoint 1.5B ne sur-réfléchit pas sur « What is 5 - 1? » en décodage glouton — la baseline fait 79 tokens, il n’y a rien à « raccourcir », le terrain du papier (over-thinking visible) n’est pas reproduit ici ; (2) l’ablation au seuil large du papier, appliquée à un crosscoder mini, détruit la génération (boucle de répétition) au lieu de l’épurer — la revendication causale du papier repose sur un crosscoder entraîné sur 600× plus de tokens. La jambe causale réfute la transposition naïve : c’est exactement pourquoi on la montre.
7. Parallelogram loss — la géométrie sémantique (exercice CPU)
Dernière mesure du papier (Fig. 4) : sur des quadruples d’analogies \((a, b, c, d)\) (genre : man:woman :: king:queen), on PCA les activations puis on mesure \(\lVert E_a - E_b + E_c - E_d \rVert\) — un parallélogramme parfait l’annule. Le papier constate que le distillé 14B bat sa base : des représentations plus structurées. Version mini : mots mono-token, activations mi-couche, PCA sur les mots du quadruple.
QUADS = [("man", "woman", "king", "queen"), ("paris", "france", "berlin", "germany"), ("rome", "italy", "madrid", "spain"), ("walk", "walked", "swim", "swam"), ("big", "bigger", "small", "smaller"), ("slow", "slower", "fast", "faster")]ok_quads = [q for q in QUADS ifall(len(tok(" "+ w).input_ids) ==1for w in q)]print(f"{len(ok_quads)}/{len(QUADS)} quadruples mono-token:", ["|".join(q) for q in ok_quads])def word_act(model_repo, words): m2 = AutoModelForCausalLM.from_pretrained(model_repo, dtype=torch.bfloat16, device_map="cuda").eval() mid2 = m2.config.num_hidden_layers //2 out = {}with torch.no_grad():for w in words: enc = tok(" "+ w, return_tensors="pt").to("cuda") o = m2(**enc, output_hidden_states=True) out[w] = o.hidden_states[mid2][0, -1].float().cpu().numpy()del m2; torch.cuda.empty_cache()return outwords =sorted({w for q in ok_quads for w in q})acts_w = {role: word_act(repo, words) for role, repo in PAIR}for role in acts_w:print(role, "captures")
def parallelogram_loss(act_dict, quad):# PCA sur les 4 mots du quadruple (a 4 points, PCA -> 3 dims utiles) E = np.stack([act_dict[w] for w in quad]) E = E - E.mean(0) U, S, Vt = np.linalg.svd(E, full_matrices=False) Ep = E @ Vt[:3].T a, b, c, d = Epreturnfloat(np.linalg.norm(a - b + c - d) / (S[0] +1e-9))GENRE = ("man", "woman", "king", "queen")for role in acts_w:ifall(w in acts_w[role] for w in GENRE):print(f"{role}: parallelogram genre = {parallelogram_loss(acts_w[role], GENRE):.4f}")
Exercice 3 — parallelogram loss sur la classe capitale-pays
La cellule précédente calcule la perte du parallélogramme pour la classe genre : distillé 1,0832 vs base 1,0694 — à cette échelle la base est (très légèrement) plus structurée, l’inverse du constat 14B du papier : un seul quadruple, verdict illustratif. À vous pour la classe capitale-pays (le quadruple paris|france|berlin|germany est le seul mono-token de cette classe dans notre vocabulaire — cf. la liste ok_quads imprimée) : (1) calculer la perte pour ce quadruple et chaque modèle avec parallelogram_loss, (2) comparer au verdict genre, (3) dire ce qu’un seul quadruple permet — et ne permet pas — de conclure.
Indice : réutiliser acts_w[role] ; pour aller plus loin, construire d’autres quadruples capitale-pays mono-token et étendre la classe avant de comparer les moyennes.
def parallelogram_class_summary(role, quad_list):# TODO etudiant : renvoyer (moyenne, ecart-type) des parallelogram losses# Etape 1 : boucler sur quad_list avec parallelogram_loss(acts_w[role], q)# Etape 2 : moyenne et ecart-type (np.mean / np.std) result =None# TODO etudiantreturn resultCAPS = [q for q in ok_quads if q[0] in ("paris", "rome")]print("Exercice a completer - CAPS =", CAPS)
Exercice a completer - CAPS = [('paris', 'france', 'berlin', 'germany')]
8. Leçon méthodo : les trois jambes de preuve
Ce notebook a délibérément croisé trois façons de répondre à « cette feature porte-t-elle le raisonnement distillé ? » :
Feature-token (fenêtre d’activation max) : suggère une interprétation — nos fenêtres montrent des énoncés mathématiques structurés (\boxed{}, jeux de partages, trigonométrie). Mais une fenêtre est une anecdote choisie : elle ne prouve rien.
Feature-raisonnement (enrichissement sur marqueurs) : test quantitatif — qui ici rectifie la lecture naïve : un seul marqueur enrichi sur quatre (Therefore 1,68), le plus iconique (« Wait ») déplété à 0,54. Un signal partiel n’est pas une lecture sémantique établie.
Causale (ablation pendant la génération) : la seule qui établisse un rôle — et qui ici réfute la transposition du seuil papier à un crosscoder mini (chirurgical 11 features inoffensif, large 1665 features destructeur).
La conclusion honnête de la version mini : le crosscoder 1.5B/307k tokens reproduit la statistique du papier (pic NRN à 0,5, queues fines) mais pas encore sa lecture sémantique (features self-reflection) ni son intervention causale. Les trois jambes s’accordent sur la même frontière : entre 307k et 200M tokens, ce n’est pas la même science.
Limites assumées
307 200 tokens vs 200 M (facteur ~650) ; K=4096 vs 32768 ; une seule couche (mi-profondeur) ; une seule paire (1.5B) contre 1.5B/7B/14B dans le papier.
Corpus 100 % OpenThoughts — le papier mêlait aussi RedPajama (texte général) : sans cette seconde source, la pression à spécialiser les features « raisonnement » est différente.
Détection des marqueurs par token exact capitalisé (Wait/Therefore/Alternatively/But) : couvre les formes majeures des traces R1, pas toutes les variantes.
Génération gloutonne (do_sample=False) pour la reproductibilité ; le papier échantillonne — les longueurs absolues ne se comparent pas directement.
Parallelogram : 4/6 quadruples mono-token seulement, verdict genre non reproducteur du papier à 1.5B (base 1,0694 légèrement sous distillé 1,0832) sur UN quadruple — illustratif, l’exercice 3 commence la mesure par classe.
Déterminisme strict (use_deterministic_algorithms, cuBLAS workspace fixe, TF32 off) : chaque ré-exécution redonne les mêmes chiffres — les lectures de ce notebook sont ancrées sur ces sorties-là.
Références
Baek, J. & Tegmark, M. (2025). Towards Understanding Distilled Reasoning Models: A Representational Approach. arXiv:2503.03730 — Eq 3-7 (§3), Table 1 & Fig 1 (§4), ablation/steering (§5), parallelogram (Fig 4).
Précédent série : ICT-41-SAE-GeometrieFeatures-Python, SAE mono-modèle (issue #16747, PR #16859 en cours d’intégration) ; cadre général README de la série.