Étape 0 de l’épic #8236. La série compare la forme et la dynamique des activations SAE à travers les échelles de modèle (ICT-21 a établi les trajectoires 9B/W64K, 2B/W32K et 1.7B/W32K sur une même batterie de prompts). Mais une comparaison de forme entre deux dictionnaires n’a de sens que si l’on sait ce que chacun reconstruit effectivement du flux résiduel à sa profondeur appariée : comparer la dynamique de codes dont l’un explique 30 % de la variance et l’autre 60 % comparerait des grandeurs différentes sans le dire.
Ce notebook établit cette vérité-terrain pour les deux échelles modélisables localement sur cartes 8 Go :
échelle
modèle
couche (frac 0.5)
SAE officiel
d_model
d_sae
k
locale A
Qwen3-1.7B-Base (génération Qwen3)
14/28
SAE-Res-…-W32K-L0_50
2048
32 768
50
locale B
Qwen3.5-2B-Base (génération Qwen3.5)
12/24
SAE-Res-…-W32K-L0_50
2048
32 768
50
La profondeur relative 0.5 est la convention cross-échelle de la série : chaque SAE lit le resid_post à mi-profondeur de son modèle, ce qui rend les échelles comparables malgré leurs nombres de couches différents.
Statut épistémique — Sans verdict à ce jour : aucune ligne de la matrice de dissociations ne concerne ce notebook ; son statut épistémique sera porté par la matrice le cas échéant.
Garde-fous d’honnêteté (à lire avant les résultats)
Aucune métrique n’est recalculée ici. Toutes proviennent de ict/sae_calibration.py — module numpy-only couvert par 9 tests unitaires sur cas synthétiques à vérité connue par construction (FVU = 0 pour une reconstruction parfaite, FVU = 1 pour la prédiction de la moyenne, etc.). Le notebook lit les rapports JSON produits à l’extraction.
Les traces sont des artefacts commités, produits par scripts/extract_sae_fidelity.py (le GPU est confiné au script, ict/ et ce notebook restent numpy-only). La régénération est déterministe : deux exécutions complètes ont produit des métriques byte-identiques.
Convention encode/décode = démo officielle Qwen-Scope : acts = topk(relu(h @ W_enc.T + b_enc), k) puis reconstruction acts @ W_dec — le b_dec du checkpoint n’est pas soustrait à l’encodage (la démo l’applique au décode). La reconstruction mesurée est celle que le pipeline produit, pas un idéal inatteint.
La garde de cohérence release est passée : L0 mesuré = 50.0 sur les deux échelles, conforme au k=50 des releases L0_50 (assert_l0_release_consistent, tolérance 5 %). Une confusion de release (L0_50 vs L0_100) aurait fait échouer la capture.
W_dec est stocké [d_model, d_sae] dans les checkpoints W32K (vérifié firsthand sur les deux dépôts) : la reconstruction prend les colonnes. Le layout est normalisé au chargement — voir l’issue #12940 pour le bug latent symétrique dans le path clamp d’ICT-21.
Architecture : le GPU confiné, le banc numpy-only
La règle d’architecture de la série sépare trois étages :
Extraction GPU (scripts/extract_sae_fidelity.py) : charge le modèle bf16, capture le resid_post à --layer-frac 0.5 par hook forward sur la même batterie PROMPT_SETS que les traces ICT-21 (5 jeux × 4 prompts : code Python, prose française, dialogue, mathématiques, narration anglaise), encode top-k avec le SAE officiel, produit la reconstruction sparse-exacte et délègue toutes les métriques au module testé. Sortie .npz sans pickle.
Mesure (ict/sae_calibration.py) : MSE par élément, FVU corpus, L0 mesuré, features mortes, rapport agrégé — numpy-only, testé unitairement.
Ce notebook : consomme les .npz, croise, interprète. Aucun torch n’y apparaît.
# Racine canonique de la serie : remonte les parents depuis le dossier du# notebook jusqu'au package ict/, puis en derive les dossiers de donnees.# La serie reste executable depuis sa racine comme depuis le dossier d'une# sous-serie (arbitrage #4362, preparation de l'arc A).import sysfrom pathlib import PathICT_ROOT = Path.cwd()whilenot (ICT_ROOT /"ict"/"__init__.py").exists() and ICT_ROOT != ICT_ROOT.parent: ICT_ROOT = ICT_ROOT.parentassert (ICT_ROOT /"ict"/"__init__.py").exists(), (f"package ict/ introuvable en remontant depuis {Path.cwd().name}")ifstr(ICT_ROOT) notin sys.path: sys.path.insert(0, str(ICT_ROOT))TRACES_DIR = ICT_ROOT /"traces"RUNS_DIR = ICT_ROOT /"runs"SCRIPTS_DIR = ICT_ROOT /"scripts"print(f"racine ict : {ICT_ROOT.name}")
racine ict : ICT-Series
import jsonfrom pathlib import Pathimport numpy as npTRACES = {"Qwen3-1.7B-Base": TRACES_DIR /"calib_fidelity_qwen3-1-7b-base_layer14of28.npz","Qwen3.5-2B-Base": TRACES_DIR /"calib_fidelity_qwen3-5-2b-base_layer12of24.npz",}assertall(p.exists() for p in TRACES.values()), ("traces absentes : regenerer via scripts/extract_sae_fidelity.py (GPU)")calib = {}for label, p in TRACES.items(): d = np.load(p, allow_pickle=False) report = json.loads(str(d["report"])) calib[label] = {"report": report,"counts_total": d["counts_total"],"meta": json.loads(str(d["meta"])),"l0_vals": {s: d[f"l0_vals_{s}"] for s in report["per_set"]}, }print(f"{label:20s}{report['n_tokens']:5d} tokens FVU {report['fvu']:.4f} L0 {report['l0_measured']}")print(f"{len(calib)} echelles chargees")
Le FVU corpus (||H - R||² / ||H - mean(H)||²) est l’étalon de la littérature SAE : 0 = reconstruction parfaite, 1 = aussi mauvais que prédire la moyenne du corpus. C’est la métrique normalisée qui rend les échelles comparables — les MSE brutes vivent dans des échelles de normes différentes et ne se comparent pas.
rows = []for label, c in calib.items(): r = c["report"] rows.append({"echelle": label,"couche": f"{c['meta']['layer']}/{c['meta']['n_layers']}","tokens": r["n_tokens"],"L0": r["l0_measured"],"MSE": r["reconstruction_mse"],"FVU": r["fvu"],"features_vives": r["d_sae"] if"d_sae"in r else c["meta"]["d_sae"] - r["n_dead_features"],"mortes_%": 100* r["dead_fraction"], })hdr =f"{'echelle':20s}{'couch':>6s}{'tokens':>7s}{'L0':>5s}{'MSE':>10s}{'FVU':>7s}{'mortes%':>8s}"print(hdr)print("-"*len(hdr))for row in rows:print(f"{row['echelle']:20s}{row['couche']:>6s}{row['tokens']:>7d}{row['L0']:>5.1f} "f"{row['MSE']:>10.4f}{row['FVU']:>7.4f}{row['mortes_%']:>8.2f}")# variance expliquee = 1 - FVU : la part du residual que le dictionnaire couvrefor row in rows:print(f"{row['echelle']:20s} variance expliquee par le SAE : {100* (1- row['FVU']):.1f} %")
echelle               couch  tokens    L0        MSE     FVU  mortes%
---------------------------------------------------------------------
Qwen3-1.7B-Base       14/28    2759  50.0   522.0051  0.6855    97.32
Qwen3.5-2B-Base       12/24    2699  50.0     0.0051  0.2849    97.47
Qwen3-1.7B-Base      variance expliquee par le SAE : 31.4 %
Qwen3.5-2B-Base      variance expliquee par le SAE : 71.5 %
Lecture honnête des resultats
Trois enseignements, et leurs limites :
La couverture du code sparse à L0 = 50 s’inverse avec l’échelle. Variance expliquée : 31,4 % (1.7B) contre 71,5 % (2B) à mi-profondeur — soit 68,6 % de variance hors dictionnaire pour la 1.7B, mais 28,5 % seulement pour la 2B. La lecture « représentations volontairement partielles » reste exacte pour la 1.7B (c’est le prix d’un code à 50 features actives sur 32 768, pas un défaut de capture) ; sur la 2B le SAE capture au contraire la majeure partie du signal, et ses trajectoires discrètes d’ICT-21 approchent une lecture quasi complète du résiduel. Toute comparaison cross-échelle de forme doit le dire : les deux codes ne couvrent pas la même fraction du signal (40 points d’écart) — attribuer à la taille ce qui est un artefact de couverture est l’erreur que cette asymétrie rend possible.
L’écart 2B > 1.7B mélange deux facteurs. Le 2B (génération Qwen3.5) reconstruit mieux que le 1.7B (génération Qwen3) à largeur de dictionnaire identique — mais générations et tailles diffèrent simultanément. Cette paire ne décroise pas génération et taille ; elle mesure l’effet combiné. Le décroisement exigerait une paire même-génération (hors reach local, cf. exercice 3).
La largeur effective du dictionnaire est ~3 % de sa largeur nominale. Sur ~2 700 tokens, 97 % des 32 768 features ne s’activent jamais (loi d’usage zipfienne des features). Ce n’est pas un défaut du SAE : c’est la conséquence d’un corpus de calibration court. La comparaison cross-échelle de forme utilise de toute façon des sous-ensembles sélectionnés (ICT-21, panel K≈64) — mais le budget d’activation disponible (L0 = 50 exact sur chaque token) est lui saturé, garde passée.
Ce que cette étape n’établit pas : la fidélité au-delà de la mi-profondeur (--layer-frac 0.75, exercice 3), ni sur le couple de référence 9B/W64K (cartes 8 Go insuffisantes localement — relais coordinateur).
Distribution des activations : la loi d’usage
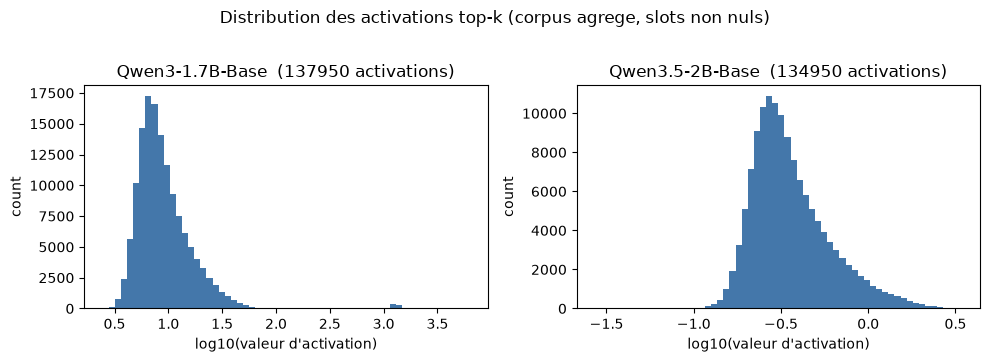
Les valeurs top-k stockées (l0_vals_<set>, float16) donnent la distribution des amplitudes d’activation. Une distribution concentrée près de zéro avec quelques features dominantes = le profil zipfien attendu ; un profil plat signalerait un encodage dégénéré.
import matplotlib.pyplot as pltfig, axes = plt.subplots(1, 2, figsize=(10, 3.5), sharey=False)for ax, (label, c) inzip(axes, calib.items()): all_vals = np.concatenate([v.astype(np.float32) for v in c["l0_vals"].values()]).ravel() all_vals = all_vals[all_vals >0] # les slots relu-annihilés ne sont pas des activations ax.hist(np.log10(all_vals), bins=60, color="#4477aa", edgecolor="none") ax.set_title(f"{label} ({all_vals.size} activations)") ax.set_xlabel("log10(valeur d'activation)") ax.set_ylabel("count")print(f"{label:20s} mediane {np.median(all_vals):8.3f} p99 {np.percentile(all_vals, 99):8.3f} max {all_vals.max():8.3f}")fig.suptitle("Distribution des activations top-k (corpus agrege, slots non nuls)", y=1.02)fig.tight_layout()plt.show()
Qwen3-1.7B-Base      mediane    8.031  p99   52.078  max 6232.000
Qwen3.5-2B-Base      mediane    0.323  p99    1.648  max    3.432
Exercice 1 — la mortalité dépend-elle du seuil ?
dead_features(counts, n_tokens, activation_threshold) compte comme morte toute feature active sur moins de threshold du corpus. Le rapport principal utilise 1 %. On demande : le classement des deux échelles (au sens de la largeur effective) survit-il à un seuil plus exigeant ? Complétez la boucle — les deux premières lignes du tableau sont offertes.
# Exercice 1 : sensibilite du compte de features mortes au seuil# TODO etudiant : pour chaque seuil de SEUILS, calculer le nombre de features mortes# de CHAQUE echelle via ict.sae_calibration.dead_features (import en haut si besoin),# puis remplir la ligne du tableau. Reponse attendue : a 5 %, quelles echelles gardent# plus de 500 features vivantes ?from ict.sae_calibration import dead_featuresSEUILS = [0.005, 0.01, 0.02, 0.05]print(f"{'seuil':>6s} "+" ".join(f"{label:>22s}"for label in calib))for seuil in SEUILS: cols = []for label, c in calib.items(): n_tokens = c["report"]["n_tokens"] mortes = dead_features(c["counts_total"], n_tokens=n_tokens, activation_threshold=seuil) vivantes = c["counts_total"].size - mortes.size cols.append(f"{vivantes:>10d} vivantes")# Indice : la garde dead_features attend un vecteur [d_sae] et n_tokens > 0print(f"{seuil:>6.1%} "+" ".join(f"{col:>22s}"for col in cols))# Etape 3 : noter a partir de quel seuil l'ecart entre echelles devient < 100 features.ecart_5pct =None# TODO etudiant : difference de features vivantes a 5 % entre les deux echellesprint(f"Ecart a 5 % : {ecart_5pct} (a completer)")
Exercice 2 — quel registre est le mieux reconstruit, et pourquoi ?
Le rapport par jeu (per_set) révèle si le dictionnaire traite uniformément les registres (code, prose, dialogue, math, narration) ou s’il spécialise. Calculez l’étendue FVU par échelle, identifiez le meilleur et le pire registre, puis interprétez.
# Exercice 2 : etendue FVU inter-registres par echellefor label, c in calib.items(): per_set = c["report"]["per_set"] tries =sorted(per_set.items(), key=lambda kv: kv[1]["fvu"]) meilleur, pire = tries[0], tries[-1] etendue = pire[1]["fvu"] - meilleur[1]["fvu"]print(f"{label:20s} meilleur={meilleur[0]:14s} FVU {meilleur[1]['fvu']:.4f} | "f"pire={pire[0]:14s} FVU {pire[1]['fvu']:.4f} | etendue {etendue:.4f}")# TODO etudiant : l'etendue est-elle grande devant l'ecart INTER-echelles (exercice precedent) ?# Si oui, le registre confond plus que la taille du modele -> toute comparaison croisee# doit se faire a batterie constante (ce que fait PROMPT_SETS). Repondre en une phrase :interpretation =None# TODO etudiant : votre phrase iciprint("Interpretation :", interpretation)
L’axe profondeur : que gagne-t-on en remontant vers l’entrée ?
La fidélité n’est pas nécessairement uniforme le long du réseau : les couches profondes accumulent des directions de plus grande norme, mais leur dictionnaire est aussi entraîné sur cette distribution — le sens de l’effet n’est pas trivial à prédire a priori. La batterie de la série se capture au même frac 0.5 d’une échelle à l’autre ; pour éclairer l’axe profondeur, on recapture les deux modèles au quart de profondeur (frac 0.25) et on compare — mêmes prompts PROMPT_SETS, même largeur W32K, même L0 = 50, seule la profondeur change. Extraction GPU (règle F), une fois, traces committées :
# L'axe profondeur : quart (frac 0.25) vs mi-profondeur (frac 0.5)SHALLOW = {"Qwen3-1.7B-Base": TRACES_DIR /"calib_fidelity_qwen3-1-7b-base_layer7of28.npz","Qwen3.5-2B-Base": TRACES_DIR /"calib_fidelity_qwen3-5-2b-base_layer6of24.npz",}assertall(p.exists() for p in SHALLOW.values()), ("traces frac0.25 absentes : regenerer via scripts/extract_sae_fidelity.py ""--layer-frac 0.25 (GPU requis)")for label, c in calib.items(): quarter = json.loads(str(np.load(SHALLOW[label], allow_pickle=False)["report"])) mid = c["report"]print(f"{label:20s} frac0.25 FVU {quarter['fvu']:.4f} "f"frac0.5 FVU {mid['fvu']:.4f} delta {quarter['fvu'] - mid['fvu']:+.4f}")
À quart de profondeur, la reconstruction est moins fidèle qu’à mi-profondeur sur la 1.7B — mais l’inverse est vrai sur la 2B :
échelle
FVU frac 0.25
FVU frac 0.5
Δ (frac 0.25 − frac 0.5)
Qwen3-1.7B-Base
0,7704
0,6855
+0,085
Qwen3.5-2B-Base
0,2209
0,2849
−0,064
Remonter de la mi-profondeur vers l’entrée coûte 8,5 points de FVU au 1.7B mais gagne 6,4 points au 2B : le résidu peu profond est moins bien couvert par le dictionnaire de la 1.7B à L0 = 50, alors que celui de la 2B y est mieux couvert. L’intuition « couche profonde = norme plus grande = plus coûteuse à encoder » n’est donc pas ce qu’on mesure — sa direction même change avec l’échelle. Sur la 1.7B seule, deux lectures restent indiscernables à ce stade : soit son dictionnaire profond est mieux entraîné (corpus de calibration plus représentatif du résidu profond), soit son résidu profond est structurellement plus facile à encoder en k = 50.
L’effet profondeur (8,5 pts sur 1.7B, 6,4 pts sur 2B) n’est plus du même ordre que l’écart inter-échelles à mi-profondeur (40,1 pts) — il pèse désormais cinq fois moins, sans être négligeable. C’est précisément pourquoi la batterie de la série fixe une même profondeur relative d’une échelle à l’autre — comparer deux échelles à des profondeurs absolues différentes mélangerait effet de taille, effet de profondeur, et leur interaction, dont le 2B montre qu’elle existe.
Ce que le quart de profondeur ne change pas : le L0 mesuré reste 50.0 exact (la garde de cohérence passe), et la reconstruction reste sparse-exacte (recon = vals @ W_dec[ids] + b_dec, convention b_dec de #13265). Seule la profondeur varie — l’effet mesuré est un effet de profondeur, pas un artefact de capture.
Exercice 3 — une profondeur encore plus grande (GPU requis)
Le quart de profondeur raconte la face « entrée » du réseau. On explore maintenant la face opposée : recapture à --layer-frac 0.75 (au-delà de la mi-profondeur, vers les dernières couches), et comparer les FVU aux deux points déjà mesurés (frac 0.25 et frac 0.5). La tendance se poursuit-elle, ou atteint-on un plancher de reconstruction ?
La cellule suivante reste exécutable sans GPU : elle détecte l’absence des traces et s’arrête proprement.
# Exercice 3 : comparaison des trois profondeurs (traces 0.75 a generer sur GPU)DEEP = {"Qwen3-1.7B-Base": TRACES_DIR /"calib_fidelity_qwen3-1-7b-base_layer21of28.npz","Qwen3.5-2B-Base": TRACES_DIR /"calib_fidelity_qwen3-5-2b-base_layer18of24.npz",}disponibles = {k: v for k, v in DEEP.items() if v.exists()}ifnot disponibles:print("Exercice a completer : traces frac 0.75 absentes.")print("Generer via la commande de la cellule precedente (GPU requis), puis re-executer.")else:for label, p in disponibles.items(): r = json.loads(str(np.load(p, allow_pickle=False)["report"])) quarter = json.loads(str(np.load(SHALLOW[label], allow_pickle=False)["report"])) mid = calib[label]["report"]["fvu"]print(f"{label:20s} frac0.25 {quarter['fvu']:.4f} frac0.5 {mid:.4f} "f"frac0.75 {r['fvu']:.4f}")
Exercice a completer : traces frac 0.75 absentes.
Generer via la commande de la cellule precedente (GPU requis), puis re-executer.
J-lens par taille : la sonde prédit-elle les logits finaux ?
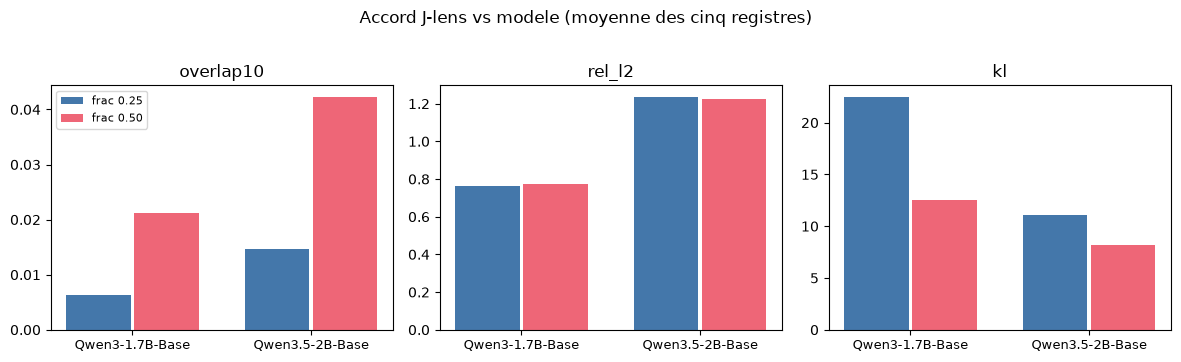
La fidélité SAE ci-dessus mesure la reconstruction du flux résiduel. Une J-lens pose une autre question : à partir d’une couche intermédiaire, avec quelle fidélité sa Jacobienne locale prédit-elle les logits finaux du modèle ? Nous comparons les deux tailles aux mêmes profondeurs relatives (0,25 et 0,5) et sur les mêmes cinq registres de PROMPT_SETS.
Les J-lens sont ajustées sur 458 prompts WikiText puis conservées hors Git dans C:/dev/jlens_fits. Seules les traces compactes produites par scripts/extract_jlens_fidelity.py sont commitées. Pour rester dans le domaine du fit, l’évaluation est tronquée à 128 tokens et exclut les 16 premières positions (attention sinks) ainsi que la dernière position sans cible suivante. Elle contient trois métriques complémentaires : overlap@10 (plus haut est meilleur), erreur L2 relative et KL(modèle || lens) en nats (plus bas est meilleur).
# Accord J-lens vs modele par taille et profondeur relativeMETRIQUES_JLENS = ("overlap10", "rel_l2", "kl")JLENS_TRACES = [ TRACES_DIR /"calib_jlens_qwen3-1-7b.npz", TRACES_DIR /"calib_jlens_qwen3-5-2b.npz",]assertall(path.exists() for path in JLENS_TRACES), ("les deux traces J-lens canoniques sont requises")jlens_calib = {}for path in JLENS_TRACES:with np.load(path, allow_pickle=False) as trace: label ="".join(chr(int(code)) for code in trace["meta_model"]).split("/")[-1] layers =sorted(int(layer) for layer in trace["meta_layers"]) vectors = {}for key in trace.files:if"__"notin key:continue set_name, layer = key.rsplit("__", 1) vector = trace[key].astype(np.float64)assert vector.shape == (len(METRIQUES_JLENS),), (f"{path.name}/{key} : schema inattendu {vector.shape}" ) vectors[(set_name, int(layer))] = vector jlens_calib[label] = {"vectors": vectors,"layers": layers,"n_fit": int(trace["meta_n_fit"][0]),"n_eval": trace["meta_n_eval"].astype(int).tolist(),"file": path.name, }assertset(jlens_calib) ==set(calib), (f"echelles J-lens {sorted(jlens_calib)} != echelles SAE {sorted(calib)}")rows_jlens = []for label, lens_data in jlens_calib.items(): n_layers = calib[label]["meta"]["n_layers"]assert lens_data["n_eval"] == [4] *5, (f"{label} : quatre prompts attendus dans chacun des cinq registres" ) fractions = {layer / n_layers for layer in lens_data["layers"]}assert fractions == {0.25, 0.5}, (f"{label} : profondeurs relatives inattendues {sorted(fractions)}" )for layer in lens_data["layers"]: by_set = [ vector for (set_name, vector_layer), vector in lens_data["vectors"].items()if vector_layer == layer ]assertlen(by_set) ==5, f"{label} couche {layer} : cinq registres attendus" means = np.mean(by_set, axis=0) rows_jlens.append({"echelle": label,"layer": layer,"frac": layer / n_layers,"couche": f"{layer}/{n_layers}",**dict(zip(METRIQUES_JLENS, means)), })print(f"{label:20s} lens fittee sur {lens_data['n_fit']} prompts WikiText; "f"evaluation {lens_data['n_eval']} aux couches {lens_data['layers']}")header =f"{'echelle':20s}{'couch':>6s}{'overlap@10':>11s}{'rel_l2':>8s}{'KL(nats)':>9s}"print(header)print("-"*len(header))for row insorted(rows_jlens, key=lambda item: (item["echelle"], item["frac"])):print(f"{row['echelle']:20s}{row['couche']:>6s}{row['overlap10']:>11.4f} "f"{row['rel_l2']:>8.4f}{row['kl']:>9.4f}")for label, lens_data in jlens_calib.items(): shallow, deep = lens_data["layers"] row_shallow =next(row for row in rows_jlensif row["echelle"] == label and row["layer"] == shallow) row_deep =next(row for row in rows_jlensif row["echelle"] == label and row["layer"] == deep)print(f"{label:20s} delta profondeur overlap@10 : "f"{row_deep['overlap10'] - row_shallow['overlap10']:+.4f}")fig, axes = plt.subplots(1, 3, figsize=(12, 3.5))echelles =list(jlens_calib)x = np.arange(len(echelles))for axis, metric inzip(axes, METRIQUES_JLENS):for frac, color, legend in ((0.25, "#4477aa", "frac 0.25"), (0.50, "#ee6677", "frac 0.50")): values = [next(row[metric] for row in rows_jlensif row["echelle"] == scale andabs(row["frac"] - frac) <1e-9)for scale in echelles] axis.bar(x + (-0.19if frac ==0.25else0.19), values, width=0.36, color=color, label=legend) axis.set_title(metric) axis.set_xticks(x) axis.set_xticklabels(echelles, fontsize=9)axes[0].legend(fontsize=8)fig.suptitle("Accord J-lens vs modele (moyenne des cinq registres)", y=1.02)fig.tight_layout()plt.show()
Les deux échelles montrent le même signal robuste de profondeur : entre le quart et la moitié du réseau, l’overlap@10 moyen passe de 0,0063 à 0,0213 sur la 1.7B et de 0,0146 à 0,0423 sur la 2B. La KL moyenne baisse simultanément de 22,48 à 12,52 nats et de 11,07 à 8,18 nats. L’erreur L2 relative est moins cohérente : elle augmente légèrement en moyenne sur la 1.7B (0,764 à 0,771), baisse légèrement sur la 2B (1,236 à 1,225), et change de direction selon le registre. Il faut donc rapporter les trois métriques plutôt que réduire la fidélité à un score unique.
À profondeur appariée, la 2B obtient un overlap moyen plus élevé et une KL plus basse, mais une L2 relative plus grande que la 1.7B. La taille n’améliore donc pas toutes les notions d’accord à la fois. narrative_en porte le meilleur overlap à mi-profondeur sur les deux modèles (0,0298 et 0,0690). Comme ce registre est le plus proche du WikiText utilisé au fit, ce motif est compatible avec une dépendance de domaine; il ne prouve pas une supériorité générale.
Ces résultats ne rendent pas les métriques SAE et J-lens numériquement comparables : FVU SAE et overlap@10 J-lens ne sont pas sur la même échelle. La première mesure une reconstruction du résidu, la seconde l’accord entre classements de logits finaux. On compare uniquement leurs structures par profondeur, taille et registre.
Enfin, l’issue historique formulait une comparaison accuracy/AUC entre lens de contrôle et lens entraînée. Les scripts livrés mesurent ici une fidélité lens-versus-modèle (overlap@10, L2 relative, KL) sans condition contrôle. Cette section répond donc au sous-grain de calibration multi-taille, pas à l’expérience causale contrôle-versus-entraînée qui reste distincte.
Exercice 4 — les deux sondes classent-elles les registres pareil ?
Le tableau agrège les cinq registres. Construisez, pour chaque échelle à mi-profondeur, le classement par overlap@10 J-lens décroissant et le classement par FVU SAE croissant. Comptez ensuite les registres qui occupent le même rang. Une concordance faible montrerait que reconstruire le résidu et prédire les logits capturent des propriétés différentes.
# Exercice 4 : classement par registre, J-lens vs SAEpositions_communes = {}for label, lens_data in jlens_calib.items(): mid_layer = lens_data["layers"][-1]# Etape 1 : trier les cinq registres par overlap@10 decroissant.# Indice : lens_data["vectors"][(set_name, mid_layer)][0] est l'overlap@10. classement_jlens =None# TODO etudiant : liste des cinq noms de registre# Etape 2 : trier calib[label]["report"]["per_set"] par FVU croissant. classement_sae =None# TODO etudiant : liste des cinq noms de registre# Etape 3 : compter les positions identiques entre les deux classements. positions_communes[label] =None# TODO etudiant : entier entre 0 et 5print(f"{label:20s} J-lens : {classement_jlens}")print(f"{label:20s} SAE : {classement_sae}")print("Positions communes :", positions_communes)
Le registre CPU ci-dessous étend le regard des deux échelles détaillées dans ce notebook à la collection Qwen-Scope complète : sept backbones, répartis entre Qwen3 et Qwen3.5, avec deux variantes SAE par backbone (L0_50 et L0_100). La couche cible est dérivée partout de la même profondeur relative 0.5 ; les traces sont appariées par leur métadonnée model, jamais par leur nom de fichier.
Cette vue mesure uniquement les artefacts déjà committés. Une ligne GPU-gated signifie qu’aucune capture à mi-profondeur n’est disponible dans le dépôt : elle ne constitue ni une exécution locale ni une reproduction simulée.
from ict.sae_scales import coverage_report, format_coveragecouverture = coverage_report(TRACES_DIR, layer_frac=0.5)print(format_coverage(couverture))
modèle                         famille  couche  statut
----------------------------------------------------------
Qwen3-1.7B-Base                Qwen3      14/28  collectée
  profondeur supplémentaire : couche 7 (calib_fidelity_qwen3-1-7b-base_layer7of28.npz)
Qwen3-8B-Base                  Qwen3      18/36  collectée
Qwen3-30B-A3B-Base             Qwen3      24/48  GPU-gated
Qwen3.5-2B-Base                Qwen3.5    12/24  collectée
  profondeur supplémentaire : couche 6 (calib_fidelity_qwen3-5-2b-base_layer6of24.npz)
Qwen3.5-9B-Base                Qwen3.5    16/32  collectée
Qwen3.5-27B                    Qwen3.5    32/64  GPU-gated
Qwen3.5-35B-A3B-Base           Qwen3.5    20/40  GPU-gated
----------------------------------------------------------
Couverture committée : 4/7 backbones
Qwen3 : 2/3
Qwen3.5 : 2/4
Les absences GPU-gated ne sont ni exécutées ni simulées dans ce notebook CPU.
Conclusion
À profondeur appariée (frac 0.5) et largeur de dictionnaire identique (W32K, L0 = 50), les SAE officiels Qwen-Scope reconstruisent 31,4 % (1.7B) et 71,5 % (2B) de la variance du flux résiduel sur la batterie partagée de la série. Trois conséquences pour la suite de #8236 :
les comparaisons de forme d’ICT-21 portent sur un tiers du signal résiduel côté 1.7B, sur sept dixièmes côté 2B — elles restent valides comme comparaisons de codes, mais l’avertissement « ne pas étendre au résidu complet » ne lie plus que la 1.7B ;
l’écart inter-échelles (40,1 points de FVU) domine
l’axe profondeur est d’un ordre inférieur à l’axe échelle — 8,5 points de FVU sur 1.7B et 6,4 points sur 2B entre quart (frac 0.25) et mi-profondeur (frac 0.5), contre 40,1 points inter-échelles, soit environ cinq fois moins — mais sa direction s’inverse avec l’échelle : la 1.7B s’améliore en profondeur (sa couche d’entrée est la moins bien couverte à L0 = 50), la 2B se dégrade (sa mi-profondeur est moins bien couverte que sa couche au quart) — un gradient cross-échelle se lit donc comme couverture × profondeur, jamais profondeur seule ; l’étendue inter-registres (1,2 point sur 1.7B, 6,6 points sur 2B) : le facteur taille/génération n’est pas confondu avec le registre, et la batterie constante PROMPT_SETS garantit qu’il en reste ainsi ;
le L0 mesuré colle exactement à la release (50.0) : les captures sont dans la convention officielle, la garde de cohérence est passée, et la largeur effective (~3 % des features actives sur ce corpus) borne ce qu’un panel type ICT-21 peut sélectionner.
Prochaine étape de l’épic : reporter la capture sur le couple de référence 9B/W64K (relais carte > 8 Go), puis croiser fidelité × dynamique pour répondre à la question de fond : la dynamique S4 est-elle robuste à la part de variance laissée hors dictionnaire ?
Références
Épic #8236 — calibration cross-échelle des SAE (Phase 0 : ce notebook).
Notebook frère : ICT-21-SAETrajectoires-Python.ipynb — trajectoires d’états discrets 9B/2B/1.7B sur la même batterie.