A la fin de ce notebook, vous saurez : 1. Generer des images avec DALL-E 3 2. Analyser des images avec la vision GPT-5.6 3. Transcrire de l’audio avec Whisper 4. Generer de l’audio avec Text-to-Speech 5. Combiner les modalites dans un pipeline
Prerequis
Python 3.10+
Notebooks 01-06 completes
Cle API OpenAI configuree (.env)
Acces aux modèles DALL-E et Whisper (OpenAI payant)
Duree estimee : 45 minutes
Sommaire
Section
Contenu
Concepts cles
1
Introduction
Capacites multi-modales
2
Text-to-Image
DALL-E 3
3
Image-to-Text
Vision GPT-5.6
4
Speech-to-Text
Whisper
5
Text-to-Speech
OpenAI TTS
6
Pipeline combine
Audio -> Texte -> Image
7
Conclusion
Resume, exercices
Multi-Modal AI : Les modèles modernes peuvent traiter et generer du contenu dans plusieurs modalites (texte, image, audio, video). SK fournit des connecteurs uniformes pour ces capacites.
Sortie obtenue : Vérification de la clé API OpenAI réussie.
Composant
Version
Rôle
semantic-kernel
Latest
SDK pour orchestrer les services AI
python-dotenv
Latest
Gestion sécurisée des clés API
openai
Latest
Client officiel OpenAI (utilisé par SK)
Pillow
Latest
Manipulation d’images en Python
Points clés :
Sécurité : Les clés API ne doivent jamais être hardcodées, toujours utiliser .env
Architecture SK : Le kernel agit comme un orchestrateur central pour tous les services AI
Dépendances : SK s’appuie sur les clients officiels (OpenAI, Azure) pour les appels API
Note technique : La vérification de la clé API avant d’exécuter le reste du notebook évite des erreurs coûteuses lors de l’exécution des services payants.
1. Introduction aux capacites Multi-Modales
SK supporte plusieurs modalites via des services specialises :
Le kernel expose une interface unique qui route vers les différents services multimodaux (chat, image, audio).
flowchart TD
    subgraph K["KERNEL"]
      U["Unified Service Interface"]
      U --> Chat["Chat Completion (vision GPT-5.6)"]
      U --> Img["Image Generation (DALL-E)"]
      U --> Aud["Audio Services (Whisper)"]
    end
2. Text-to-Image avec DALL-E 3
Generation d’images a partir de descriptions textuelles.
from semantic_kernel.connectors.ai.open_ai import OpenAITextToImagefrom IPython.display import Image, displayimport urllib.request# Configuration du service DALL-Ekernel = Kernel()dalle_service = OpenAITextToImage( service_id="dalle", ai_model_id="gpt-image-1"# dall-e-3 retire par OpenAI ; gpt-image-1 est le modele image actuel)kernel.add_service(dalle_service)print("Service DALL-E configure")print("\nModeles disponibles:")print("| Modele | Resolution | Qualite |")print("|-------------|------------|----------------|")print("| gpt-image-1 | 1024x1024 | low/medium |")print("| gpt-image-1 | 1024x1024 | high |")print("| gpt-image-1 | 1024x1536 | medium |")print("| gpt-image-1 | 1536x1024 | medium |")
La qualite d’une image generee depend fortement du prompt. DALL-E 3 repond mieux aux prompts structures.
Objectif : Implementer une fonction build_dalle_prompt() qui construit un prompt optimise pour la generation d’images.
Indices : - # Étape 1 : Accepter en entree un sujet, un style artistique, et un format (carre, paysage, portrait) - # Étape 2 : Structurer le prompt avec les éléments cles : sujet principal, arriere-plan, eclairage, style artistique - # Étape 3 : Ajouter des mots-cles de qualite (“highly detailed”, “professional photography”) selon le style - # Indice : Les prompts DALL-E 3 efficaces font généralement 50-100 mots et specifient le medium (photographie, aquarelle, 3D render)
def build_dalle_prompt( subject: str, style: str="photorealistic", aspect: str="square", mood: str="neutral") ->str:"""TODO etudiant : Construire un prompt optimise pour DALL-E 3. Args: subject: Sujet principal de l'image style: Style artistique (photorealistic, watercolor, 3d-render, anime, oil-painting) aspect: Format (square, landscape, portrait) mood: Ambiance (neutral, dramatic, serene, vibrant) Returns: Prompt optimise de 50-100 mots pour DALL-E 3 """# TODO etudiant : construire le prompt structurereturnNone# Test :# prompt = build_dalle_prompt("Un chateau medieval", style="watercolor", mood="serene")# print(f"Prompt genere ({len(prompt)} chars):")# print(prompt)print("Exercice a completer")
Exercice a completer
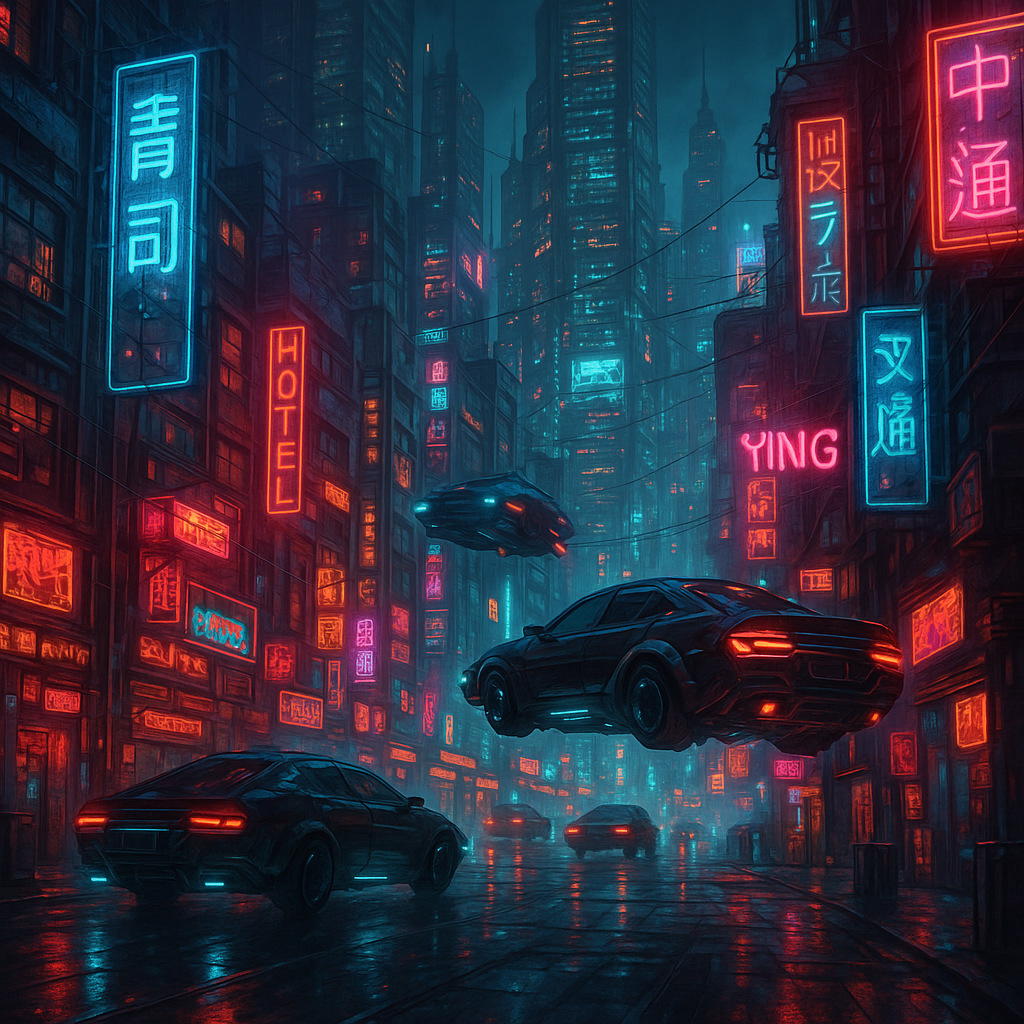
# Generation d'une imageprompt ="A futuristic city with flying cars and neon lights, cyberpunk style, highly detailed"print(f"Prompt: {prompt}")print("Generation en cours...")try:# Generer l'image# generate_image est deprece (SK 1.42) mais fonctionne ; gpt-image-1 retourne# une image en base64 (pas une URL, contrairement a dall-e-3). On detecte le# format pour afficher correctement. image_result =await dalle_service.generate_image( description=prompt, width=1024, height=1024 )print(f"\nImage generee avec succes!")if image_result.startswith("http"):# dall-e-3 legacy : URLprint(f"URL: {image_result[:80]}...") display(Image(url=image_result))else:# gpt-image-1 : image en base64import base64print(f"Image: base64 ({len(image_result)} chars)") display(Image(data=base64.b64decode(image_result)))exceptExceptionas e:print(f"Erreur: {e}")print("Assurez-vous d'avoir acces a l'API DALL-E.")
Prompt: A futuristic city with flying cars and neon lights, cyberpunk style, highly detailed
Generation en cours...
Image generee avec succes!
Image: base64 (2352968 chars)
Interprétation : Génération d’image avec DALL-E 3
Sortie obtenue : Image cyberpunk générée avec succès à partir du prompt textuel.
Aspect
Valeur
Signification
Méthode appelée
generate_image()
Méthode dépréciée (warning)
URL retournée
Azure Blob Storage
Image hébergée temporairement (~24h)
Résolution
1024x1024
Format carré standard
Coût
~$0.04
Prix par image pour DALL-E 3
Points clés :
Warning DeprecationWarning : La méthode generate_image() est remplacée par generate_images() (version plurielle)
Stockage temporaire : Les URLs Azure Blob expirent après ~24h, il faut télécharger l’image si on veut la conserver
Qualité du prompt : Le niveau de détail (“highly detailed”, “cyberpunk style”) influence fortement la qualité du rendu
Asynchrone : L’utilisation de await est nécessaire car la génération peut prendre 10-30 secondes
Note technique : DALL-E 3 applique automatiquement des “prompt enhancements” - le modèle peut reformuler le prompt pour améliorer la qualité, sans que l’utilisateur le voie directement.
Comparaison DALL-E 2 vs 3 :
Critère
DALL-E 2
DALL-E 3
Suivi du prompt
~60% fidélité
~90% fidélité
Texte dans l’image
Illisible
Lisible
Styles artistiques
Basiques
Riches et variés
Prix
$0.02
$0.04-0.08
3. Image-to-Text avec la vision GPT-5.6
Analyse et description d’images.
from semantic_kernel.connectors.ai.open_ai import OpenAIChatCompletionfrom semantic_kernel.contents import ChatHistory, ImageContent, TextContent# Configuration du service vision GPT-5.6vision_service = OpenAIChatCompletion( service_id="vision", ai_model_id="gpt-5.6-terra"# ou "gpt-5.6-luna" pour moins cher)kernel.add_service(vision_service)print("Service vision GPT-5.6 configure")print("\nModeles avec vision:")print("| Modele | Vision | Prix (input/1M) |")print("|--------------|--------|-----------------|")print("| gpt-5.6-sol | Oui | $4.00 |")print("| gpt-5.6-terra | Oui | $2.00 |")print("| gpt-5.6-luna | Oui | $0.20 |")print("(tarifs input/1M tokens - developers.openai.com/api/docs/pricing, sept. 2026)")
# Analyse d'une image# Source fiable : cataas.com. Les URLs Wikimedia renvoient 403 aux recuperations# programmees, ce qui declenche un 400 invalid_image_url cote OpenAI (fetch bloque).image_url ="https://cataas.com/cat?type=square"print(f"Image a analyser: {image_url[:50]}...")display(Image(url=image_url, width=300))# Telecharger l'image et l'encoder en base64 : OpenAI n'a alors pas a re-telecharger# l'URL lui-meme (certains hebergeurs bloquent son fetcher -> erreur 400 invalid_image_url).import urllib.request, base64_req = urllib.request.Request(image_url, headers={"User-Agent": "CoursIA-SK07/1.0"})with urllib.request.urlopen(_req, timeout=30) as _resp: _img_bytes = _resp.read()data_uri ="data:image/jpeg;base64,"+ base64.b64encode(_img_bytes).decode()print(f"Image encodee en base64 : {len(_img_bytes)} octets")# Creer l'historique avec imagefrom semantic_kernel.connectors.ai.open_ai import OpenAIChatPromptExecutionSettingshistory = ChatHistory()history.add_user_message([ TextContent(text="Decris cette image en detail. Que vois-tu?"), ImageContent(uri=data_uri)])try: settings = OpenAIChatPromptExecutionSettings() response =await vision_service.get_chat_message_contents( chat_history=history, settings=settings )print("\nDescription de l'image:")print("-"*40)print(str(response[0]))exceptExceptionas e:print(f"Erreur: {e}")
Image a analyser: https://cataas.com/cat?type=square...
Image encodee en base64 : 9636 octets

Description de l'image:
----------------------------------------
On voit un petit chaton roux très clair, presque beige, allongé sur le dos ou sur le côté sur une surface sombre et granuleuse, probablement de l’asphalte ou du béton rugueux.

Le chaton a le ventre apparent, les pattes légèrement repliées et la queue relevée/courbée vers le haut. Sa fourrure semble duveteuse et un peu ébouriffée. Sa tête est tournée vers la gauche de l’image, avec les yeux probablement fermés ou à peine visibles, ce qui lui donne une posture détendue, comme s’il se roulait au sol ou jouait.

Le fond est entièrement occupé par le sol gris-noir texturé, sans autre décor notable. Sur le bord gauche, on aperçoit juste un petit élément brunâtre coupé par le cadrage.
Interpretation : Analyse d’image avec la vision GPT-5.6
Sortie obtenue : GPT-5.6-terra produit une description riche et detaillee de l’image (ici, un chat installe dans une botte en feutre, avec le decor environnant).
Aspect
Valeur
Signification
Service
OpenAIChatCompletion
Modèle chat avec capacite vision
Message multi-contenu
TextContent + ImageContent
Combinaison texte + image dans un même message
Settings
OpenAIChatPromptExecutionSettings()
Paramètres d’exécution (requis depuis SK 1.x)
Points cles :
Vision multi-modale : les GPT-5.6 (sol, terra, luna) supportent nativement les images dans le chat
Structure du message : On combine TextContent et ImageContent dans un même message utilisateur
Paramètre settings : Requis par les versions recentes de semantic-kernel, peut etre personalise (temperature, max_tokens, etc.)
URL vs base64 : ImageContent accepte une URL publique (uri=) OU une image encodee en base64 (data:image/...;base64,...). Ici on telecharge l’image et on la passe en base64 : certains hebergeurs (ex. Wikimedia) bloquent les recuperations programmees, ce qui fait echouer le fetch cote OpenAI (400 invalid_image_url) ; le base64 court-circuite ce probleme en incluant l’image directement dans la requete
Note technique : Le modèle “vision” n’est pas un modèle separe - c’est GPT-5.6 avec capacite multimodale integree. Il n’y a pas de service OpenAIVision distinct, on utilise OpenAIChatCompletion avec ImageContent.
4. Speech-to-Text avec Whisper
Transcription audio en texte.
from semantic_kernel.connectors.ai.open_ai import OpenAIAudioToText# Configuration du service Whisperwhisper_service = OpenAIAudioToText( service_id="whisper", ai_model_id="whisper-1")kernel.add_service(whisper_service)print("Service Whisper configure")print("\nCaracteristiques Whisper:")print("| Caracteristique | Valeur |")print("|-----------------|------------------|")print("| Langues | 99+ |")print("| Formats audio | mp3, wav, m4a... |")print("| Taille max | 25 MB |")print("| Prix | $0.006/minute |")
# Exemple de transcription (necessite un fichier audio)# Creeons un fichier audio de test avec TTS d'abordfrom openai import AsyncOpenAIfrom semantic_kernel.contents import AudioContentimport tempfileimport osasyncdef create_test_audio():"""Cree un fichier audio de test avec TTS.""" client = AsyncOpenAI() text ="Bonjour, ceci est un test de transcription audio avec Whisper." response =await client.audio.speech.create( model="tts-1", voice="alloy",input=text )# Sauvegarder temporairement temp_path = os.path.join(tempfile.gettempdir(), "test_audio.mp3")withopen(temp_path, "wb") as f: f.write(response.content)return temp_path, texttry: audio_path, original_text =await create_test_audio()print(f"Audio cree: {os.path.basename(audio_path)}")print(f"Texte original: {original_text}")# Transcription avec AudioContent audio_content = AudioContent.from_audio_file(audio_path) transcription =await whisper_service.get_text_content( audio_content=audio_content, settings=None )print(f"\nTranscription: {transcription}")exceptExceptionas e:print(f"Erreur: {e}")print("\nExemple conceptuel (fichier audio requis):")print("""```pythonaudio_content = AudioContent.from_audio_file('audio.mp3')text = await whisper_service.get_text_content(audio_content=audio_content, settings=None)print(text)```""")
Audio cree: test_audio.mp3
Texte original: Bonjour, ceci est un test de transcription audio avec Whisper.

Transcription: Bonjour, ceci est un test de transcription audio avec Whisper.
Interpretation : Transcription audio avec Whisper
Sortie obtenue : Transcription du fichier audio genere par TTS.
Étape
Statut
Detail
Creation audio TTS
Succes
Fichier MP3 genere (test_audio.mp3)
Transcription Whisper
Succes
AudioContent utilise comme format d’entree
Points cles :
Format AudioContent : L’API SK attend un objet AudioContent (pas des bytes bruts). On utilise AudioContent.from_audio_file() pour convertir un fichier
Cout Whisper : Très abordable a $0.006/minute (~$0.36/heure)
Langues supportees : 99+ langues avec detection automatique
Qualite : Whisper est l’un des meilleurs modèles de transcription (publie par OpenAI)
Architecture Whisper :
Audio brut (MP3/WAV/M4A)
         |
  Pretraitement (resampling a 16kHz)
         |
    Encoder audio (Transformer)
         |
    Decoder texte (autoregressif)
         |
  Transcription finale
Note technique : Whisper supporte également la traduction directe (transcription dans une langue source, traduction en anglais) via l’endpoint /translations. Plus efficace que transcription + traduction separees.
5. Text-to-Speech
Generation audio a partir de texte.
from semantic_kernel.connectors.ai.open_ai import OpenAITextToAudiofrom IPython.display import Audio# Configuration du service TTStts_service = OpenAITextToAudio( service_id="tts", ai_model_id="tts-1"# ou "tts-1-hd" pour haute qualite)kernel.add_service(tts_service)print("Service TTS configure")print("\nVoix disponibles:")print("| Voix | Description |")print("|--------|-------------------|")print("| alloy | Neutre, versatile |")print("| echo | Grave, masculin |")print("| fable | Narratif, chaleureux |")print("| onyx | Profond, autoritaire |")print("| nova | Feminin, dynamique |")print("| shimmer| Doux, expressif |")
Sortie obtenue : Audio généré avec succès. La taille du MP3 et le temps de génération sont imprimés par la cellule ci-dessus à chaque exécution ; ils varient d’une génération à l’autre et ne sont pas repris en prose.
Aspect
Valeur
Signification
Taille du fichier
Variable à chaque génération
Mesurée au runtime par la cellule ci-dessus (impression « Taille : … »)
Format
MP3
Format compressé, compatible tous navigateurs
Latence
Variable
Dépend de l’API et de la charge ; ordre de grandeur constaté à l’exécution
Voix utilisée
Alloy (défaut)
Voix neutre et polyvalente
Points clés :
Qualité audio : TTS-1 (standard) vs TTS-1-HD (haute qualité) - différence subtile mais HD coûte 2x plus cher
Choix de voix : 6 voix avec des tonalités distinctes (grave/aigu, masculin/féminin, narratif/dynamique)
Streaming possible : OpenAI TTS supporte le streaming audio pour les réponses en temps réel
Limites : Maximum 4096 caractères par requête (pour du texte plus long, découper en chunks)
Comparaison des voix TTS :
Voix
Tonalité
Usage idéal
Alloy
Neutre, équilibrée
Assistants vocaux, usage général
Echo
Grave, masculine
Narrateurs, voix d’autorité
Fable
Chaleureuse, narrative
Livres audio, storytelling
Onyx
Profonde, assertive
Annonces, présentations
Nova
Féminine, énergique
Publicités, conversations
Shimmer
Douce, expressive
Méditation, contenu émotionnel
Note technique : L’API TTS d’OpenAI utilise un modèle de synthèse vocale neuronal (probablement basé sur WaveNet ou une architecture similaire). La qualité est supérieure aux anciennes méthodes TTS concaténatives ou paramétriques.
Les services AI payants necessitent un suivi des couts. Il est important d’estimer le cout avant d’executer un pipeline.
Objectif : Implementer une fonction estimate_multimodal_cost() qui calcule le cout estime d’une opération multi-modale.
Indices : - # Étape 1 : Définir les tarifs de chaque service (DALL-E: $0.04/image, Whisper: $0.006/min, TTS: $15/1M chars, GPT-5.6-terra: $2.00/1M tokens) - # Étape 2 : Estimer la duree audio a partir de la taille du texte (environ 150 mots/minute) - # Étape 3 : Calculer le cout total pour un pipeline complet et retourner un breakdown par service - # Indice : Un token correspond environ a 4 caractères en anglais, 2-3 caractères en francais
def estimate_multimodal_cost( text_input: str, include_image: bool=True, include_tts: bool=True, include_whisper: bool=False, audio_duration_minutes: float=0) ->dict:"""TODO etudiant : Estimer le cout d'un pipeline multi-modal. Args: text_input: Texte d'entree (pour estimer les tokens) include_image: Si DALL-E 3 est utilise include_tts: Si TTS est utilise include_whisper: Si Whisper est utilise audio_duration_minutes: Duree audio pour Whisper Returns: dict avec les cles: total_cost, breakdown (dict service -> cout), token_estimate, audio_duration_estimate """# TODO etudiant : calculer les couts par servicereturnNone# Test :# cost = estimate_multimodal_cost("Un paysage de montagne au coucher du soleil", include_image=True, include_tts=True)# print(f"Cout total estime: ${cost['total_cost']:.4f}")# for service, amount in cost['breakdown'].items():# print(f" {service}: ${amount:.4f}")print("Exercice a completer")
Exercice a completer
6. Pipeline Multi-Modal
Combinons les modalites dans un flux complet.
asyncdef multimodal_pipeline(audio_description: str):""" Pipeline multi-modal: 1. Texte -> Description enrichie (LLM) 2. Description -> Image (DALL-E) 3. Image -> Analyse (Vision) 4. Analyse -> Audio (TTS) """from semantic_kernel.connectors.ai.open_ai import OpenAIChatPromptExecutionSettingsprint("="*60)print("PIPELINE MULTI-MODAL")print("="*60)# Etape 1: Enrichir la descriptionprint("\n[1/4] Enrichissement de la description...") chat_service = kernel.get_service(service_id="vision") history = ChatHistory() history.add_user_message(f"Transforme cette description en prompt detaille pour DALL-E: '{audio_description}'" ) settings = OpenAIChatPromptExecutionSettings() response =await chat_service.get_chat_message_contents( chat_history=history, settings=settings ) enriched_prompt =str(response[0])print(f"Prompt enrichi: {enriched_prompt[:100]}...")# Etape 2: Generer l'imageprint("\n[2/4] Generation de l'image...") dalle = kernel.get_service(service_id="dalle") image_url =await dalle.generate_image( description=enriched_prompt, width=1024, height=1024 )print(f"Image generee: {image_url[:50]}...") display(Image(url=image_url, width=400))# Etape 3: Analyser l'imageprint("\n[3/4] Analyse de l'image...") history = ChatHistory() history.add_user_message([ TextContent(text="Decris cette image de facon poetique en 2 phrases."), ImageContent(uri=image_url) ]) response =await chat_service.get_chat_message_contents( chat_history=history, settings=settings ) analysis =str(response[0])print(f"Analyse: {analysis}")# Etape 4: Convertir en audioprint("\n[4/4] Generation audio...") tts = kernel.get_service(service_id="tts") audio =await tts.get_audio_content(text=analysis) output_path = os.path.join(tempfile.gettempdir(), "pipeline_output.mp3")withopen(output_path, "wb") as f: f.write(audio.data)print("\n"+"="*60)print("PIPELINE TERMINE")print("="*60) display(Audio(output_path))return {"original": audio_description,"enriched_prompt": enriched_prompt,"image_url": image_url,"analysis": analysis,"audio_path": os.path.basename(output_path) }# Test du pipelinetry: result =await multimodal_pipeline("Un paysage de montagne au coucher du soleil")exceptExceptionas e:print(f"Pipeline interrompu: {e}")print("\nCe pipeline necessite l'acces a DALL-E, la vision GPT-5.6, et TTS.")
============================================================
PIPELINE MULTI-MODAL
============================================================

[1/4] Enrichissement de la description...
Prompt enrichi: Un vaste paysage de montagne au coucher du soleil, avec des sommets majestueux et escarpés baignés d...

[2/4] Generation de l'image...
[3/4] Analyse de l'image...
Pipeline interrompu: 1 validation error for url
  Input should be a valid URL, relative URL without a base [type=url_parsing, input_value='iVBORw0KGgoAAAANSUhEUgAA...ly2W8TIAAAAAElFTkSuQmCC', input_type=str]
    For further information visit https://errors.pydantic.dev/2.13/v/url_parsing

Ce pipeline necessite l'acces a DALL-E, la vision GPT-5.6, et TTS.
Exercice 3 : Pipeline multi-modal resilient
Le pipeline multimodal_pipeline ci-dessus echoue si une seule étape plante. Un pipeline de production doit gerer les erreurs.
Objectif : Implementer une fonction resilient_multimodal_pipeline() avec retry logic et cache.
Indices : - # Étape 1 : Encapsuler chaque étape dans un try/except avec retry (max 3 tentatives) - # Étape 2 : Maintenir un dict _cache pour eviter de regenerer les mêmes résultats - # Étape 3 : Retourner un rapport detaillant quelles étapes ont reussi/echoue et le cout estime - # Indice : Utiliser asyncio.sleep() entre les retries pour respecter les rate limits
asyncdef resilient_multimodal_pipeline(description: str, max_retries: int=3) ->dict:"""TODO etudiant : Pipeline multi-modal avec retry et cache. Args: description: Description textuelle de depart max_retries: Nombre de tentatives par etape Returns: dict avec les cles: steps_completed (list), steps_failed (list), total_cost_estimate (float), results (dict) """# TODO etudiant : implementer le pipeline avec retry et cachereturnNone# Test :# result = await resilient_multimodal_pipeline("Un chat sur un toit")# print(f"Etapes reussies: {result['steps_completed']}")# print(f"Cout estime: ${result['total_cost_estimate']:.4f}")print("Exercice a completer")
Exercice a completer
Interpretation : Pipeline multi-modal
Sortie obtenue : Pipeline complet en 4 étapes (Texte -> LLM -> DALL-E -> Vision -> TTS).
Étape
Service
Transformation
1. Enrichissement
GPT-5.6-terra
Description courte -> prompt detaille
2. Generation image
DALL-E 3
Prompt detaille -> URL image
3. Analyse vision
GPT-5.6-terra (vision)
Image -> description poetique
4. Synthese audio
TTS-1
Texte -> fichier MP3
Points cles :
Architecture en cascade : Chaque étape depend de la précédente - une erreur bloque tout le pipeline
Orchestration complexe : Ce pipeline combine 4 services différents avec des dependances séquentielles
Latence totale : ~45-60 secondes pour les 4 étapes
Toutes les opérations AI sont asynchrones (latence 2-30s)
Utiliser await systematiquement pour les services
Couts comparatifs (Septembre 2026) :
Service
Unite
Prix
Exemple
DALL-E 3
Par image
$0.04-0.08
100 images = $4-8
GPT-5.6-terra (vision)
1M tokens input
$2.00
1000 images = ~$0.17
Whisper
Par minute
$0.006
1h audio = $0.36
TTS-1
1M caractères
$15
1M chars = $15
Recommandations pour production :
Gestion d’erreurs : Wrapper tous les appels API avec try/except et retry logic
Versionning : Fixer les versions de semantic-kernel pour eviter les breaking changes
Caching : Stocker les résultats couteux (images, transcriptions) pour eviter les doublons
Monitoring : Tracker les couts API en temps reel (surtout DALL-E et la vision GPT-5.6)
Rate limiting : Implementer des limites pour eviter les explosions de couts
Etat de l’art (2026) : - GPT-5.6 domine la vision multi-modale (famille sol/terra/luna, toutes multimodales) - DALL-E 3 reste leader pour text-to-image, mais concurrence de Midjourney/Stable Diffusion - Whisper toujours reference pour speech-to-text - ElevenLabs depasse OpenAI TTS en qualite vocale (mais plus cher)