EPIC #10355 — FallacyDetection, Phase 1 / synthèse. Ce notebook conclut la Phase 1 en rendant mesurable la couverture de la série : chaque notebook de la série vient de la même veine (axée « matériau de Phase 2 »), mais aucun ne disait ce qu’il couvre. La matrice N×M ci-dessous le dit, en lisant les notebooks eux-mêmes (aucune déclaration à la main).
Axes mesurés : colonnes M = sophismes (types exposés par les inventaires du notebook), formalismes (cellules qui posent la paire formel/informel), domaines (sources/datasets externes nommés), et la colonne preuve (exécution réelle, erreurs, figures).
La lecture des notebooks est déléguée à l’organe canonique scripts/notebook_tools/fallacy_coverage_matrix.py : cette cellule et les suivantes consomment le module, elles ne réimplémentent pas sa mesure (leçon #13921 — organe importable + consommateur externe).
import sysfrom pathlib import Path# Robuste au cwd : papermill peut lancer depuis repo-root ou le dossier notebook._CANDIDATES = [ Path("scripts/notebook_tools/fallacy_coverage_matrix.py"), Path("../scripts/notebook_tools/fallacy_coverage_matrix.py"), Path("../../scripts/notebook_tools/fallacy_coverage_matrix.py"), Path("../../../scripts/notebook_tools/fallacy_coverage_matrix.py"),]_ORGAN =next((c for c in _CANDIDATES if c.is_file()), None)assert _ORGAN isnotNone, "Organe introuvable depuis cwd="+str(Path.cwd())sys.path.insert(0, str(_ORGAN.parent))import fallacy_coverage_matrix as fcmprint("Organe charge :", _ORGAN.name)
Organe charge : fallacy_coverage_matrix.py
1. La matrice N×M — lecture directe des notebooks
La matrice est calculée, pas écrite à la main : chaque ligne reflète ce que le notebook définit réellement (inventaires LOGIC_13/mafalda_labels/…, paires formel/informel, sources externes nommées, cellules exécutées).
from pathlib import Path# Le dossier de la série, robuste au cwd._series = [ Path("MyIA.AI.Notebooks/GenAI/FallacyDetection"), Path("../GenAI/FallacyDetection"), Path("../../GenAI/FallacyDetection"),]SERIES_DIR =next((c for c in _series if c.is_dir()), None)assert SERIES_DIR isnotNone, "Serie introuvable depuis cwd="+str(Path.cwd())rows = fcm.build_matrix(SERIES_DIR)print(fcm.markdown_table(rows))
Lecture de la matrice. La matrice est creuse par construction — et c’est une information, pas un défaut : chaque ligne (axe) n’est portée que par les notebooks qui en parlent réellement, et build_matrix lit les notebooks eux-mêmes au lieu de consulter un registre tenu à la main. La différence est décisive pour la maintenance : un registre manuel dérive dès qu’un notebook est renommé ou scindé, alors que la lecture directe est ré-exécutée à chaque fois et ne peut pas mentir sur l’état du dossier.
Ce que la matrice mesure : la présence d’un axe dans un notebook — pas la qualité de son traitement, ni le nombre d’exemples. Une croix dense sur « sophismes » peut recouvrir trois mentions rapides comme une section entière ; c’est la limite assumée de l’instrument, et la raison pour laquelle les exercices demandent de faire parler les lignes plutôt que de additionner les cases. La matrice est un outil de scope (où sont les trous), pas d’évaluation (les trous sont-ils profonds).
Pour la Phase 2, la lecture opérationnelle est la colonne, pas la ligne : pour un notebook donné, la liste de ses axes couverts dit quel matériau il apporte au dataset — un notebook qui porte « domaines » + « exemples FR » vaut plus pour la diversité qu’un notebook qui empile les mêmes axes que ses voisins.
2. La lecture visuelle — heatmap
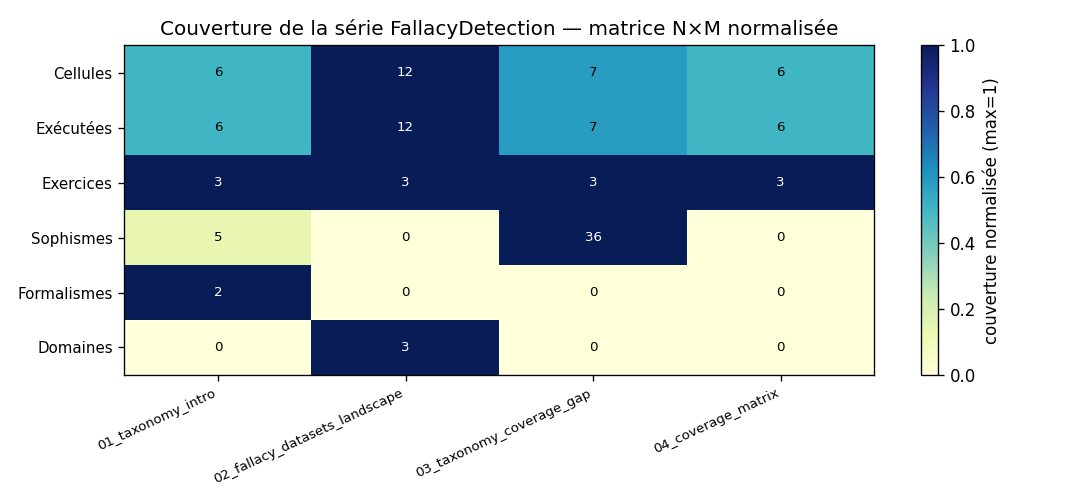
Une heatmap rend la forme de la couverture lisible en un coup d’œil, là où le tableau rend les valeurs exactes. Les axes sont normalisés par ligne-maximum (pour chaque axe, le notebook qui couvre le plus vaut 1) — cela montre qui porte quoi, pas des valeurs absolues.
import matplotlibmatplotlib.use("Agg")import matplotlib.pyplot as pltimport numpy as nplabels, grid = fcm.heatmap_payload(rows)mat = np.array(grid)# Normalisation par ligne (axe -> 1 pour le maximum).norm = np.zeros_like(mat, dtype=float)for i inrange(mat.shape[0]): mx = mat[i].max() norm[i] = mat[i] / mx if mx >0else0fig, ax = plt.subplots(figsize=(9, 4.2))im = ax.imshow(norm, cmap="YlGnBu", aspect="auto")ax.set_xticks(range(len(rows)))ax.set_xticklabels([r["notebook"].replace(".ipynb", "") for r in rows], rotation=25, ha="right", fontsize=8)ax.set_yticks(range(len(labels)))ax.set_yticklabels(labels, fontsize=9)for i inrange(len(labels)):for j inrange(len(rows)): ax.text(j, i, f"{mat[i][j]:g}", ha="center", va="center", fontsize=8, color="black"if norm[i][j] <0.75else"white")fig.colorbar(im, ax=ax, label="couverture normalisée (max=1)")ax.set_title("Couverture de la série FallacyDetection — matrice N×M normalisée")plt.tight_layout()plt.savefig("assets/fallacy_coverage_matrix.png", dpi=120)print("Heatmap sauvee dans assets/fallacy_coverage_matrix.png")
Heatmap sauvee dans assets/fallacy_coverage_matrix.png
Lecture de la heatmap. La normalisation est par ligne : chaque axe est ramené à son propre maximum, sinon l’axe le plus peuplé écraserait visuellement les autres et la carte ne montrerait qu’un effet de taille. Le prix de cette comparabilité : la couleur ne dit plus combien, seulement où l’axe est concentré — les cardinalités restent lisibles dans les annotations numériques des cases et le tableau brut (cellule précédente).
Ce que la forme raconte avant les valeurs : des bandes horizontales claires signalent des axes portés par un seul notebook (fragilité — si ce notebook disparaît, l’axe disparaît avec lui) ; des colonnes uniformément claires signalent des notebooks interchangeables (redondance — la série gagnerait à les spécialiser). Une matrice de couverture saine ressemble à un damier irrégulier : chaque notebook a un profil distinct, aucun axe ne tient sur une seule ligne. C’est exactement la lecture que l’exercice 1 demande de faire sur la ligne « domaines ».
La heatmap normalisée — chaque ligne est un axe, l’intensité dit quel notebook porte la couverture :
Matrice de couverture de la série FallacyDetection
3. Exercices
La matrice révèle des trous de couverture. Les trois exercices ci-dessous instrumentent ces trous — ils se complètent avec les données déjà en mémoire (rows, labels, norm).
Exercice 1 — Lire la ligne « domaines »
Contexte. Exécute (1) lit la matrice : quel notebook couvre le plus de sources externes ? Pourquoi les deux autres en couvrent-elles zéro — est-ce un défaut de contenu ou une différence de métier ?
# Exercice 1 — Ligne (domaines) : lire et interpréter# Etape 1 : indexer la ligne domaines dans la matrice (rows[i][domaines]).# Etape 2 : nommer le notebook qui porte la ligne et justifier l'ecart.# Etape 3 : dire si l'ecart est un defaut de couverture ou un effet de perimetre.resultat_ex1 =None# TODO etudiant
Exercice 2 — Les sophismes sont-ils bien répartis ?
Contexte. La colonne « sophismes » additionne les inventaires de chaque notebook — mais un inventaire n’est pas une couverture : nommer un type dans une liste n’est pas l’étiqueter sur un corpus. Écrire le test de la technique dont le 03 a besoin pour que sa colonne soit honnête.
# Exercice 2 — Sophismes (N' vs N) : un inventaire n'est pas une couverture# Etape 1 : ecrire une fonction couverture_effective(inventaire, corpus_etiquetes)# qui rend le ratio de types effectivement presents dans le corpus.# Etape 2 : la verifier sur l'inventaire LOGIC_13 face a un corpus jouet.# Indice : regarder cote couverture des feuilles dans 03 (academic vs feuilles).def couverture_effective(inventaire, corpus_etiquetes): resultat_ex2 =None# TODO etudiantreturn resultat_ex2
Exercice 3 — Que manque-t-il à la matrice ?
Contexte. La matrice mesure quatre axes (sophismes, formalismes, domaines, preuve). Un axe manque : le niveau de difficulté / le type de tâche (étiqueter, choisir, argumenter). Proposer un cinquième axe et le rendre mesurable à partir des cellules code du notebook — mêmes contraintes que les autres axes (mécanique, reproductible, zéro déclaration à la main).
# Exercice 3 — Proposer un 5e axe mesurable# Etape 1 : definir le nom du nouvel axe et sa regle de mesure.# Etape 2 : implementer une fonction axe_nouveau(notebook_path) -> int# qui compte les cellules code de type tache donnee.# Etape 3 : la verifier sur le notebook 01 (3 exercices attendus).def axe_nouveau(notebook_path): resultat_ex3 =None# TODO etudiantreturn resultat_ex3
4. Conclusion — usage de la matrice Phase 2
La matrice est le chantier de la Phase 2 : elle nomme où la série est déjà forte (inventaires du 03, sources du 02) et où elle est vide (formalismes, domaines dans les 01 et 03). Un Future dataset builder relira cette matrice comme carte de départ — pas comme un verdict.
Le point d’arrêt. La matrice sert aussi à arrêter le travail : quand chaque axe est porté par au moins deux notebooks et que chaque notebook a un profil distinct, ajouter un notebook de plus diminue la diversité marginale — le coût de maintenance dépasse le gain de couverture. La Phase 2 hérite de ce critère : le dataset builder piochera dans les cases pleines, et les cases vides restantes deviennent la liste de travail affichée de l’Epic, pas une dette cachée.