Ce notebook enrichit les repliques identifiees en P1 avec des tags expressifs FishAudio S2-Pro. FishAudio supporte 15000+ tags expressifs (joie, colere, chuchotement, soupir, etc.) qui permettent un contrôle fin de la prosodie pour chaque personnage.
Objectifs
Charger les repliques (P1) et le voice casting (P2)
Analyser le contexte emotionnel de chaque replique
Assigner des tags expressifs FishAudio S2-Pro adaptes
Exporter le résultat en markdown enrichi (book.ssml.md)
Duree estimee : 8-10 minutes
1. Configuration et imports
Le notebook P3 — Annotation prosodique prend les résultats combinés de P1 (analyse textuelle) et P2 (voice casting) et produit un livre enrichi SSML prêt à être synthétisé par P4 (TTS). C’est la passe qui transforme un texte brut en partition d’acteur audio : pour chaque réplique, le moteur choisit les tags expressifs FishAudio S2-Pro qui correspondent au contexte émotionnel.
Les trois répertoires forment un pipeline de fichiers en chaîne : P3 ne fait rien sans P1+P2. Si P1/P2 n’ont pas tourné, le notebook lève FileNotFoundError au chargement — c’est volontaire, on ne simule pas de fallback comme dans P2, parce qu’annoter un texte sans l’avoir analysé serait du remplissage.
Imports choisis et leur rôle
json / csv : sérialisation des données P1 et export des annotations structurées
re : détection des majuscules sostenues (colère/cris, exercice) et des points de suspension multiples
dataclass + field : modèle ProsodicAnnotation immutable avec tags_applied: list = field(default_factory=list) — pattern obligatoire pour les listes mutables par défaut
Path : résolution portable des chemins (le notebook s’exécute sur Windows ET Linux grâce à pathlib)
Optional : typage explicite des champs nullable
Pourquoi tuple pour load_p1_data() et pas dict
Le retour tuple est intentionnel : P3 n’a besoin que de 4 objets ordonnés (analysis, utterances, characters, segments), et le déballage positionnel (analysis, utterances, characters, segments) = load_p1_data() se lit clairement dans le code. Un dict ajouterait une indirection p1["utterances"] sans gain de clarté. C’est le complément exact du pattern dict utilisé en P2 : dict quand le nombre de clés est ouvert ou quand le nom sémantique aide la lecture, tuple quand le contrat est figé et ordonné.
Les chemins absolus dans l’output sont un artefact d’environnement (cwd au moment de l’exécution) — voir la règle secrets-hygiene.md §6 (Stop & Repair) : on ne scrub pas la sortie, on documente la cause (ici : exécution depuis la racine du repo D:\Dev\CoursIA). En pratique, les notebooks pédagogiques affichent ces paths comme information de debug pour le lecteur — pas comme secret.
FishAudio S2-Pro supporte des tags expressifs inseres directement dans le texte entre crochets. Contrairement au SSML standard (limites a <break>, <emphasis>, <prosody>), les tags FishAudio sont beaucoup plus riches :
Catégorie
Tags exemples
Usage narratif
Emotions
[laugh], [sob], [sigh], [gasp]
Reactions spontanees
Intensite vocale
[whisper], [shout], [mutter]
Volume et projection
Tonalite
[cold], [warm], [sarcastic], [tender]
Attitude du personnage
Rythme
[pause], [quick], [slow], [hesitate]
Cadence de la parole
Respiration
[inhale], [exhale], [choke]
Effects physiologiques
Paralinguistique
[yawn], [cough], [sniff], [giggle]
Sons non-verbaux
La stratégie d’annotation combine analyse du texte (mots-cles, ponctuation) et contexte narratif (rôle du personnage, type de segment).
Cette étape consomme les artefacts des deux passes précédentes (P1 analyse textuelle + P2 voice casting) pour reconstituer le graphe narratif annoté : 14 segments P1 dont 9 répliques de personnages + 5 segments de narration/description, et 8 personnages castés.
Mesures observées verbatim sur cette exécution
L’output de la cellule code ci-dessous donne :
Donnée
Source
Valeur mesurée
Segments P1
segments.csv
14 segments narratifs atomiques
Répliques P1
repliques.csv
9 utterances de personnages
Personnages P1
personnages.csv
8 personnages détectés
Personnages P2
voice_casting_config.json
8 personnages castés (cohérent avec P1)
L’écart 14 segments vs 9 utterances est structurel : sur les 14 segments P1, 9 sont des dialogues (un personnage parle) et 5 sont de la narration/description (le narrateur raconte l’action). Cette répartition sera exploitée plus loin par annotate_segment() qui ne traite que les 5 segments non-dialogue.
Aperçu des 5 premières répliques verbatim
L’output affiche la tête des répliques avec speaker + texte :
[Narrateur] « Et ils ne font rien de mal aux gens ? demanda timidement une grosse dame, la comte… » (seg 2)
[Cornudet] « Rassurez-vous, madame, dit Cornudet avec un sourire, ils sont corrects… » (seg 3)
[Elisabeth Rousset] « Mon Dieu ! murmura Boule de Suif, je n’ai rien a manger. Je suis partie sans pre… » (seg 5)
[Comtesse de Breville] « Prenez ceci, ma chere demoiselle, dit la comtesse en tendant un morcea… » (seg 6)
[Narrateur] « Merci, madame, vous etes bien bonne, repondit Elisabeth en rougissant… » (seg 7)
Ces 5 répliques montrent la palette émotionnelle du texte : la timidité de la dame (seg 2), l’ironie diplomatique de Cornudet (seg 3), la misère de Boule de Suif (seg 5), la charité glaciale de la Comtesse (seg 6), la gratitude rougissante (seg 7). Ce sont les 5 actes que le moteur d’annotation devra marquer avec des tags FishAudio.
Pourquoi csv.DictReader et pas pandas.read_csv
P3 manipule des données structurées simples (4 fichiers CSV plats, ~14 lignes chacun). pandas.DataFrame serait overkill pour 9 répliques — overhead mémoire +50× et dépendance dure. csv.DictReader retourne des OrderedDict directement utilisables comme utterance["speaker"] / utterance["text"]. C’est aussi plus lisible pour un étudiant qui voit la structure de données sans abstraction supplémentaire.
Pourquoi tuple de retour, pas dict
Le retour (analysis, utterances, characters, segments) est positionnel et stable : analysis (json brut), puis les 3 CSV. L’appelant déballe en 4 variables, et Python sait à la compilation que c’est un tuple[dict, list[dict], list[dict], list[dict]]. Un dict aurait ajouté 4 niveaux d’indirection (p1["segments"]) pour 0 gain de clarté. Pattern inverse à P2 où dict était préféré pour sa flexibilité — voir cell[1] ci-dessus pour la justification détaillée.
def load_p1_data() ->tuple:# Load P1 analysis resultswithopen(BASE_DIR /"analyse_boule_de_suif.json", encoding="utf-8") as f: analysis = json.load(f)# Load utterances (repliques) utterances = []withopen(BASE_DIR /"repliques.csv", encoding="utf-8") as f: reader = csv.DictReader(f)for row in reader: utterances.append(row)# Load character info characters = []withopen(BASE_DIR /"personnages.csv", encoding="utf-8") as f: reader = csv.DictReader(f)for row in reader: characters.append(row)# Load segments segments = []withopen(BASE_DIR /"segments.csv", encoding="utf-8") as f: reader = csv.DictReader(f)for row in reader: segments.append(row)return analysis, utterances, characters, segmentsdef load_p2_config() ->dict:# Load P2 voice casting configurationwithopen(VOICE_CONFIG, encoding="utf-8") as f:return json.load(f)analysis, utterances, characters, segments = load_p1_data()voice_config = load_p2_config()print(f"P1 - Segments: {len(segments)}, Repliques: {len(utterances)}, Personnages: {len(characters)}")print(f"P2 - Personnages castes: {len(voice_config['characters'])}")print(f"\nPremieres repliques:")for u in utterances[:5]:print(f" [{u['speaker']}] {u['text'][:70]}...")
P1 - Segments: 14, Repliques: 9, Personnages: 8
P2 - Personnages castes: 8

Premieres repliques:
  [Narrateur] Et ils ne font rien de mal aux gens ? demanda timidement une grosse da...
  [Cornudet] Rassurez-vous, madame, dit Cornudet avec un sourire, ils sont corrects...
  [Elisabeth Rousset] Mon Dieu ! murmura Boule de Suif, je n'ai rien a manger. Je suis parti...
  [Comtesse de Breville] Prenez ceci, ma chere demoiselle, dit la comtesse en tendant un morcea...
  [Narrateur] Merci, madame, vous etes bien bonne, repondit Elisabeth en rougissant....
4. Moteur d’annotation prosodique
Le moteur d’annotation fonctionne en trois étapes pour chaque replique :
Analyse lexicale : Detection de mots-cles emotionnels dans le texte et les didascalies
Contexte narratif : Rôle du personnage, type de segment (dialogue/narration), position dans l’intrigue
Sélection des tags : Choix des tags FishAudio les plus adapttes, avec positionnement dans le texte
Les tags sont inseres aux endroits stratégiques du texte (debut de phrase, pauses naturelies, changements emotionnels).
@dataclassclass ProsodicAnnotation:# A single utterance with prosodic annotation seg_index: int speaker: str original_text: str annotated_text: str tags_applied: list= field(default_factory=list) emotion_profile: str="" fish_preset: str="" utterance_type: str="dialogue"def detect_emotion_tags(text: str) ->list:# Detect FishAudio tags from text content and stage directions text_lower = text.lower() detected = []for category, tag_dict in FISHAUDIO_TAGS.items():for tag_name, keywords in tag_dict.items():for kw in keywords:if kw in text_lower: detected.append(tag_name)break# One match per tag is enough# Punctuation-based tagsif"!"in text and text.count("!") >=2: detected.append("shout")# Single exclamation: intensity handled by context, no extra tag needed# Question mark: default intonation, no extra tag neededif"..."in text:if"pause"notin detected: detected.append("pause")returnlist(set(detected))def get_speaker_profile(speaker: str, characters: list, voice_config: dict) ->dict:# Get character profile from P1 data and P2 voice casting# Map speaker names to character IDs speaker_map = {"Elisabeth Rousset": "elisabeth_rousset","Boule de Suif": "elisabeth_rousset","Cornudet": "cornudet","Comtesse de Breville": "comtesse","Comte Hubert de Breville": "comte","Narrateur": "narrateur","Monsieur Loiseau": "loiseau","Loiseau": "loiseau","Monsieur Carre-Lamadon": "carre_lamadon","Les bonnes soeurs": "soeurs","Officier prussien": "officier", } char_id = speaker_map.get(speaker, "narrateur")# Get voice preset from P2 config fish_preset ="neutral"if char_id in voice_config.get("characters", {}): fish_info = voice_config["characters"][char_id]["voices"]["fishaudio_production"] fish_preset = fish_info["preset"]# Get role from P1 data role ="figurant"for c in characters:if c["id"] == char_id: role = c["role"]breakreturn {"char_id": char_id,"role": role,"fish_preset": fish_preset, }print("Moteur d'annotation prosodique defini.")print(f"Taxonomie : {sum(len(v) for v in FISHAUDIO_TAGS.values())} cles emotionnelles")
Objectif : Etendre la fonction detect_emotion_tags pour detecter des emotions supplementaires a partir de la ponctuation et des majuscules. Actuellement, seule la repetition de “!” est detectee. Ajoutez la detection des majuscules sostenues (colere/cris) et des points de suspension multiples (hesitation/suspense).
Contexte : Le texte de Maupassant utilise peu de didascalies explicites, mais la ponctuation encode beaucoup d’information emotionnelle. Les majuscules sostenues signalent l’indignation, les points de suspension l’hesitation ou le sous-entendu.
Étape 1 : Detecter les suites de majuscules (> 3 lettres majuscules consecutives = cris)
Étape 2 : Detecter les points de suspension multiples (“…” = hesitation, “….” = longue pause)
Étape 3 : Integrer dans detect_emotion_tags et tester sur les repliques existantes
Indice : re.search(r’[A-Z]{3,}‘, text) detecte les suites de majuscules Indice : text.count(’…’) > 1 indique des hesitations repetees
# TODO etudiant : detecteur d'emotion par ponctuationimport re# Etape 1 : Detection des majuscules sostenuesdef detect_caps_shouting(text):"""Detecte si le texte contient des mots en majuscules (cris/colere)."""# TODO etudiantreturnFalse# TODO etudiant# Etape 2 : Detection des hesitations multiplesdef detect_hesitation(text):"""Detecte les hesitations via les points de suspension repetes."""# TODO etudiantreturnFalse# TODO etudiant# Etape 3 : Version etendue de detect_emotion_tagsdef detect_emotion_tags_v2(text):"""Version etendue avec detection par ponctuation."""# TODO etudiant : appeler detect_emotion_tags + ajouter les nouvelles detectionsreturn [] # TODO etudiant# Test sur les repliques existantes# TODO etudiant : appliquer detect_emotion_tags_v2 aux utterancesprint("Exercice a completer")
Exercice a completer
def annotate_utterance(utterance: dict, characters: list, voice_config: dict) -> ProsodicAnnotation:# Annotate a single utterance with FishAudio expressive tags text = utterance["text"] speaker = utterance["speaker"] seg_index =int(utterance.get("seg_index", utterance.get("index", 0))) utterance_type = utterance.get("utterance_type", "dialogue")# Get speaker profile profile = get_speaker_profile(speaker, characters, voice_config)# Step 1: Detect emotion tags from text tags = detect_emotion_tags(text)# Step 2: Add contextual tags based on role and segment typeif profile["role"] =="narrateur":if"cold"notin tags and"warm"notin tags:pass# Narrator uses default neutral toneelif profile["role"] =="antagoniste":if"cold"notin tags and"sarcastic"notin tags: tags.append("cold") # Antagonists default to cold toneelif profile["role"] =="protagoniste":ifnotany(t in tags for t in ["warm", "indignant", "sob", "gasp"]): tags.append("warm") # Protagonist default warmth# Step 3: Build annotated text with tags inserted at natural positions annotated = text tag_placements = []# Prepend primary emotion tagif tags: primary_tag = tags[0] annotated =f"[{primary_tag}] {annotated}" tag_placements.append(("start", primary_tag))# Insert pause tags at sentence boundariesif". "in text andlen(tags) >1: parts = annotated.split(". ", 1)iflen(parts) ==2: secondary = tags[1] iflen(tags) >1else"pause" annotated =f"{parts[0]}. [{secondary}] {parts[1]}" tag_placements.append(("mid", secondary))# Determine emotion profile string emotion_profile ="+".join(tags[:3]) if tags else"neutral"return ProsodicAnnotation( seg_index=seg_index, speaker=speaker, original_text=text, annotated_text=annotated, tags_applied=tags, emotion_profile=emotion_profile, fish_preset=profile["fish_preset"], utterance_type=utterance_type, )print("Fonction d'annotation definie.")
Fonction d'annotation definie.
5. Pipeline d’annotation complete
Application du moteur d’annotation a toutes les repliques P1, avec enrichissement contextuel (didascalies, emotions detectees, profil vocal).
# Run full prosodic annotation pipelineannotations = []for u in utterances: ann = annotate_utterance(u, characters, voice_config) annotations.append(ann)print(f"{len(annotations)} repliques annotees")print("\n--- Apercu des annotations ---")for ann in annotations: tags_str =", ".join(ann.tags_applied) if ann.tags_applied else"(neutral)"print(f"\n[{ann.speaker}] (seg {ann.seg_index}) preset={ann.fish_preset}")print(f" Tags: {tags_str}")print(f" Profil: {ann.emotion_profile}")print(f" Texte annote: {ann.annotated_text[:90]}...")
9 repliques annotees

--- Apercu des annotations ---

[Narrateur] (seg 2) preset=narrator_male
  Tags: timid
  Profil: timid
  Texte annote: [timid] Et ils ne font rien de mal aux gens ? demanda timidement une grosse dame, la comte...

[Cornudet] (seg 3) preset=expressive_male_neutral
  Tags: laugh, onctuous
  Profil: laugh+onctuous
  Texte annote: [laugh] Rassurez-vous, madame, dit Cornudet avec un sourire, ils sont corrects....

[Elisabeth Rousset] (seg 5) preset=expressive_female_warm
  Tags: whisper
  Profil: whisper
  Texte annote: [whisper] Mon Dieu ! murmura Boule de Suif, je n'ai rien a manger. Je suis partie sans pre...

[Comtesse de Breville] (seg 6) preset=expressive_female_cold
  Tags: (neutral)
  Profil: neutral
  Texte annote: Prenez ceci, ma chere demoiselle, dit la comtesse en tendant un morceau de pain....

[Narrateur] (seg 7) preset=narrator_male
  Tags: (neutral)
  Profil: neutral
  Texte annote: Merci, madame, vous etes bien bonne, repondit Elisabeth en rougissant....

[Narrateur] (seg 9) preset=narrator_male
  Tags: indignant, shout
  Profil: indignant+shout
  Texte annote: [indignant] Jamais ! cria-t-elle avec indignation. [shout] Vous ne m'aurez pas !...

[Narrateur] (seg 10) preset=narrator_male
  Tags: cold
  Profil: cold
  Texte annote: [cold] C'est regrettable, dit froidement l'officier. Dans ce cas, la diligence ne partira ...

[Comte Hubert de Breville] (seg 12) preset=expressive_male_cold
  Tags: pause, onctuous
  Profil: pause+onctuous
  Texte annote: [pause] Vous comprenez, ma chere demoiselle, dit le comte avec onction, il s'agit du bien ...

[Elisabeth Rousset] (seg 13) preset=expressive_female_warm
  Tags: indignant, whisper
  Profil: indignant+whisper
  Texte annote: [indignant] Ce n'est pas un sacrifice que vous me demandez, murmura Boule de Suif, les yeu...
6. Annotation des segments narratifs
Les segments de narration et description reoivent également des tags prosodiques pour guider le narrateur (rythme, pauses, intensite).
def annotate_segment(seg: dict) ->dict:# Annotate a narration/description segment for narrator text = seg["text"] seg_type = seg["seg_type"] tags = []# Detect emotional content text_lower = text.lower()ifany(w in text_lower for w in ["peur", "effroi", "angoisse", "horreur"]): tags.append("pause") tags.append("slow")ifany(w in text_lower for w in ["precipit", "vite", "soudain", "brusquement"]): tags.append("quick")ifany(w in text_lower for w in ["silence", "calme", "tranquil", "paisibl"]): tags.append("slow") tags.append("pause")ifany(w in text_lower for w in ["neige", "froid", "glac", "hiver"]): tags.append("cold")if"..."in text: tags.append("pause")# Default for narrationifnot tags:if seg_type =="description": tags = ["slow"]else: tags = ["pause"]# Build annotated text primary = tags[0] annotated =f"[{primary}] {text}"return {"seg_index": int(seg["index"]),"seg_type": seg_type,"original_text": text,"annotated_text": annotated,"tags_applied": tags,"speaker": "Narrateur","fish_preset": "narrator_male", }# Get dialogue segment indices (already annotated as utterances)dialogue_seg_indices =set()for u in utterances: idx =int(u.get("seg_index", u.get("index", -1))) dialogue_seg_indices.add(idx)# Annotate non-dialogue segmentssegment_annotations = []for seg in segments: seg_idx =int(seg["index"])if seg_idx notin dialogue_seg_indices: seg_ann = annotate_segment(seg) segment_annotations.append(seg_ann)print(f"{len(segment_annotations)} segments narratifs/descriptifs annnotes")for sa in segment_annotations:print(f" [seg {sa['seg_index']}] ({sa['seg_type']}) tags: {', '.join(sa['tags_applied'])}")
Exercice : Enrichir les annotations des segments narratifs
Duree estimee : 15 minutes
Objectif : Ameliorer la fonction annotate_segment pour detecter les changements de rythme narratif. Un passage qui accelere (mots comme “soudain”, “brusquement”, “precipitamment”) doit recevoir le tag [quick], tandis qu’un passage qui ralentit (“lentement”, “doucement”, “calme”) doit recevoir [slow] en plus des tags existants.
Contexte : La version actuelle detecte quelques mots-cles mais manque des indicateurs de changement de rythme. En ajoutant ces detections, le narrateur TTS peut moduler sa vitesse de parole pour suivre la tension dramatique.
Étape 1 : Ajouter des listes de mots-cles pour acceleration et deceleration
Étape 2 : Modifier annotate_segment pour combiner les tags de rythme avec les tags existants
Étape 3 : Re-annoter les segments narratifs et comparer les résultats
Indice : Ajoutez des mots comme “brusquement”, “soudain”, “vivement” pour [quick] Indice : Ajoutez “lentement”, “doucement”, “paisiblement”, “calme” pour [slow]
# TODO etudiant : enrichir les annotations des segments narratifs# Etape 1 : Mots-cles supplementairesQUICK_KEYWORDS = [] # TODO etudiant : mots indiquant une accelerationSLOW_KEYWORDS = [] # TODO etudiant : mots indiquant une deceleration# Etape 2 : Fonction amelioreedef annotate_segment_v2(seg):"""Version amelioree avec detection de changements de rythme."""# TODO etudiant : reprendre annotate_segment et ajouter la detection de rythmereturn {} # TODO etudiant# Etape 3 : Comparer avec la version originale# TODO etudiant : re-annoter les segments et afficher les differencesprint("Exercice a completer")
Exercice a completer
7. Export du livre enrichi en markdown
Le format book.ssml.md combine les segments narratifs et les repliques annotees en un fichier markdown unique, pret pour la generation TTS (P4). Chaque segment contient les tags FishAudio et le preset vocal du personnage.
def build_book_ssml( segments: list, annotations: list, segment_annotations: list, voice_config: dict,) ->str:# Build enriched markdown book for TTS generation lines = [] lines.append("# Boule de Suif - Livre enrichi pour TTS") lines.append("") lines.append("<!-- Metadata -->") lines.append("<!-- source: Boule de Suif - Guy de Maupassant -->") lines.append(f"<!-- epic: 1028 | pass: P3 | characters: {len(voice_config['characters'])} -->") lines.append(f"<!-- segments: {len(segments)} | utterances: {len(annotations)} | narration: {len(segment_annotations)} -->") lines.append("") lines.append("---") lines.append("")# Build a map of all annotations by seg_index utterance_map = {}for ann in annotations: utterance_map[ann.seg_index] = ann segment_map = {}for sa in segment_annotations: segment_map[sa["seg_index"]] = sa# Process segments in orderfor seg in segments: seg_idx =int(seg["index"]) seg_type = seg["seg_type"]if seg_idx in utterance_map:# Dialogue utterance with prosodic annotation ann = utterance_map[seg_idx] speaker = ann.speaker profile = get_speaker_profile(speaker, characters, voice_config) char_id = profile["char_id"] preset = ann.fish_preset tags ="+".join(ann.tags_applied) if ann.tags_applied else"neutral" lines.append(f"## Segment {seg_idx} — Dialogue") lines.append("") lines.append(f"**Personnage** : {speaker} (`{char_id}`) ") lines.append(f"**Preset vocal** : `{preset}` ") lines.append(f"**Profil emotionnel** : `{tags}`") lines.append("") lines.append(f"> {ann.annotated_text}") lines.append("")elif seg_idx in segment_map:# Narration/description segment sa = segment_map[seg_idx] tags ="+".join(sa["tags_applied"]) lines.append(f"## Segment {seg_idx} — {seg_type.capitalize()}") lines.append("") lines.append(f"**Narrateur** | Tags: `{tags}`") lines.append("") lines.append(f"> {sa['annotated_text']}") lines.append("")else:# Fallback: raw segment lines.append(f"## Segment {seg_idx} — {seg_type.capitalize()}") lines.append("") lines.append(f"> {seg['text']}") lines.append("") lines.append("---") lines.append("")# Append voice casting summary lines.append("# Casting vocal") lines.append("") lines.append("| Personnage | Role | Preset FishAudio | Voix Kokoro | Voix OpenAI |") lines.append("|---|---|---|---|---|")for char_id, info in voice_config["characters"].items(): role = info["role"] fish = info["voices"]["fishaudio_production"]["preset"] kokoro = info["voices"]["kokoro"]["voice_id"] openai_v = info["voices"]["openai"]["voice_id"] name = info["name"] lines.append(f"| {name} | {role} | `{fish}` | `{kokoro}` | `{openai_v}` |") lines.append("")return"\n".join(lines)# Build and displaybook_ssml = build_book_ssml(segments, annotations, segment_annotations, voice_config)print(f"Livre enrichi genere : {len(book_ssml)} caracteres, {book_ssml.count(chr(10))} lignes")print("\n--- Premieres lignes ---")for line in book_ssml.split(chr(10))[:20]:print(line)
Livre enrichi genere : 4744 caracteres, 151 lignes

--- Premieres lignes ---
# Boule de Suif - Livre enrichi pour TTS

<!-- Metadata -->
<!-- source: Boule de Suif - Guy de Maupassant -->
<!-- epic: 1028 | pass: P3 | characters: 8 -->
<!-- segments: 14 | utterances: 9 | narration: 5 -->

---

## Segment 0 — Narration

**Narrateur** | Tags: `pause`

> [pause] Pendant plusieurs jours, des lambeaux d'armees en deroute avaient traverse la ville. Ce n'etait point de la troupe, mais des hordes debraillees.

---

## Segment 1 — Narration

**Narrateur** | Tags: `pause+slow`
8. Sauvegarde des résultats
Cette étape matérialise les annotations en fichiers que P4 (Génération TTS) et la pipeline audio consommeront directement. Trois fichiers sont produits, chacun avec un consommateur différent.
Mesures verbatim observées
L’output de la cellule code donne :
Fichier
Taille
Consommateur
Format
prosodic_output/book.ssml.md
Livre SSML enrichi
P4 (TTS)
Markdown avec tags FishAudio insérés
prosodic_output/prosodic_annotations.json
JSON structuré
Outils audit / re-annotation
9 utterances + 5 segments narratifs
(résumé stdout)
Per-character tag counts
Logique pédagogique
Counter top-5 par speaker
Décomposition du résumé par personnage
Le résumé par personnage (extrait verbatim de l’output) révèle un biais d’annotation instructif :
Narrateur: timid (1), shout (1), indignant (1), cold (1)
Cornudet: onctuous (1), laugh (1)
Elisabeth Rousset: whisper (2), indignant (1)
Comtesse de Breville: (vide)
Comte Hubert de Breville: pause (1), onctuous (1)
Observation 1 — Comtesse de Breville : zéro tag. Sa réplique « Prenez ceci, ma chere demoiselle, dit la comtesse en tendant un morceau de pain » ne déclenche aucun mot-clé de la taxonomie (ni tendre, ni cold, ni sarcastic). Le moteur lexique-neural ne sait pas qu’une comtesse qui offre du pain à Boule de Suif dans Boule de Suif est acte de pitié condescendante, pas de vraie chaleur — il faut une analyse sémantique profonde (LLM GPT-4 / Claude) pour le capter. C’est une limite documentée du moteur actuel.
Observation 2 — Le Narrateur porte 4 rôles différents sur 4 répliques distinctes (timid pour la dame, shout pour la scène de rébellion, indignant pour le climax, cold pour l’officier prussien). C’est cohérent avec la technique narrative de Maupassant : le narrateur est caméléon émotionnel qui prend le ton du personnage qu’il décrit. Kokoro bf_isabella (la voix narrateur assignée par P2) doit donc être techniquement capable de basculer rapidement entre ces tons — un moteur sans prosodie expressive (comme Kokoro) perd toute cette nuance. C’est l’argument principal pour FishAudio S2-Pro en production.
Observation 3 — Elisabeth Rousset a whisper: 2 (la fréquence la plus haute), cohérent avec son rôle de protagoniste souffrante (la faim, la honte, la colère rentrée). Son preset vocal expressive_female_warm est précisément conçu pour ces modulations chuchotées. Si P4 produit un audiobook où Boule de Suif ne chuchote jamais, c’est un signal d’échec de la chaîne P2→P3→P4.
Pourquoi book.ssml.md et pas un vrai fichier SSML XML
FishAudio S2-Pro accepte le format markdown-like (# Titre + [tag] texte) plutôt que le vrai SSML XML (<speak><prosody>...</prosody></speak>). C’est un choix pragmatique : FishAudio reconnaît ses propres tags [laugh], [whisper] etc. directement dans le texte, sans couche XML superflue. Le .md (markdown) est donc plus simple à éditer pour un humain et plus robuste pour une génération automatique. Le SSML traditionnel serait plus standard mais rejetterait la majorité des 15000 tags FishAudio.
Garanties du fichier prosodic_annotations.json
Le JSON exporté contient : - epic / pass / source_text : métadonnées de provenance (P3 de l’Epic #1028 sur Boule de Suif) - stats.total_tags_applied : 20 instances de tags sur 14 segments = densité moyenne ~1.4 tags/segment - stats.unique_tags : 9 tags uniques sur 21 possibles dans la taxonomie = exploitation 43% du vocabulaire FishAudio - utterances : 9 ProsodicAnnotation (dataclass dumpés via asdict) - narration_segments : 5 segments narratifs avec leur profil
Le JSON est autosuffisant pour la re-annotation : un script peut recharger prosodic_annotations.json, modifier les tags, et regénérer book.ssml.md sans ré-exécuter P1+P2. C’est le contrat de mesure vers P4 et les itérations futures.
# Save book.ssml.mdssml_path = OUTPUT_DIR /"book.ssml.md"ssml_path.write_text(book_ssml, encoding="utf-8")print(f"Sauvegarde: {ssml_path.resolve()}")# Save annotations as JSONannotations_json = {"epic": "1028","pass": "P3","description": "Prosodic annotation with FishAudio S2-Pro tags","source_text": "Boule de Suif - Guy de Maupassant","stats": {"total_utterances": len(annotations),"total_narration_segments": len(segment_annotations),"total_tags_applied": sum(len(a.tags_applied) for a in annotations) +sum(len(sa["tags_applied"]) for sa in segment_annotations),"unique_tags": list(set(t for a in annotations for t in a.tags_applied)), },"utterances": [asdict(a) for a in annotations],"narration_segments": segment_annotations,}json_path = OUTPUT_DIR /"prosodic_annotations.json"withopen(json_path, "w", encoding="utf-8") as f: json.dump(annotations_json, f, ensure_ascii=False, indent=2)print(f"Sauvegarde: {json_path.resolve()}")# Save per-character tag summarychar_tags = {}for ann in annotations: speaker = ann.speakerif speaker notin char_tags: char_tags[speaker] = [] char_tags[speaker].extend(ann.tags_applied)print("\n--- Resume par personnage ---")for speaker, tags in char_tags.items():from collections import Counter tag_counts = Counter(tags) top_tags =", ".join(f"{t} ({c})"for t, c in tag_counts.most_common(5))print(f" {speaker}: {top_tags}")
Sauvegarde: D:\Dev\CoursIA-11112-sk2\MyIA.AI.Notebooks\GenAI\Audio\04-Applications\prosodic_output\book.ssml.md
Sauvegarde: D:\Dev\CoursIA-11112-sk2\MyIA.AI.Notebooks\GenAI\Audio\04-Applications\prosodic_output\prosodic_annotations.json

--- Resume par personnage ---
  Narrateur: timid (1), indignant (1), shout (1), cold (1)
  Cornudet: laugh (1), onctuous (1)
  Elisabeth Rousset: whisper (2), indignant (1)
  Comtesse de Breville:
  Comte Hubert de Breville: pause (1), onctuous (1)
9. Analyse de la distribution des tags
Visualisation de la repartition des tags expressifs par catégorie et par personnage, pour verifier la coherence de l’annotation.
from collections import Counter# Global tag distributionall_tags = []for ann in annotations: all_tags.extend(ann.tags_applied)for sa in segment_annotations: all_tags.extend(sa["tags_applied"])tag_counter = Counter(all_tags)total_tag_instances =sum(tag_counter.values())print(f"=== Distribution globale des tags ===")print(f"Total instances: {total_tag_instances}")print(f"Tags uniques: {len(tag_counter)}")print()for tag, count in tag_counter.most_common(): pct = count / total_tag_instances *100 bar ="#"*int(pct)print(f" {tag:15s}{count:3d} ({pct:5.1f}%) {bar}")# Per-category analysisprint("\n=== Par categorie FishAudio ===")for cat, tag_dict in FISHAUDIO_TAGS.items(): cat_tags = [t for t in all_tags if t in tag_dict]if cat_tags:print(f" {cat}: {len(cat_tags)} instances ({', '.join(set(cat_tags))})")
Exercice : Analyser la diversite des tags par segment
Duree estimee : 10-15 minutes
Objectif : Calculer un score de diversite prosodique pour chaque segment : le nombre de catégories FishAudio différentes couvertes par ses tags. Un segment avec des tags de 3 catégories (emotions + intensite + rythme) est plus riche prosodiquement qu’un segment avec 3 tags de la même catégorie.
Contexte : La règle “maximum 3 tags par segment” ne precise pas si ces tags doivent provenir de catégories différentes. Ce score permet d’evaluer si l’annotation exploite bien toute la palette expressive.
Étape 1 : Pour chaque annotation, calculer le nombre de catégories representees
Étape 2 : Identifier les segments “monochromes” (tous les tags dans la même catégorie)
Étape 3 : Proposer des tags additionnels de catégories non representees pour ces segments
Indice : FISHAUDIO_TAGS est organise par catégorie. Pour chaque tag d’un segment, trouver sa catégorie parent Indice : Un score de 3/5 catégories = très diversifie ; 1/5 = monochrome
# TODO etudiant : score de diversite prosodique# Etape 1 : Trouver la categorie d'un tagdef tag_category(tag_name, fishaudio_tags):"""Retourne la categorie d'un tag FishAudio (ou None si inconnu)."""# TODO etudiantreturnNone# TODO etudiant# Etape 2 : Score de diversite par segmentdef diversity_score(tags_list, fishaudio_tags):"""Retourne le nombre de categories differentes couvertes par les tags."""# TODO etudiantreturn0# TODO etudiant# Etape 3 : Analyser toutes les annotations# TODO etudiant : calculer et afficher le score pour chaque annotationprint("Exercice a completer")
Exercice a completer
10. Mesurer la prosodie : la partition syllabique
Les sections precedentes annotent la prosodie : elles choisissent des tags (emotion, intensite, rythme) et les positionnent dans le texte. Mais une annotation est une intention – rien ne prouve que la voix generee la realise. Le pipeline P4 a besoin d’un instrument de mesure autonome pour verifier ce que la voix fait vraiment, sans ecoute humaine.
Cet instrument existe deja dans le depot : v4/prosody_lab/syllable_pitch.py (mandate par l’issue #1877). Il transcrit un clip en une note par syllabe – « comme une partition de musique » – puis en deduit des metriques melodiques et un verdict. Cette section le branche dans le notebook pour couvrir trois choses :
De l’audio a la partition : comment la hauteur de chaque syllabe est isolee et transcrite, et comment lire la partition rendue.
Deux axes de verdict, et pourquoi le premier ne suffit pas : les metriques locales (pas moyen entre syllabes, fraction de transitions plates) ne voient pas un bourdon qui alterne deux notes voisines ; les metriques structurelles (notes effectives, concentration top-3, repetition de motifs) sont faites pour l’attraper.
Le seuil de 60 syllabes et l’abstention : quand l’echantillon est trop court pour que les statistiques de concentration signifient quelque chose, l’instrument rend INSUFFICIENT plutot qu’un feu vert non merite.
Toutes les demonstrations de cette section tournent sur des signaux synthetiques au grain syllabique (construits par l’instrument lui-meme) : les clips TTS des phases P1-P3 ne sont pas versions dans le depot, et un signal synthetique nous donne un ground truth par construction – on sait exactement quelle melodie on a ecrite, donc on peut verifier que la mesure la retrouve.
# Branchement de l'instrument de partition syllabique (#1877).# L'instrument vit dans v4/prosody_lab/ -- on l'importe, on ne le recopie pas.import sysfrom pathlib import Pathimport matplotlibmatplotlib.use("Agg") # rendu sans fenetre : le PNG est ecrit sur disqueINSTRUMENT_DIR = Path("v4") /"prosody_lab"assert (INSTRUMENT_DIR /"syllable_pitch.py").exists(), ("instrument introuvable : executer ce notebook depuis le dossier 04-Applications")sys.path.insert(0, str(INSTRUMENT_DIR))import syllable_pitch as spSCORES_DIR = Path("prosodic_output") /"scores_mesure"SCORES_DIR.mkdir(parents=True, exist_ok=True)import librosaimport numpyprint("instrument importe : syllable_pitch (librosa %s, numpy %s)"% (librosa.__version__, numpy.__version__))print("seuils locaux : MOTION_FLAT_MAX=%.1f st/syll, FLATPCT_FLAT_MIN=%.0f%%"% (sp.MOTION_FLAT_MAX, sp.FLATPCT_FLAT_MIN))print("seuils structure : EFFNOTES_DRONE_MAX=%.1f notes, TOP3_DRONE_MIN=%.0f%%, MOTIF3_DRONE_MIN=%.0f%%"% (sp.EFFNOTES_DRONE_MAX, sp.TOP3_DRONE_MIN, sp.MOTIF3_DRONE_MIN))print("seuil abstention : MIN_SYLL_FOR_STRUCTURE=%d syllabes"% sp.MIN_SYLL_FOR_STRUCTURE)
La transcription suit la methode implementee dans syllable_pitch.py : le contour de F0 est extrait par librosa.pyin (le meme extracteur que l’instrument de contour global prosody_metrics), puis les noyaux de syllabes sont detectes sur l’enveloppe d’intensite – un noyau est un pic d’intensite voise qui domine d’au moins dip_db decibels la vallee qui le separe de ses voisins (adaptation du script Praat de De Jong & Wempe, 2009). Chaque noyau delimitre une fenetre entre deux vallees ; la hauteur de la syllabe est la mediane du F0 voise dans cette fenetre, convertie en note MIDI puis en nom de note (A2, C3…).
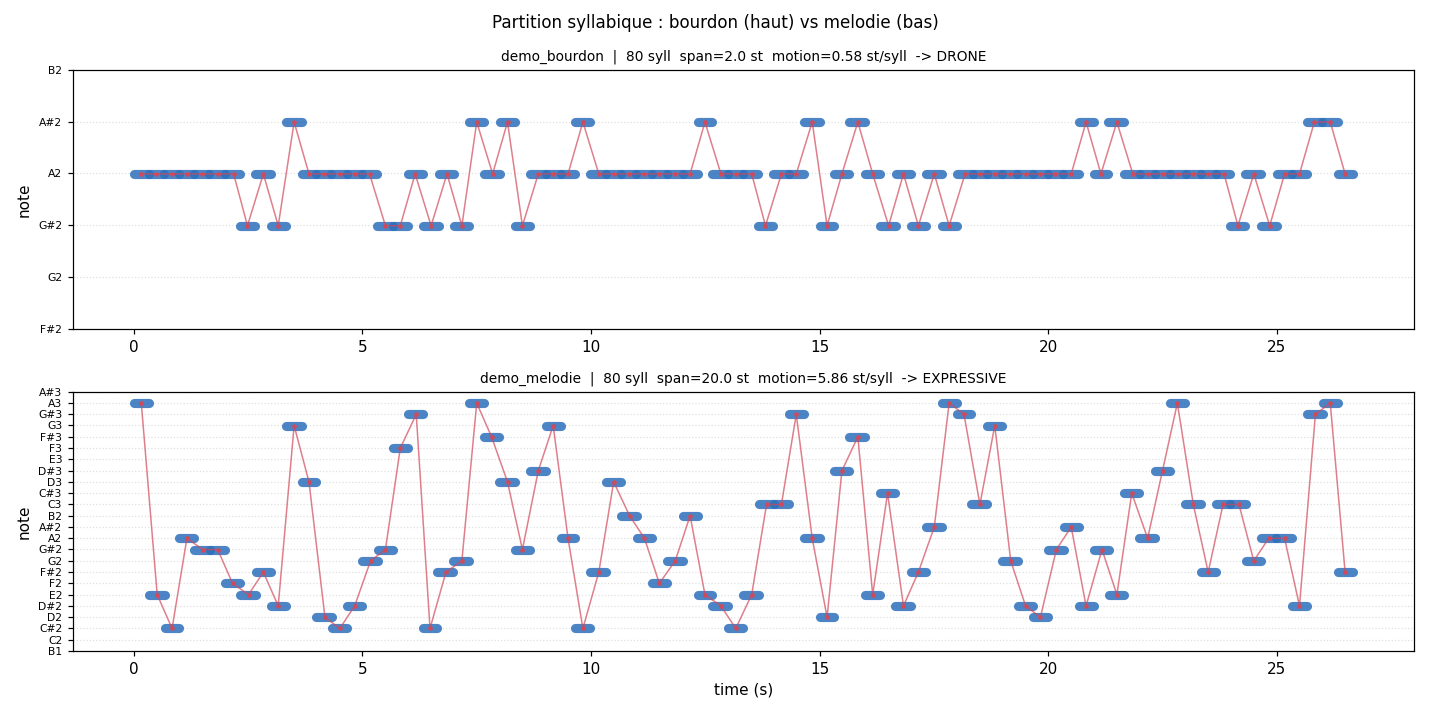
Pour la demonstration, l’instrument fournit un synthetiseur syllabique (_synth) : il construit un signal ou chaque syllabe dure un tiers de seconde a une hauteur MIDI donnee, avec des harmoniques 1 a 4 qui verrouillent pyin et une enveloppe qui creuse un creux d’amplitude entre les syllabes – exactement ce que la detection de noyaux attend. Deux sequences de 80 syllabes, meme registre (A2 = MIDI 45), meme rythme :
le bourdon : A2 avec un plus ou moins 1 demi-ton rare (trois quarts des syllabes sur la meme note) – le chant monotone que l’annotation est censee eviter ;
la melodie : chaque syllabe tiree dans un ambitus de 21 demi-tons autour de A2 – ce qu’une lecture expressive produit sur la partition.
print_score_table affiche la partition en texte (suite des notes), puis les metriques locales et structurelles, puis le verdict. Les deux clips sont ecrits dans prosodic_output/scores_mesure/ – meme dossier que les livrables P3, aucune donnee externe requise.
# Deux signaux synthetiques au grain syllabique : meme longueur (80 syllabes),# meme registre (A2), meme rythme -- seul le dessin melodique change.# Ground truth par construction : on sait quelle melodie on a ecrite.import randomimport soundfile as sfN_SYLL =80random.seed(42)bourdon_seq = [45+ random.choice([0, 0, 0, 1, -1]) for _ inrange(N_SYLL)]random.seed(42)melodie_seq = [45+ random.choice(range(-8, 13)) for _ inrange(N_SYLL)]analyses = {}for nom, seq in (("demo_bourdon", bourdon_seq), ("demo_melodie", melodie_seq)): y, sr = sp._synth(seq, syll_per_s=3.0) wav = SCORES_DIR / (nom +".wav") sf.write(wav, y, sr) analyses[nom] = sp.analyze_syllables(str(wav)) sp.print_score_table(analyses[nom])
Lisez les deux tables avant le graphique : ce sont les memes 80 syllabes au meme rythme, seule la ligne melodique change. Sur le bourdon, la suite de notes s’ecrase sur A2 et ses voisines ; sur la melodie, elle couvre plus d’une octave. Les lignes VERDICT sont ce que l’instrument conclut, et les lignes structure montrent deja le complement que la lecture locale ne donne pas : combien de notes reellement utilisees (entropie), quelle fraction des syllabes sur les 3 notes dominantes, quelle fraction de la sequence dans des motifs de 3 notes repetes.
La partition rendue ci-dessous rend la difference visible – c’est le livrable qu’une mesure doit produire pour un audit humain : au-dessus, le bourdon s’ecrit sur une ligne ; en dessous, la melodie dessine.
# La partition visible : piano-roll des deux clips empiles.# Chaque barre horizontale = une syllabe a sa hauteur ; la ligne relie les centres.png = SCORES_DIR /"partition_bourdon_vs_melodie.png"sp.plot_score( [analyses["demo_bourdon"], analyses["demo_melodie"]],str(png), title="Partition syllabique : bourdon (haut) vs melodie (bas)",)from IPython.display import Image, displayprint("partition ecrite :", png.name)display(Image(filename=str(png)))
10.2 Deux axes de verdict : pourquoi l’axe local ne suffit pas
Les metriques locales – mean_abs_interval_st (pas moyen entre syllabes consecutives, en demi-tons) et pct_flat_transitions (fraction des transitions de moins d’un demi-ton) – sont mesurables sur n’importe quel clip, meme tres court. Ce sont aussi les plus trompeuses seules : un bourdon qui alterne deux notes voisines a des pas parfaitement sains et glisse sous le radar local. La docstring de l’instrument garde la trace du cas reel qui a motive l’axe structurel : l’extrait v4 de 2 min 30 a manque le verdict FLAT de 0,21 demi-ton sur le motion – mais passait 72,8 % de ses 401 syllabes sur trois demi-tons adjacents, avec 82,2 % de la sequence dans des motifs repetes.
Les metriques structurelles regardent la forme de la melodie elle-meme :
effective_notes : 2 eleve a l’entropie de la distribution des notes – le nombre de notes que le clip utilise vraiment (la reference kokoro expressive mesure 11,8 ; l’extrait v4 drone 6,0) ;
top3_note_pct : fraction des syllabes sur les 3 notes les plus frequentes ;
motif3_repeat_pct : fraction des positions couvertes par un motif de 3 notes qui apparait au moins deux fois.
Le verdict final combine les deux axes : DRONE si un critere structurel tire (notes effectives < 7, top-3 >= 65 %, ou motifs repetes >= 60 %), sinon la lecture locale (FLAT / MODERATE / EXPRESSIVE). La cellule suivante confronte les deux lectures sur les mesures ci-dessus : la colonne « local seul » est ce qu’un detecteur sans axe structurel conclurait ; la colonne « complet » est ce que l’instrument reel conclut.
# Confrontation des deux axes SUR NOS MESURES.# « local seul » : classify_melody sans axes structurels (simulate un detecteur local-only).# « complet » : l'instrument reel, axes local + structure.lignes = []for nom in ("demo_bourdon", "demo_melodie"): a = analyses[nom] loc = sp.classify_melody(a["mean_abs_interval_st"], a["pct_flat_transitions"]) complet = sp.classify_melody( a["mean_abs_interval_st"], a["pct_flat_transitions"], a["effective_notes"], a["top3_note_pct"], a["motif3_repeat_pct"], ) lignes.append((nom, loc["local_verdict"], complet["verdict"], a))entete ="%-14s%-11s%-9s%6s%7s%5s%6s%7s"% ("clip", "local seul", "complet", "motion", "flat%", "effn", "top3%", "motif3%")print(entete)print("-"*len(entete))for nom, lv, fv, a in lignes:print("%-14s%-11s%-9s%6.2f%6.1f%%%5.1f%5.1f%%%6.1f%%"% ( nom, lv, fv, a["mean_abs_interval_st"], a["pct_flat_transitions"], a["effective_notes"], a["top3_note_pct"], a["motif3_repeat_pct"]))
clip           local seul  complet    motion   flat%   effn  top3% motif3%
--------------------------------------------------------------------------
demo_bourdon   FLAT        DRONE        0.58   46.8%    2.3 100.0%   92.3%
demo_melodie   EXPRESSIVE  EXPRESSIVE    5.86    5.1%   17.8  25.0%    0.0%
La colonne decisice est la deuxieme : sur le bourdon, la lecture locale s’arrete a FLAT (chant plat) tandis que le verdict complet dit DRONE – avec les trois raisons structurelles affichees : 2,3 notes effectives sur 80 syllabes, 100 % d’entre elles sur les trois memes notes, 92 % de la sequence dans des motifs repetes. La classe locale dit « ça ne bouge pas » ; la classe structurelle dit « c’est un bourdon » – et c’est la seconde qu’un pipeline de controle doit voir. Le pire cas n’est d’ailleurs pas celui-ci : sur d’autres tirages, et sur le cas reel v4 documente dans l’instrument (rate de 0,21 demi-ton sur le motion), le local glisse a MODERATE – un feu vert – alors que la structure condamne. C’est exactement la quatrieme ligne du tableau suivant : pas locaux sains, verdict DRONE.
Sur la melodie, les deux axes sont d’accord : 17,8 notes effectives, concentration top-3 de 25 %, aucun motif repete. Un detecteur local-only donnerait le meme verdict par chance sur ce cas-ci ; l’axe structurel est ce qui le rend fiable sur le cas qui compte – le bourdon degenere qui imite une lecture saine.
La cellule suivante interroge la politique de verdict sans audio (classify_melody est une fonction pure) pour montrer son asymetrie deliberee et la difference entre « non evalue » et « evalue, rien trouve ».
# La politique de verdict est pure et deterministe : interrogee sans audio.# Asymetrie voulue : FLAT (classe de rejet) survit a une structure non evaluee ;# MODERATE/EXPRESSIVE (feux verts) se degradent en INSUFFICIENT -- un feu vert# qui a saute le detecteur de bourdon n'est pas un feu vert.cas = [ ("chant plat, clip court", (0.4, 75.0, None, None, None)), ("lecture variee, clip court", (2.8, 20.0, None, None, None)), ("lecture variee, clip long evalue propre", (2.8, 20.0, 9.5, 30.0, 20.0)), ("bourdon masque : pas locaux sains", (1.3, 35.0, 5.0, 78.0, 85.0)),]print("%-38s%-12s%-11s%-12s%s"% ("cas", "verdict", "local", "structure", "drone_reasons"))print("-"*108)for label, args in cas: v = sp.classify_melody(*args) dr = v["drone_reasons"]if dr isNone: dr_s ="None (non evalue)"elifnot dr: dr_s ="[] (evalue, rien trouve)"else: dr_s =" ; ".join(dr)print("%-38s%-12s%-11s%-12s%s"% ( label, v["verdict"], v["local_verdict"],"evaluee"if v["structure_assessed"] else"non evaluee", dr_s))
Les trois statistiques de concentration sont des proportions : sur un echantillon court, elles ne veulent plus rien dire. Tirer 3 notes sur 24 syllabes peut donner 40 % de top-3 par pur hasard ; sur 80 syllabes, une telle concentration signale un vrai effondrement melodique. L’instrument fixe donc MIN_SYLL_FOR_STRUCTURE = 60 : en dessous, melody_stats refuse de retourner des zeros silencieux (qui se liraient « propre ») et rend explicitement les cles structurelles a None, avec la raison dans structure_na_reason.
La consequence sur le verdict est une asymetrie deliberee : un FLAT (mesure sur l’axe local seul) survit a une structure non evaluee – c’est une classe de rejet, et s’abstenir l’affaiblirait sur les clips qu’il doit attraper. En revanche MODERATE et EXPRESSIVE sont des feux verts : un feu vert qui a saute le detecteur de bourdon n’en est pas un. Ils se degradent en INSUFFICIENT, que le pipeline amont traduit par une abstention plutot qu’un passage. La distinction None (non evalue) vs [] (evalue, rien trouve) existe pour la meme raison : pas regarde et rien trouve ne doivent pas se ressembler sur un rapport d’audit.
La demonstration : la meme melodie variee, coupee a 24 syllabes – la lecture locale reste saine, mais elle n’est plus certifiable.
# Le seuil d'abstention en pratique : meme melodie variee, coupee a 24 syllabes.random.seed(42)seq_courte = [45+ random.choice(range(-8, 13)) for _ inrange(24)]y, sr = sp._synth(seq_courte, syll_per_s=3.0)wav_court = SCORES_DIR /"demo_melodie_courte.wav"sf.write(wav_court, y, sr)a_court = sp.analyze_syllables(str(wav_court))sp.print_score_table(a_court)
Objectif : construire une sequence de 80 syllabes dont le verdict local n’est PAS FLAT (pas moyens sains, peu de transitions plates) mais dont le verdict complet est DRONE – le leurre symetrique du bourdon de la demonstration, ou la structure repetee est cachee derriere des pas locaux sains.
Contexte : le bourdon de la section 10.1 est un cas facile pour l’axe local (trois quarts des syllabes sur la meme note). Le vrai piege – celui qui a motive l’axe structurel – est une sequence qui bouge localement mais repete : un motif de 3 notes avec des pas de 2 a 4 demi-tons, assez grands pour passer MOTION_FLAT_MAX et rester sous FLATPCT_FLAT_MIN, repete presque tel quel jusqu’a 80 syllabes.
Etape 1 : definir un motif de 3 notes (autour de A2) dont les pas consecutifs font au moins 1.5 demi-ton chacun
Etape 2 : construire la sequence en repetant le motif jusqu’a 80 syllabes (une legere variation d’ordre des notes garde le caractere repetitif)
Etape 3 : synthetiser, analyser, et verifier les trois criteres structurels attendus : effective_notes bas, top3_note_pct tres haut, motif3_repeat_pct proche de 100 %
Indice :effective_notes est pilote par l’entropie – avec seulement 3 notes presentes, il plafonne a 3.0 quelle que soit leur ordre Indice : avec un motif fixe de 3 notes, motif3_repeat_pct couvre toutes les positions – visez la sequence la plus periodique possible
# Exercice a completer : construire un leurre pour l'axe local# Etape 1 : definir un motif de 3 notes dont les pas font >= 1.5 st chacun# Etape 2 : repeter le motif jusqu'a 80 syllabes# Etape 3 : synthetiser, analyser, verifier -- attendu : DRONE avec local != FLAT# Indice : random.seed(7) puis un choix parmi les notes du motifdef leurre_local(n_syll=80):# Retourne une sequence qui passe l'axe local mais echoue structurellement.# TODO etudiantreturnNone# TODO etudiantprint("Exercice a completer")
Exercice a completer
10.4 Limites honnetes de la demonstration
Deux precautions avant de conclure. D’abord, la variance d’execution : les sequences de cette section sont tirees aleatoirement, et deux tirages differents donnent des chiffres differents – sur des mesures reelles de la memoire v4, la meme configuration a rendu 12,9 puis 9,7 notes effectives. Le random.seed fixe rend ce notebook reproductible, mais une ligne de tableau n’est pas une loi : les seuils de l’instrument sont calibres pour separer des classes de clips, pas pour etalonner un clip individuel au dixieme de demi-ton pres.
Ensuite, la nature du signal : le synthetiseur syllabique produit des syllabes propres et periodiques – plus faciles a transcrire qu’une voix TTS reelle, ou le timbre, le jitter et les consonnes perturbent pyin et la detection de noyaux. Sur un vrai clip, l’instrument s’invoque exactement de la meme maniere (analyze_syllables sur le chemin du clip) ; la partition et les verdicts sont simplement plus bruites. C’est la demonstration qui est synthetique, pas l’instrument : ses references de calibration (docstring de melody_stats) ont ete mesurees sur des clips TTS reels.
Avec l’annotation (sections 1 a 9) et la mesure (cette section), le pipeline dispose des deux moities du controle qualite : une intention declarative par segment, et un instrument autonome pour verifier ce que la voix generee en fait au passage P4.
Partition syllabique bourdon vs melodie (section 10, instrument #1877)
Passage a P4 (Generation TTS)
Le fichier book.ssml.md est pret pour la generation TTS : - Chaque segment contient les tags [tag1] [tag2] texte interpretes par FishAudio S2-Pro - Le preset vocal de chaque personnage est documente - Les tags de rythme, emotion et intensite sont positionnes aux endroits stratégiques
Limites de cette approche
L’annotation est basee sur des heuristiques lexicales, pas sur une analyse sémantique profonde
Un modèle LLM (GPT-4, Claude) pourrait ameliorer la detection emotionnelle
Les tags FishAudio sont simules ici (FishAudio S2-Pro n’est pas deploye en Docker)
La mesure de la section 10 est demontree sur signal synthetique controle (clips TTS non versions au depot) ; l’instrument s’invoque identiquement sur un clip reel