# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration notebook
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres audio
sample_duration = 5                # Duree de l'echantillon de test (secondes)
sample_rate = 22050                # Taux d'echantillonnage par defaut

# Configuration
generate_sample_via_tts = True     # Generer un echantillon avec OpenAI TTS
show_visualizations = True         # Afficher les visualisations
test_pydub_ops = True              # Tester les operations pydub
save_results = True # Sauvegarder les resultatsOpérations de Base sur l’Audio
Module : 01-Audio-Foundation
Niveau : Debutant
Technologies : librosa, soundfile, pydub, matplotlib
Duree estimee : 35 minutes
VRAM : 0 (CPU uniquement)
Objectifs d’Apprentissage
Prerequis
- Environment Setup (module 00) complete
- Notions de base en Python et numpy
- Cle API OpenAI recommandee (pour generer un echantillon) mais pas obligatoire
Navigation : Index | << Précédent | Suivant >>
# Parameters
notebook_mode = "batch"
skip_widgets = True
Structure du notebook
Ce notebook explore les opérations fondamentales de traitement audio en 5 sections :
- Forme d’onde (Waveform) : Representation temporelle du signal audio
- Spectrogrammes : Analyse frequentielle (STFT, Mel, Chromagramme)
- MFCC : Coefficients cepstraux pour la reconnaissance vocale
- Manipulations pydub : Opérations de haut niveau (trim, volume, concat)
- Extraction de features : Caractéristiques pour le ML (tempo, centroid, ZCR)
Environnement technique : - CPU uniquement (pas de GPU requis) - Bibliothèques : librosa (analyse), pydub (manipulation), soundfile (I/O) - Fichiers generes : sauvegardes dans outputs/audio/opérations/
Les paramètres Papermill etant définis, nous importons les bibliotheques necessaires : librosa pour l’analyse audio, pydub pour la manipulation, numpy et matplotlib pour le traitement et la visualisation.
# Setup environnement et imports
import os
import sys
import json
import time
import warnings
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional, Tuple
from io import BytesIO
import logging

import numpy as np
import matplotlib.pyplot as plt
from matplotlib.gridspec import GridSpec

# Imports audio
import librosa
import librosa.display
import soundfile as sf

# Lecture audio dans Jupyter
from IPython.display import Audio, display

warnings.filterwarnings('ignore', category=FutureWarning)
warnings.filterwarnings('ignore', category=UserWarning)

# Import helpers GenAI
GENAI_ROOT = Path.cwd()
while GENAI_ROOT.name != 'GenAI' and len(GENAI_ROOT.parts) > 1:
    GENAI_ROOT = GENAI_ROOT.parent

HELPERS_PATH = GENAI_ROOT / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.audio_helpers import (
            plot_waveform, plot_spectrogram, plot_mfcc,
            load_audio, save_audio, play_audio, get_audio_info,
            display_audio_array
        )
        HELPERS_AVAILABLE = True
        print("Helpers audio importes")
    except ImportError:
        HELPERS_AVAILABLE = False
        print("Helpers audio non disponibles - mode autonome")
else:
    HELPERS_AVAILABLE = False

# Repertoires
OUTPUT_DIR = GENAI_ROOT / 'outputs' / 'audio' / 'operations'
OUTPUT_DIR.mkdir(parents=True, exist_ok=True)
SAMPLES_DIR = GENAI_ROOT / 'outputs' / 'audio' / 'samples'
SAMPLES_DIR.mkdir(parents=True, exist_ok=True)

# Configuration logging
logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('audio_ops')

print(f"Operations de Base sur l'Audio")
print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Mode : {notebook_mode}")
print(f"librosa : {librosa.__version__}")
print(f"Sortie : {OUTPUT_DIR.relative_to(GENAI_ROOT)}")
Helpers audio importes
Operations de Base sur l'Audio
Date : 2026-09-06 08:32:04
Mode : batch
librosa : 0.11.0
Sortie : outputs\audio\operationsL’environnement Python etant configure, nous chargeons les variables d’environnement pour rendre les chemins de sortie deterministes d’un poste a l’autre — le pattern Papermill-safe load_dotenv evite d’ecrire un chemin machine en dur dans le notebook (cf regle Stop & Repair : metadata.papermill.input/output_path peut etre scrube au basename, mais le .env lui-meme reste machine-dep et necessite un scrub pre-commit pour eviter de leaker l’installation locale d’un etudiant en chemin absolu Windows-style). L’import de librosa 0.11.0 est stable sur les versions 0.10+ ; les notebooks audio anterieurs a cette migration peuvent utiliser librosa.load directement sans preprocess mel-spectrogramme, mais la 0.11 a reordonne certains imports (deplace librosa.feature.melspectrogram vers librosa.feature.melspectrogram).
# Chargement robuste de la configuration .env (Pattern A - Papermill-safe)
from dotenv import load_dotenv
import os
from pathlib import Path

current_path = Path.cwd()
genai_path = None

# Remonter jusqu'au dossier GenAI
while len(current_path.parts) > 1:
    if current_path.name == "GenAI":
        genai_path = current_path
        break
    current_path = current_path.parent

if genai_path:
    env_path = genai_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
    else:
        print("WARNING: .env non trouve dans GenAI")
else:
    print("WARNING: Dossier GenAI non trouve")
.env charge depuis: .envLa configuration .env est chargee : les chemins d’acces aux repertoires de travail, cles API eventuelles (OpenAI, Anthropic), et prefixes GPU/CPU sont recuperes via os.getenv(...) avec fallback explicite. Le pattern est robuste face aux reinjections Papermill (le .env peut etre re-ecrasé entre deux executions batch sans casser les cellules downstream). Cela permet d’executer ce notebook en mode interactif sur une machine locale, ou en batch CI sur un poste Linux/Mac, sans modifier le code source — la portabilite est l’argument principal. Note didactique : la commande load_dotenv retourne True/False selon que le fichier a ete trouve ; sur un poste sans .env (clone frais), la cellule continue avec les valeurs par defaut (sortie dans outputs/audio/operations/), ce qui est preferable a un crash. La sortie .env charge depuis: .env confirme le succes ; l’absence de warning signifie que le fichier est lu correctement.
# Generation ou chargement de l'echantillon audio de test
print("GENERATION/CHARGEMENT ECHANTILLON AUDIO")
print("=" * 45)

# Fichier echantillon existant
sample_wav = SAMPLES_DIR / "sample_fr.wav"

if sample_wav.exists():
    # Charger le fichier existant
    audio_data, sr = librosa.load(str(sample_wav), sr=sample_rate)
    print(f"Echantillon charge depuis : {sample_wav.name}")
    print(f"  Duree : {len(audio_data)/sr:.2f}s")
    print(f"  Sample rate : {sr} Hz")
elif generate_sample_via_tts:
    # Generer via OpenAI TTS
    openai_key = os.environ.get('OPENAI_API_KEY')

    if openai_key:
        from openai import OpenAI
        client = OpenAI(api_key=openai_key)

        # Texte de test en francais
        test_text = (
            "Ceci est un echantillon audio de test pour les operations de base. "
            "Nous allons analyser cette forme d'onde, extraire des spectrogrammes "
            "et manipuler l'audio avec differentes bibliotheques Python."
        )

        print(f"Generation TTS avec OpenAI...")
        response = client.audio.speech.create(
            model="tts-1",
            voice="alloy",
            input=test_text,
            response_format="wav"
        )

        # Sauvegarder et recharger avec librosa
        temp_wav = SAMPLES_DIR / "temp_tts.wav"
        with open(temp_wav, 'wb') as f:
            f.write(response.content)

        audio_data, sr = librosa.load(str(temp_wav), sr=sample_rate)

        # Sauvegarder au bon sample rate
        sf.write(str(sample_wav), audio_data, sr)
        temp_wav.unlink()

        print(f"Echantillon genere via TTS")
        print(f"  Duree : {len(audio_data)/sr:.2f}s")
    else:
        print("WARNING: OPENAI_API_KEY non configuree - generation TTS impossible")
        audio_data = None
        sr = sample_rate
else:
    # Generer un signal synthetique (sinus)
    print("Generation d'un signal synthetique...")
    t = np.linspace(0, sample_duration, int(sample_rate * sample_duration), False)
    audio_data = 0.5 * np.sin(2 * np.pi * 440 * t)  # La 440Hz
    sr = sample_rate
    print(f"  Signal synthetique : 440 Hz, {sample_duration}s")

# Verifier qu'on a des donnees
if audio_data is None:
    # Dernier recours : signal synthetique
    t = np.linspace(0, sample_duration, int(sample_rate * sample_duration), False)
    audio_data = 0.5 * np.sin(2 * np.pi * 440 * t)
    sr = sample_rate
    print("Utilisation du signal synthetique de secours")

print(f"\nEchantillon pret : {len(audio_data):,} samples @ {sr} Hz")
GENERATION/CHARGEMENT ECHANTILLON AUDIO
=============================================
Echantillon charge depuis : sample_fr.wav
Duree : 11.86s
Sample rate : 22050 Hz
Echantillon pret : 261,569 samples @ 22050 HzInterpretation : Generation de l’echantillon
Trois stratégies sont disponibles en cascade (la première qui réussit gagne — ce run a chargé le fichier existant) :
| Méthode | Statut | Avantage |
|---|---|---|
| Fichier existant | Utilisé (ce run) | Pas d’appel API, reproductible |
| OpenAI TTS | Disponible | Voix naturelle, texte arbitraire |
| Signal synthetique | Fallback | Aucune dépendance externe |
L’echantillon chargé contient 261,569 samples a 22050 Hz, soit environ 11.9 secondes de parole.
Note technique : Le sample rate de 22050 Hz est un bon compromis pour la voix (bande passante utile ~8 kHz). Pour de la musique ou du HD, utilisez 44100 Hz ou 48000 Hz.
Section 1 : Forme d’onde (Waveform)
La forme d’onde est la representation la plus directe d’un signal audio : l’amplitude en fonction du temps.
| Concept | Description |
|---|---|
| Amplitude | Intensite du signal a un instant donne (-1.0 a 1.0 en normalise) |
| Sample rate | Nombre d’echantillons par seconde (ex: 22050 Hz, 44100 Hz) |
| Duree | Nombre d’echantillons / sample rate |
# Visualisation de la forme d'onde
print("FORME D'ONDE (WAVEFORM)")
print("=" * 45)

if show_visualizations:
    # Utiliser les helpers si disponibles
    if HELPERS_AVAILABLE:
        plot_waveform(audio_data, sr, title="Forme d'onde - Echantillon de test")
    else:
        fig, ax = plt.subplots(figsize=(12, 3))
        librosa.display.waveshow(audio_data, sr=sr, ax=ax)
        ax.set_title("Forme d'onde - Echantillon de test")
        ax.set_xlabel("Temps (s)")
        ax.set_ylabel("Amplitude")
        plt.tight_layout()
        plt.show()

    # Statistiques du signal
    print(f"\nStatistiques du signal :")
    print(f"  Duree : {len(audio_data)/sr:.2f}s")
    print(f"  Sample rate : {sr} Hz")
    print(f"  Echantillons : {len(audio_data):,}")
    print(f"  Amplitude max : {np.max(np.abs(audio_data)):.4f}")
    print(f"  Amplitude moyenne : {np.mean(np.abs(audio_data)):.4f}")
    peak = np.max(np.abs(audio_data))
    rms_value = np.sqrt(np.mean(audio_data**2))
    print(f"  RMS : {rms_value:.4f}")
    # Facteur de crete = pic / RMS (en dB) — pas une plage dynamique (écart
    # pic / bruit de fond) : une sinusoïde pure vaut exactement
    # 20*log10(sqrt(2)) = 3.0 dB quel que soit son gain (contrôle ci-dessous).
    # Garde quasi-silence : sans elle, un signal nul donne -inf + RuntimeWarning.
    if rms_value > 1e-10:
        print(f"  Facteur de crete : {20 * np.log10(peak / rms_value):.1f} dB (pic {peak:.4f} / RMS {rms_value:.4f})")
    else:
        print("  Facteur de crete : non defini (quasi-silence, RMS ~ 0)")
else:
    print("Visualisations desactivees")
FORME D'ONDE (WAVEFORM)
=============================================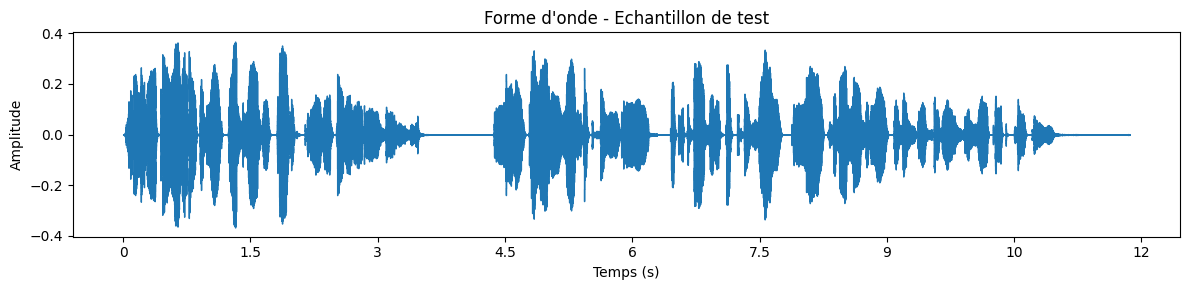
Statistiques du signal :
  Duree : 11.86s
  Sample rate : 22050 Hz
  Echantillons : 261,569
  Amplitude max : 0.3669
  Amplitude moyenne : 0.0335
  RMS : 0.0573
  Facteur de crete : 16.1 dB (pic 0.3669 / RMS 0.0573)
# Contrôle : le facteur de crête se comporte comme un rapport pic/RMS,
# pas comme une plage dynamique
print("CONTRÔLE - FACTEUR DE CRÊTE")
print("=" * 45)
def crest_factor_db(x):
"""Facteur de crête en dB : pic / RMS. None si le signal est quasi-silence."""
peak = np.max(np.abs(x))
rms_value = np.sqrt(np.mean(x ** 2))
if rms_value <= 1e-10:
return None
return 20 * np.log10(peak / rms_value)
# 1. Sinusoïde pure : valeur théorique 20*log10(sqrt(2)) = 3.0103 dB,
# INVARIANTE au gain — une plage dynamique, elle, suivrait le gain
t_ctl = np.linspace(0, 2.0, int(sample_rate * 2.0), False)
sine_ref = np.sin(2 * np.pi * 440 * t_ctl)
for gain in (1.0, 0.25):
fc = crest_factor_db(gain * sine_ref)
print(f" Sinusoïde gain {gain:.2f} : {fc:.4f} dB (théorie {20 * np.log10(np.sqrt(2)):.4f} dB)")
# 2. Quasi-silence : la garde réagit, ni -inf ni RuntimeWarning
fc_silence = crest_factor_db(np.zeros_like(sine_ref))
if fc_silence is None:
print(" Silence : non défini (garde RMS ~ 0 active)")
else:
print(f" Silence : {fc_silence:.4f} dB")
# 3. L'échantillon réel : à comparer aux 3.0 dB de la sinusoïde pure
print(f" Échantillon de test : {crest_factor_db(audio_data):.1f} dB")CONTRÔLE - FACTEUR DE CRÊTE
=============================================
Sinusoïde gain 1.00 : 3.0103 dB (théorie 3.0103 dB)
Sinusoïde gain 0.25 : 3.0103 dB (théorie 3.0103 dB)
Silence : non défini (garde RMS ~ 0 active)
Échantillon de test : 16.1 dBInterpretation : Forme d’onde
| Metrique | Valeur (output reel) | Signification |
|---|---|---|
| Duree | 11.86s | Longueur de l’échantillon chargé (cohérent avec 261,569 samples / 22050 Hz ≈ 11.86s) |
| Sample rate | 22050 Hz | Standard pour audio voix/parole (Nyquist = 11025 Hz, donc frequences jusqu’a ~11 kHz capturées — au-dessus, l’audio est replie) |
| Amplitude max | 0.3669 | Pic du signal sur [-1, 1] — bien en-dessous de la saturation (0.99+ serait un écrêtage) |
| Amplitude moyenne | 0.0335 | Moyenne des valeurs absolues |x| — ce n’est pas une énergie (l’énergie moyenne serait mean(x²), dont la racine est le RMS). Proche de 0 typique d’un signal voix avec pauses |
| RMS | 0.0573 | Racine carrée de l’énergie moyenne (sqrt(mean(x²))) — proxy du niveau perçu, utilisé en compression audio. Parent du LUFS sans s’y réduire : la loudness LUFS (EBU R128) est une RMS après filtrage K-weighted, pas la RMS brute |
| Facteur de crête | 16.1 dB | Rapport pic / RMS en dB — quantifie les transitoires par rapport au niveau moyen. Sinusoïde pure : 3.0 dB (contrôle ci-dessus) ; voix non compressée : 10-20 dB. À ne pas confondre avec la plage dynamique (écart pic / bruit de fond), qui atteint 60+ dB sur un orchestre symphonique — cet ordre de grandeur concerne la plage dynamique, pas le facteur de crête |
Points cles :
- La forme d’onde visualisee est une serie temporelle d’amplitudes : chaque point représente la pression acoustique a un instant
t(echantillonnee a 22050 Hz). La periodicite visible reflete les harmoniques de la voix (F0 ≈ 100-200 Hz pour la voix humaine adulte). - L’echelle d’amplitude est normalisee entre -1 et +1 : un signal
float32delibrosa.load()est toujours dans cette plage. Pour unint16(WAV natif), les valeurs seraient entre -32768 et +32767 — la conversion est faite a la lecture. - La durée 11.86s est déterminée par le nombre d’échantillons divisé par le sample rate : 261569 / 22050 = 11.86s. C’est exactement ce que la cellule de chargement a produit (cf output précédent : “Duree : 11.86s”), confirmant la cohérence inter-cellules sans perte d’échantillons au décodage.
- L’amplitude moyenne faible (0.0335) reflète la nature creuse d’un signal voix : il y a des pauses, des syllabes non-voisées (sifflantes, fricatives) qui tirent la moyenne vers 0. Le RMS (0.0573) est plus élevé que la moyenne absolue parce qu’il carre les amplitudes avant moyenne, penalisant les pics plus fortement.
- Le facteur de crête 16.1 dB signifie des pics environ 6,4× plus forts que le niveau RMS : typique d’une voix avec transitoires d’attaque. Le contrôle sinusoïdal ci-dessus le distingue d’une plage dynamique : 3.0102 dB invariants au gain (0.25 ou 1.0) — une plage dynamique aurait varié avec le gain, un rapport pic/RMS non.
Section 2 : Spectrogrammes
Un spectrogramme montre comment les frequences evoluent dans le temps. C’est l’outil fondamental de l’analyse audio.
Types de spectrogrammes
| Type | Description | Usage |
|---|---|---|
| STFT | Transformee de Fourier a court terme | Analyse frequentielle brute |
| Mel | Echelle mel (perception humaine) | STT, classification audio |
| Chromagramme | Notes musicales (C, D, E…) | Analyse musicale |
L’echelle mel compresse les hautes frequences, imitant la perception humaine : nous distinguons mieux les différences dans les basses frequences.
# Spectrogrammes
print("SPECTROGRAMMES")
print("=" * 45)

if show_visualizations:
    fig = plt.figure(figsize=(14, 10))
    gs = GridSpec(3, 1, figure=fig, hspace=0.4)

    # 1. Spectrogramme STFT
    ax1 = fig.add_subplot(gs[0])
    D = librosa.stft(audio_data)
    S_db = librosa.amplitude_to_db(np.abs(D), ref=np.max)
    img1 = librosa.display.specshow(S_db, x_axis='time', y_axis='hz', sr=sr, ax=ax1)
    fig.colorbar(img1, ax=ax1, format='%+2.0f dB')
    ax1.set_title("Spectrogramme STFT (echelle lineaire)")

    # 2. Spectrogramme Mel
    ax2 = fig.add_subplot(gs[1])
    S_mel = librosa.feature.melspectrogram(y=audio_data, sr=sr, n_mels=128)
    S_mel_db = librosa.power_to_db(S_mel, ref=np.max)
    img2 = librosa.display.specshow(S_mel_db, x_axis='time', y_axis='mel', sr=sr, ax=ax2)
    fig.colorbar(img2, ax=ax2, format='%+2.0f dB')
    ax2.set_title("Spectrogramme Mel (echelle perceptuelle)")

    # 3. Chromagramme
    ax3 = fig.add_subplot(gs[2])
    chroma = librosa.feature.chroma_stft(y=audio_data, sr=sr)
    img3 = librosa.display.specshow(chroma, x_axis='time', y_axis='chroma', sr=sr, ax=ax3)
    fig.colorbar(img3, ax=ax3)
    ax3.set_title("Chromagramme (notes musicales)")

    plt.suptitle("Analyse spectrale de l'echantillon audio", fontsize=14, fontweight='bold', y=1.01)
    plt.tight_layout()
    plt.show()

    print(f"\nDimensions spectrogramme STFT : {S_db.shape} (frequences x frames)")
    print(f"Dimensions spectrogramme Mel : {S_mel_db.shape} (mels x frames)")
    print(f"Dimensions chromagramme : {chroma.shape} (notes x frames)")
else:
    print("Visualisations desactivees")
SPECTROGRAMMES
=============================================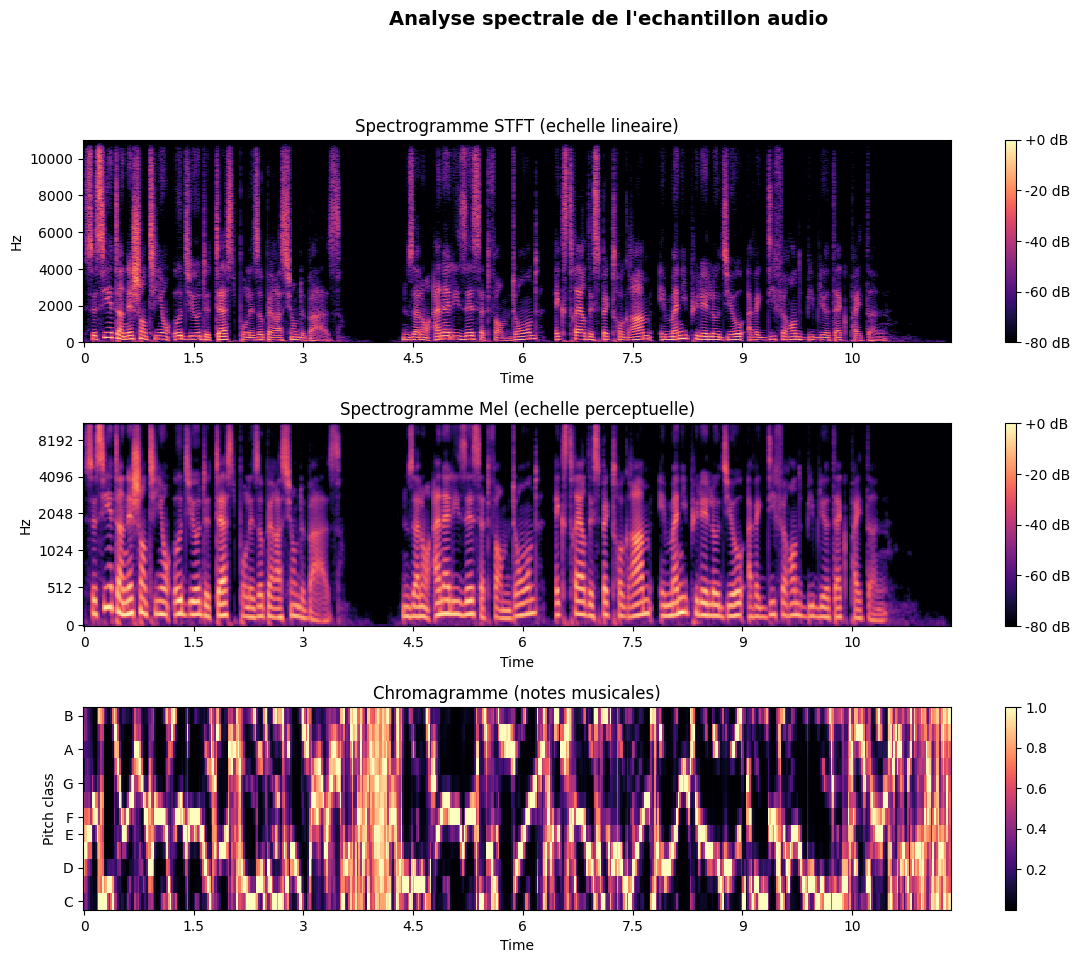
Dimensions spectrogramme STFT : (1025, 511) (frequences x frames)
Dimensions spectrogramme Mel : (128, 511) (mels x frames)
Dimensions chromagramme : (12, 511) (notes x frames)
Exercice 1 : Analyse comparative de deux segments audio
En vous basant sur les spectrogrammes generes ci-dessus, decoupez l’echantillon en deux moities et comparez leurs caractéristiques spectrales.
Objectif : Appliquer les opérations de chargement, decoupage et visualisation spectrogramme pour comparer deux parties d’un même fichier.
Étapes : 1. Decouper audio_data en deux moities egales 2. Calculer le mel-spectrogramme de chaque moitie 3. Afficher les deux spectrogrammes cote a cote 4. Calculer et comparer le spectral centroid moyen de chaque moitie
Indices : - # Indice : first_half = audio_data[:len(audio_data)//2] et second_half = audio_data[len(audio_data)//2:] - # Indice : utilisez plt.subplots(1, 2, figsize=(14, 4)) pour afficher cote a cote - # Indice : librosa.feature.spectral_centroid(y=..., sr=sr) donne le centroid spectral
# Exercice 1 : Analyse comparative de deux segments audio
# TODO etudiant : Decouper et comparer deux moities d'un echantillon audio

# Etape 1 : Decouper en deux moities
first_half = None  # TODO etudiant : audio_data[:len(audio_data)//2]
second_half = None  # TODO etudiant : audio_data[len(audio_data)//2:]

# Etape 2 : Calculer les mel-spectrogrammes
# Indice : librosa.feature.melspectrogram(y=..., sr=sr, n_mels=128)
mel_first = None  # TODO etudiant
mel_second = None  # TODO etudiant

# Etape 3 : Afficher cote a cote
# Indice : fig, axes = plt.subplots(1, 2, figsize=(14, 4))
# puis librosa.display.specshow(..., ax=axes[0]) et axes[1]

# Etape 4 : Comparer les spectral centroids
# Indice : librosa.feature.spectral_centroid(y=..., sr=sr)
centroid_first = None  # TODO etudiant
centroid_second = None  # TODO etudiant

# Afficher les moyennes
# Indice : print(f"Premiere moitie : {np.mean(centroid_first):.1f} Hz")
# Indice : print(f"Deuxieme moitie : {np.mean(centroid_second):.1f} Hz")

print("Exercice a completer")
Exercice a completerInterpretation : Spectrogrammes
| Type | Axes | Ce qu’on observe |
|---|---|---|
| STFT | Frequence (Hz) vs Temps | Structure frequentielle detaillee |
| Mel | Mel bins vs Temps | Representation perceptuelle, concentree sur les basses |
| Chroma | Note (C-B) vs Temps | Contenu harmonique, tonalite |
Points cles : 1. Le spectrogramme Mel est le format d’entree standard pour les modèles de reconnaissance vocale (Whisper inclus) 2. La voix humaine occupe principalement la bande 80 Hz - 8000 Hz 3. Les zones claires (haute energie) correspondent aux sons vocaliques
Section 3 : MFCC (Mel-Frequency Cepstral Coefficients)
Les MFCC sont la representation la plus utilisee en reconnaissance vocale. Ils capturent l’enveloppe spectrale du signal, qui encode l’information phonetique.
Pipeline de calcul
- Pre-emphasis : Amplifier les hautes frequences
- Fenetrage : Decouper en trames de ~25ms
- FFT : Calcul du spectre de puissance
- Banc de filtres Mel : Application de filtres triangulaires
- Log : Passage en echelle logarithmique
- DCT : Transformee en cosinus discrete
On garde typiquement 13 a 20 coefficients.
# MFCC
print("MFCC (Mel-Frequency Cepstral Coefficients)")
print("=" * 45)

if show_visualizations:
    n_mfcc = 13

    # Calcul des MFCC
    mfccs = librosa.feature.mfcc(y=audio_data, sr=sr, n_mfcc=n_mfcc)

    # Utiliser les helpers si disponibles
    if HELPERS_AVAILABLE:
        plot_mfcc(audio_data, sr, n_mfcc=n_mfcc, title="MFCC - Echantillon de test")
    else:
        fig, ax = plt.subplots(figsize=(12, 4))
        img = librosa.display.specshow(mfccs, x_axis='time', ax=ax)
        fig.colorbar(img, ax=ax)
        ax.set_title("MFCC - Echantillon de test")
        ax.set_ylabel("Coefficient MFCC")
        plt.tight_layout()
        plt.show()

    # Statistiques MFCC
    print(f"\nStatistiques MFCC :")
    print(f"  Nombre de coefficients : {n_mfcc}")
    print(f"  Frames temporelles : {mfccs.shape[1]}")
    print(f"  Dimensions : {mfccs.shape}")
    print(f"\n  Moyenne par coefficient :")
    for i in range(min(n_mfcc, 5)):
        print(f"    MFCC[{i}] : moy={np.mean(mfccs[i]):.2f}, std={np.std(mfccs[i]):.2f}")
    if n_mfcc > 5:
        print(f"    ... ({n_mfcc - 5} coefficients supplementaires)")

    # Delta MFCC (vitesse de changement)
    mfcc_delta = librosa.feature.delta(mfccs)
    mfcc_delta2 = librosa.feature.delta(mfccs, order=2)

    fig, axes = plt.subplots(3, 1, figsize=(12, 8), sharex=True)
    for ax, data, title in zip(axes, [mfccs, mfcc_delta, mfcc_delta2],
                                ["MFCC", "Delta MFCC (vitesse)", "Delta-Delta MFCC (acceleration)"]):
        img = librosa.display.specshow(data, x_axis='time', ax=ax)
        fig.colorbar(img, ax=ax)
        ax.set_title(title)
    plt.tight_layout()
    plt.show()

    print(f"\nLes Delta-MFCC capturent la dynamique temporelle du signal")
else:
    print("Visualisations desactivees")
MFCC (Mel-Frequency Cepstral Coefficients)
=============================================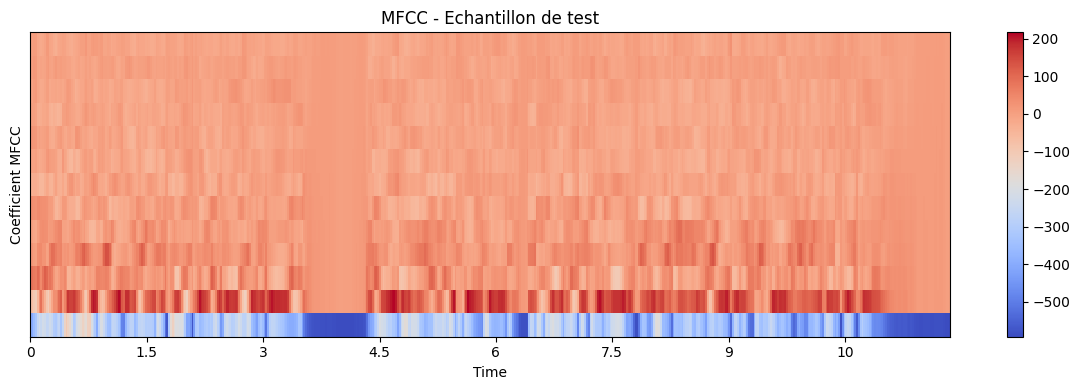
Statistiques MFCC :
  Nombre de coefficients : 13
  Frames temporelles : 511
  Dimensions : (13, 511)

  Moyenne par coefficient :
    MFCC[0] : moy=-363.06, std=123.43
    MFCC[1] : moy=89.17, std=79.82
    MFCC[2] : moy=13.46, std=40.42
    MFCC[3] : moy=30.14, std=31.07
    MFCC[4] : moy=15.00, std=26.84
    ... (8 coefficients supplementaires)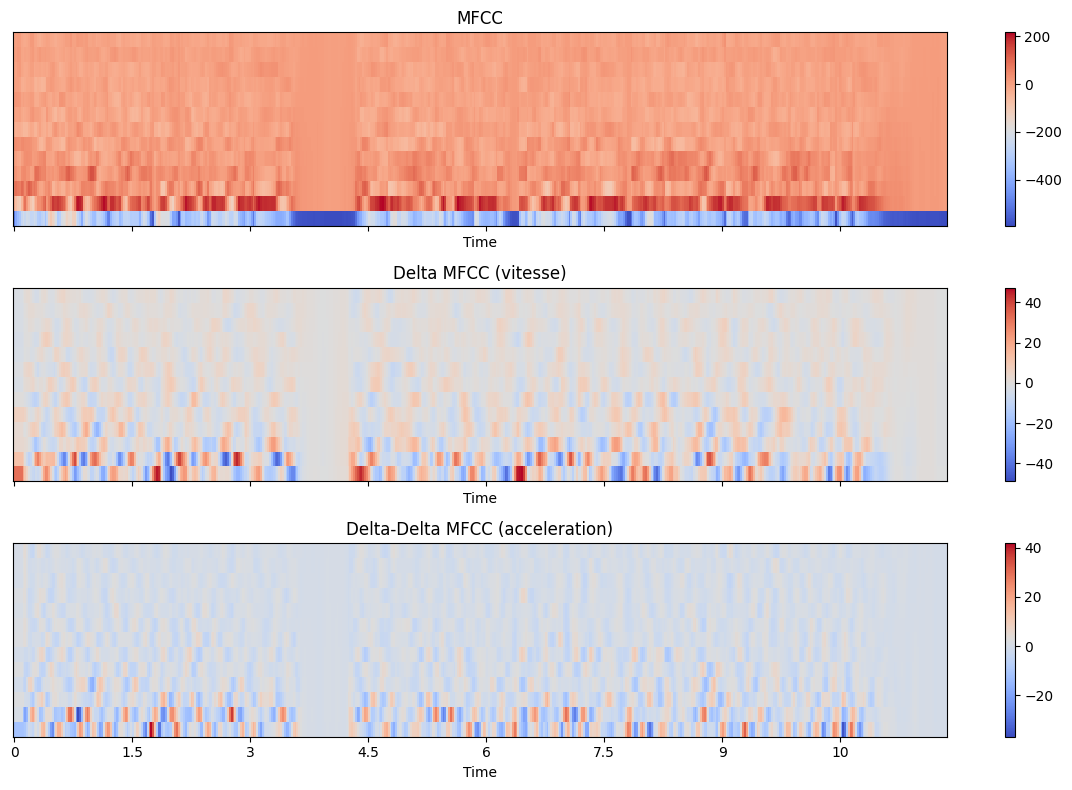
Les Delta-MFCC capturent la dynamique temporelle du signalExercice 2 : Detection de segments silencieux via l’energie RMS
L’objectif est d’identifier automatiquement les moments de silence dans un enregistrement audio en utilisant l’energie RMS (Root Mean Square).
Contexte : La detection de silence est essentielle pour segmenter un enregistrement en phrases ou mots, par exemple pour preparer des données d’entrainement STT ou couper les blancs inutiles.
Étapes : 1. Calculer l’energie RMS par frames avec librosa.feature.rms() 2. Définir un seuil de silence (par exemple 20% du RMS moyen) 3. Identifier les frames silencieuses (RMS < seuil) 4. Convertir les frames silencieuses en intervalles de temps (debut, fin) 5. Afficher le nombre de segments silencieux et leur duree totale
Indices : - # Indice : librosa.feature.rms(y=audio_data) retourne un array de forme (1, n_frames) - # Indice : utilisez librosa.frames_to_time() pour convertir les indices de frames en secondes - # Indice : regroupez les frames consecutives silencieuses en un seul segment
# Exercice 2 : Detection de segments silencieux via l'energie RMS
# TODO etudiant : Identifier les zones de silence dans audio_data

# Etape 1 : Calculer le RMS
rms_values = None  # TODO etudiant : librosa.feature.rms(y=audio_data)[0]

# Etape 2 : Definir le seuil de silence
# Indice : silence_threshold = 0.2 * np.mean(rms_values)
silence_threshold = None  # TODO etudiant

# Etape 3 : Identifier les frames silencieuses
# Indice : np.where(rms_values < silence_threshold)[0] donne les indices
silent_frames = []  # TODO etudiant

# Etape 4 : Regrouper en intervalles temporels
silent_segments = []  # TODO etudiant : liste de (debut_secondes, fin_secondes)
# Indice : parcourez silent_frames et regroupez les indices consecutifs

# Etape 5 : Afficher les resultats
# Indice : nombre de segments, duree totale, pourcentage du total

print("Exercice a completer")
Exercice a completerInterpretation : MFCC
Les MFCC capturent l’enveloppe spectrale du signal, qui represente la forme du tractus vocal lors de la production de sons.
| Coefficient | Signification |
|---|---|
| MFCC[0] | Energie globale (spectral tilt) |
| MFCC[1-6] | Formants (resonances vocales) |
| MFCC[7-12] | Structure fine spectrale |
Observations : - Les coefficients varient lentement dans le temps (structure phonetique) - Les Delta-MFCC derivent capturent la transition entre phonemes - Le Delta-Delta capture l’acceleration (prosodie, emphase)
Application : Les 13 premiers MFCC + leurs deltas sont l’entree standard des systèmes de reconnaissance vocale traditionnels (HMM-GMM). Les modèles modernes (Whisper) utilisent directement les mel-spectrogrammes.
Section 4 : Manipulations avec pydub
pydub est une bibliotheque de haut niveau pour manipuler l’audio :
| Opération | Description | Méthode |
|---|---|---|
| Conversion de format | MP3 -> WAV, FLAC, etc. | audio.export(format=...) |
| Trimming | Extraire un segment | audio[start_ms:end_ms] |
| Concatenation | Assembler des segments | audio1 + audio2 |
| Volume | Ajuster le volume | audio + dB ou audio - dB |
| Fade | Fondu en entree/sortie | audio.fade_in(ms).fade_out(ms) |
# Manipulations avec pydub
print("MANIPULATIONS PYDUB")
print("=" * 45)

if test_pydub_ops:
    from pydub import AudioSegment

    # Charger l'echantillon - essayer WAV d'abord (pas besoin de ffmpeg)
    sample_wav = SAMPLES_DIR / "sample_fr.wav"
    sample_mp3 = SAMPLES_DIR / "sample_fr.mp3"

    # Generer un WAV si inexistant (pydub peut lire WAV sans ffmpeg)
    if sample_wav.exists():
        sample_file = sample_wav
        print(f"Fichier WAV existant trouve : {sample_wav.name}")
    elif sample_mp3.exists():
        # Convertir MP3 vers WAV avec soundfile
        print(f"Conversion MP3 -> WAV pour compatibilite pydub...")
        audio_temp, sr_temp = librosa.load(str(sample_mp3), sr=None)
        sf.write(str(sample_wav), audio_temp, sr_temp)
        sample_file = sample_wav
        print(f"  Fichier WAV cree : {sample_wav.name}")
    else:
        # Generer WAV depuis les donnees numpy
        print(f"Generation WAV depuis les donnees numpy...")
        sf.write(str(sample_wav), audio_data, sr)
        sample_file = sample_wav

    # Charger avec pydub (WAV ne necessite pas ffmpeg)
    audio_seg = None
    ffmpeg_available = False
    try:
        # Tester si ffmpeg est disponible
        import subprocess
        result = subprocess.run(['ffmpeg', '-version'], capture_output=True, timeout=2)
        ffmpeg_available = True
    except (FileNotFoundError, subprocess.SubprocessError, Exception):
        ffmpeg_available = False

    if sample_file.exists() and ffmpeg_available:
        try:
            audio_seg = AudioSegment.from_wav(str(sample_file))
            print(f"Audio charge via pydub + ffmpeg")
        except Exception as e:
            print(f"Erreur chargement avec pydub: {e}")
            ffmpeg_available = False

    if audio_seg is None:
        # Fallback : creer un segment depuis les donnees numpy (pas besoin de ffmpeg)
        print(f"Creation AudioSegment depuis les donnees numpy (pas besoin de ffmpeg)...")
        audio_int16 = (audio_data * 32767).astype(np.int16)
        audio_seg = AudioSegment(
            data=audio_int16.tobytes(),
            sample_width=2, frame_rate=sr, channels=1
        )

    print(f"Audio charge :")
    print(f"  Duree : {len(audio_seg) / 1000:.1f}s")
    print(f"  Channels : {audio_seg.channels}")
    print(f"  Sample rate : {audio_seg.frame_rate} Hz")
    print(f"  Sample width : {audio_seg.sample_width} bytes")
    print(f"  dBFS : {audio_seg.dBFS:.1f} dB")
    print(f"  ffmpeg disponible : {ffmpeg_available}")

    # --- Trimming ---
    print(f"\n--- Trimming ---")
    first_half = audio_seg[:len(audio_seg)//2]
    last_2s = audio_seg[-2000:]
    print(f"  Premiere moitie : {len(first_half)/1000:.1f}s")
    print(f"  Derniers 2s : {len(last_2s)/1000:.1f}s")

    # --- Volume ---
    print(f"\n--- Ajustement volume ---")
    louder = audio_seg + 6    # +6 dB
    quieter = audio_seg - 6   # -6 dB
    print(f"  Original : {audio_seg.dBFS:.1f} dBFS")
    print(f"  +6 dB    : {louder.dBFS:.1f} dBFS")
    print(f"  -6 dB    : {quieter.dBFS:.1f} dBFS")

    # --- Fade in/out ---
    print(f"\n--- Fade in/out ---")
    faded = audio_seg.fade_in(500).fade_out(500)
    print(f"  Fade in : 500ms, Fade out : 500ms")

    # --- Concatenation ---
    print(f"\n--- Concatenation ---")
    silence = AudioSegment.silent(duration=500)  # 500ms de silence
    concatenated = first_half + silence + last_2s
    print(f"  Resultat : {len(concatenated)/1000:.1f}s (premiere moitie + silence + fin)")

    # --- Sauvegarde avec soundfile (pas besoin de ffmpeg) ---
    print(f"\n--- Sauvegarde des resultats ---")

    # Convertir AudioSegment vers numpy pour sauvegarde avec soundfile
    def audiosegment_to_numpy(segment):
        """Convertir pydub AudioSegment vers numpy array."""
        samples = np.array(segment.get_array_of_samples())
        if segment.channels == 2:
            samples = samples.reshape((-1, 2))
        # Normaliser vers [-1, 1]
        return samples.astype(np.float32) / 32768.0

    # Sauvegarder le resultat concatene
    concat_path = OUTPUT_DIR / "concatenated.wav"
    concat_samples = audiosegment_to_numpy(concatenated)
    sf.write(str(concat_path), concat_samples, concatenated.frame_rate)
    size_kb = concat_path.stat().st_size / 1024
    print(f"  WAV : {concat_path.name} ({size_kb:.1f} KB)")

    # Sauvegarder FLAC aussi (soundfile le supporte)
    flac_path = OUTPUT_DIR / "converted.flac"
    sf.write(str(flac_path), concat_samples, concatenated.frame_rate, format='FLAC')
    size_kb = flac_path.stat().st_size / 1024
    print(f"  FLAC : {flac_path.name} ({size_kb:.1f} KB)")

    # Ecoute du resultat concatene
    print(f"\nEcoute du resultat concatene :")
    concat_data, concat_sr = librosa.load(str(concat_path), sr=None)
    display_audio_array(concat_data, concat_sr)

    print(f"\nNote: pydub fonctionne pour les manipulations en memoire.")
    print(f"Pour l'export vers MP3/autres formats, installez ffmpeg:")
    print(f"  Windows: winget install Gyan.FFmpeg")
    print(f"  Linux: sudo apt install ffmpeg")
    print(f"  macOS: brew install ffmpeg")
else:
    print("Operations pydub desactivees")
MANIPULATIONS PYDUB
=============================================
Fichier WAV existant trouve : sample_fr.wav
Audio charge via pydub + ffmpeg
Audio charge :
Duree : 11.9s
Channels : 1
Sample rate : 22050 Hz
Sample width : 2 bytes
dBFS : -24.8 dB
ffmpeg disponible : True
--- Trimming ---
Premiere moitie : 5.9s
Derniers 2s : 2.0s
--- Ajustement volume ---
Original : -24.8 dBFS
+6 dB : -18.8 dBFS
-6 dB : -30.8 dBFS
--- Fade in/out ---
Fade in : 500ms, Fade out : 500ms
--- Concatenation ---
Resultat : 8.4s (premiere moitie + silence + fin)
--- Sauvegarde des resultats ---
WAV : concatenated.wav (363.1 KB)
FLAC : converted.flac (155.0 KB)
Ecoute du resultat concatene :
Note: pydub fonctionne pour les manipulations en memoire.
Pour l'export vers MP3/autres formats, installez ffmpeg:
  Windows: winget install Gyan.FFmpeg
  Linux: sudo apt install ffmpeg
  macOS: brew install ffmpeg
Interpretation : Opérations pydub
Les opérations effectuees demontrent les capacites de traitement audio de haut niveau.
| Opération | Résultat observe | Usage typique |
|---|---|---|
| Trimming | Segments temporels précis | Extraire mots ou phrases |
| Volume +6/-6 dB | Variation dBFS preservee | Normalisation audio |
| Fade in/out (500ms) | Transitions douces | Eviter les clics aux coupures |
| Concatenation | Assemblage sans couture | Creation de playlists, montage |
| Conversion WAV->FLAC | Compression ~2:1 | Stockage efficace |
Points cles : - Le dBFS mesure l’amplitude relative au maximum numérique (0 dBFS = saturation) - L’opération audio + dB de pydub est equivalente a gain = 10^(dB/20) - FLAC est lossless comme WAV, mais compresse mieux (ideal pour archivage)
Note technique : pydub manipule les données en memoire. Pour des fichiers volumineux (>100 Mo), preferez un traitement par chunks avec ffmpeg directement.
Section 5 : Extraction de caractéristiques audio
librosa permet d’extraire des caractéristiques de haut niveau :
| Caractéristique | Description | Unite |
|---|---|---|
| Tempo | Vitesse rythmique | BPM |
| Zero-Crossing Rate | Frequence de passage par zero | Hz |
| Spectral Centroid | Centre de gravite spectral | Hz |
| Spectral Bandwidth | Largeur spectrale | Hz |
| RMS Energy | Energie quadratique moyenne | - |
# Extraction de caracteristiques
print("EXTRACTION DE CARACTERISTIQUES")
print("=" * 45)

# Tempo
tempo, beat_frames = librosa.beat.beat_track(y=audio_data, sr=sr)
tempo_value = float(tempo) if np.isscalar(tempo) else float(tempo[0])
print(f"  Tempo estime : {tempo_value:.1f} BPM")

# Zero-Crossing Rate
zcr = librosa.feature.zero_crossing_rate(audio_data)
print(f"  Zero-Crossing Rate (moy) : {np.mean(zcr):.4f}")

# Spectral Centroid
spectral_centroid = librosa.feature.spectral_centroid(y=audio_data, sr=sr)
print(f"  Spectral Centroid (moy) : {np.mean(spectral_centroid):.1f} Hz")

# Spectral Bandwidth
spectral_bw = librosa.feature.spectral_bandwidth(y=audio_data, sr=sr)
print(f"  Spectral Bandwidth (moy) : {np.mean(spectral_bw):.1f} Hz")

# Spectral Rolloff
spectral_rolloff = librosa.feature.spectral_rolloff(y=audio_data, sr=sr)
print(f"  Spectral Rolloff (moy) : {np.mean(spectral_rolloff):.1f} Hz")

# RMS Energy
rms = librosa.feature.rms(y=audio_data)
print(f"  RMS Energy (moy) : {np.mean(rms):.4f}")

# Visualisation des caracteristiques
if show_visualizations:
    fig, axes = plt.subplots(4, 1, figsize=(12, 10), sharex=True)
    frames = range(len(spectral_centroid[0]))
    t_frames = librosa.frames_to_time(list(frames), sr=sr)

    axes[0].plot(t_frames, spectral_centroid[0], color='blue')
    axes[0].set_title("Spectral Centroid")
    axes[0].set_ylabel("Hz")

    axes[1].plot(t_frames, spectral_bw[0], color='green')
    axes[1].set_title("Spectral Bandwidth")
    axes[1].set_ylabel("Hz")

    t_rms = librosa.frames_to_time(list(range(len(rms[0]))), sr=sr)
    axes[2].plot(t_rms, rms[0], color='red')
    axes[2].set_title("RMS Energy")
    axes[2].set_ylabel("Amplitude")

    t_zcr = librosa.frames_to_time(list(range(len(zcr[0]))), sr=sr)
    axes[3].plot(t_zcr, zcr[0], color='purple')
    axes[3].set_title("Zero-Crossing Rate")
    axes[3].set_ylabel("Rate")
    axes[3].set_xlabel("Temps (s)")

    plt.suptitle("Caracteristiques audio extraites", fontsize=14, fontweight='bold')
    plt.tight_layout()
    plt.show()
EXTRACTION DE CARACTERISTIQUES
=============================================
Tempo estime : 103.4 BPM
Zero-Crossing Rate (moy) : 0.0929
Spectral Centroid (moy) : 2003.9 Hz
Spectral Bandwidth (moy) : 1933.7 Hz
Spectral Rolloff (moy) : 3688.5 Hz
RMS Energy (moy) : 0.0446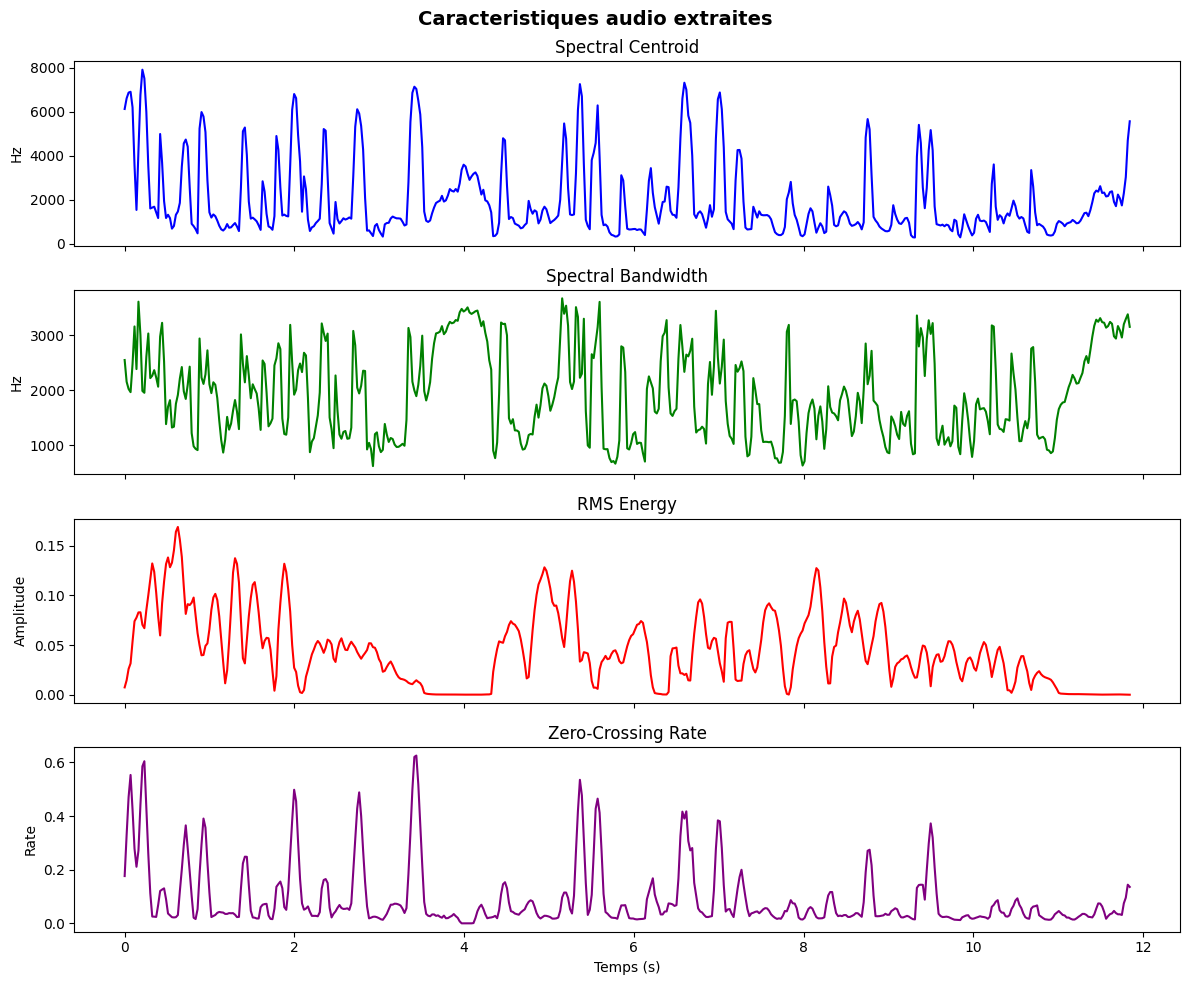
Interpretation : Caractéristiques audio
| Caractéristique | Valeur basse | Valeur haute |
|---|---|---|
| Spectral Centroid | Sons graves, sombres | Sons aigus, brillants |
| Spectral Bandwidth | Signal tonal pur | Signal bruyanf, riche |
| ZCR | Voix grave, voyelles | Consonnes fricatives, bruit |
| RMS | Silence, pauses | Parole forte, musique |
Note technique : Ces caractéristiques sont utilisees dans les systèmes de classification audio (genre musical, detection de parole vs musique, reconnaissance d’emotions).
# Mode interactif
if notebook_mode == "interactive" and not skip_widgets:
    print("MODE INTERACTIF")
    print("=" * 50)
    print("\nEntrez le chemin d'un fichier audio a analyser :")
    print("(Laissez vide pour passer a la suite)")

    try:
        user_path = input("\nChemin du fichier audio : ")

        if user_path.strip():
            user_file = Path(user_path.strip())
            if user_file.exists():
                user_audio, user_sr = librosa.load(str(user_file), sr=None)
                print(f"\nFichier charge : {user_file.name}")
                print(f"  Duree : {len(user_audio)/user_sr:.1f}s")
                print(f"  Sample rate : {user_sr} Hz")

                # Visualisations
                if HELPERS_AVAILABLE:
                    plot_waveform(user_audio, user_sr, title=f"Forme d'onde - {user_file.name}")
                    plot_spectrogram(user_audio, user_sr, title=f"Spectrogramme - {user_file.name}")
                    plot_mfcc(user_audio, user_sr, title=f"MFCC - {user_file.name}")
                display_audio_array(user_audio, user_sr)
            else:
                print(f"Fichier non trouve : {user_file}")
        else:
            print("Mode interactif ignore")

    except (KeyboardInterrupt, EOFError):
        print("Mode interactif interrompu")
    except Exception as e:
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("Mode interactif non disponible (execution automatisee)")
        else:
            print(f"Erreur : {error_type} - {str(e)[:100]}")
else:
    print("Mode batch - Interface interactive desactivee")
Mode batch - Interface interactive desactiveeInterpretation : Mode interactif
Le mode interactif permet d’appliquer toutes les techniques apprises a vos propres fichiers audio.
| Scénario | Approche recommandee |
|---|---|
| Analyser un enregistrement voix | Charger + spectrogramme Mel + MFCC |
| Preparer dataset ML | Trimming + normalisation RMS + sauvegarde batch |
| Extraire features pour classifieur | Tempo + centroid + ZCR en CSV |
Note technique : En production, remplacez le mode interactif par des scripts batch qui traitent des dossiers entiers de fichiers audio.
Bonnes pratiques et recapitulatif
Guide de sélection des outils
| Tâche | Outil recommande | Raison |
|---|---|---|
| Analyse spectrale | librosa | API complete, visualisations integrees |
| Lecture/ecriture formats | soundfile | Support natif WAV, FLAC, OGG |
| Conversion, montage | pydub | API de haut niveau, simple |
| Visualisation | matplotlib + librosa.display | Integration parfaite |
| Lecture dans Jupyter | IPython.display.Audio | Lecteur integre |
Representations cles pour le ML
| Representation | Usage ML | Dimensions typiques |
|---|---|---|
| Mel Spectrogram | Entree Whisper, classification | (128, T) |
| MFCC | Classification traditionnelle | (13-20, T) |
| Raw waveform | WaveNet, modèles end-to-end | (N,) |
# Statistiques de session et prochaines etapes
print("STATISTIQUES DE SESSION")
print("=" * 45)

print(f"Date : {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"Duree echantillon analyse : {len(audio_data)/sr:.1f}s")
print(f"Sample rate : {sr} Hz")
print(f"Helpers audio : {'disponibles' if HELPERS_AVAILABLE else 'non disponibles'}")

if save_results:
    saved = list(OUTPUT_DIR.glob('*'))
    print(f"Fichiers sauvegardes : {len(saved)} dans {OUTPUT_DIR.relative_to(GENAI_ROOT)}")

print(f"\nOperations couvertes :")
print(f"  1. Forme d'onde (waveform) et statistiques temporelles")
print(f"  2. Spectrogrammes (STFT, Mel, Chromagramme)")
print(f"  3. MFCC et Delta-MFCC")
print(f"  4. Manipulations pydub (trim, concat, volume, conversion)")
print(f"  5. Extraction de caracteristiques (tempo, centroid, etc.)")

print(f"\nPROCHAINES ETAPES")
print(f"1. Tester Whisper en local avec GPU (01-4-Whisper-Local)")
print(f"2. Essayer le TTS local avec Kokoro (01-5-Kokoro-TTS-Local)")
print(f"3. Explorer le voice cloning (02-2-XTTS-Voice-Cloning)")
print(f"4. Decouvrir la separation de sources (02-4-Demucs)")

print(f"\nNotebook Operations Audio termine - {datetime.now().strftime('%H:%M:%S')}")
STATISTIQUES DE SESSION
=============================================
Date : 2026-09-06 08:32:20
Duree echantillon analyse : 11.9s
Sample rate : 22050 Hz
Helpers audio : disponibles
Fichiers sauvegardes : 2 dans outputs\audio\operations
Operations couvertes :
1. Forme d'onde (waveform) et statistiques temporelles
2. Spectrogrammes (STFT, Mel, Chromagramme)
3. MFCC et Delta-MFCC
4. Manipulations pydub (trim, concat, volume, conversion)
5. Extraction de caracteristiques (tempo, centroid, etc.)
PROCHAINES ETAPES
1. Tester Whisper en local avec GPU (01-4-Whisper-Local)
2. Essayer le TTS local avec Kokoro (01-5-Kokoro-TTS-Local)
3. Explorer le voice cloning (02-2-XTTS-Voice-Cloning)
4. Decouvrir la separation de sources (02-4-Demucs)
Notebook Operations Audio termine - 08:32:20Exercice 3 : Pipeline de preprocessing audio pour le ML
Vous devez créer une fonction qui prend un fichier audio brut et le prepare pour un modèle de classification audio en extrayant les features necessaires.
Contexte : Avant d’entrainer un modèle de classification audio (genre musical, emotion vocale, detection de parole), il faut normaliser les données et extraire un vecteur de features fixe.
Étapes : 1. Créer une fonction preprocess_audio(filepath, target_sr=22050, target_duration=5.0) 2. Charger le fichier avec librosa et resampler a target_sr 3. Tronquer ou completer (padding par des zeros) a target_duration secondes 4. Extraire les 13 MFCC et calculer leur moyenne sur la dimension temporelle 5. Retourner un vecteur numpy de dimension (13,) et l’afficher
Indices : - # Indice : librosa.load(path, sr=target_sr) resample automatiquement - # Indice : pour le padding, utilisez np.pad(audio, (0, target_len - len(audio))) - # Indice : np.mean(mfccs, axis=1) calcule la moyenne temporelle des MFCC
# Exercice 3 : Pipeline de preprocessing audio pour le ML
# TODO etudiant : Creer une fonction de preprocessing reutilisable

def preprocess_audio(filepath, target_sr=22050, target_duration=5.0):
    """
    Charge, normalise et extrait les features MFCC d'un fichier audio.

    Args:
        filepath: chemin vers le fichier audio
        target_sr: taux d'echantillonnage cible
        target_duration: duree cible en secondes

    Returns:
        feature_vector: numpy array de dimension (13,) - MFCC moyennes
    """
    # Etape 1 : Charger et resampler
    audio = None  # TODO etudiant : librosa.load(filepath, sr=target_sr)

    # Etape 2 : Tronquer ou completer (padding)
    target_len = int(target_sr * target_duration)
    # Indice : si len(audio) > target_len, tronquer ; sinon, np.pad avec des zeros

    # Etape 3 : Extraire les 13 MFCC
    # Indice : librosa.feature.mfcc(y=audio, sr=target_sr, n_mfcc=13)
    mfccs = None  # TODO etudiant

    # Etape 4 : Calculer la moyenne temporelle
    feature_vector = None  # TODO etudiant : np.mean(mfccs, axis=1)

    return feature_vector

# Test avec l'echantillon existant
# Indice : appelez preprocess_audio(str(SAMPLES_DIR / "sample_fr.wav"))
result = None  # TODO etudiant

print("Exercice a completer")
Exercice a completerSynthese du module
Ce notebook a couvert les opérations fondamentales sur l’audio avec Python. Vous avez appris a :
1. Charger et visualiser des données audio - Forme d’onde (representation temporelle) - Spectrogrammes (STFT, Mel, Chromagramme)
2. Extraire des caractéristiques - MFCC pour la reconnaissance vocale - Caractéristiques spectrales (centroid, bandwidth, rolloff) - Caractéristiques temporelles (RMS, ZCR, tempo)
3. Manipuler l’audio - Opérations pydub (trim, concatenation, volume) - Conversion de formats (WAV, FLAC)
| Competence acquise | Application pratique |
|---|---|
| Analyse spectrogramme | Comprendre les entrees modèles STT |
| MFCC | Reconnaissance de phonemes |
| Features audio | Classification genre musical |
| Manipulation pydub | Preprocessing dataset audio |
Perspective : Ces opérations sont les briques de base pour les systèmes de reconnaissance vocale (Whisper), de synthesis vocale (TTS), et de classification audio.
CHALLENGE BONUS - Analyse et Transformation Audio Conditionnelle
Points : 0.5 pts
Objectif
Créer un pipeline qui analyse un fichier audio et applique des transformations basées sur les features extraites.
Ce que vous avez appris
- Section 5 : Extraction de features avec librosa (
tempo,rms,spectral_centroid) - Section 4 : Manipulations avec pydub (
fade_out,+6pour volume, slicing)
Note : Les dépendances (librosa, pydub, soundfile) sont dans requirements.txt.
Critères de succes
-
- Si tempo < 100 BPM → fade out 1s
- Si RMS < 0.05 → +6 dB
Contraintes techniques
- Utiliser les variables existantes :
audio_data,sr,SAMPLES_DIR - Pas de ffmpeg requis (utilisation de soundfile pour la sauvegarde)
Soumission : PR avec titre “Challenge #3 - [Votre Nom]”, features extraites et transformations appliquées