Ce notebook presente l’induction arriere (backward induction), la méthode fondamentale pour resoudre les jeux a information parfaite.
Objectifs d’apprentissage
Maitriser l’algorithme d’induction arriere
Comprendre le jeu du mille-pattes (centipede) et ses paradoxes
Analyser les jeux d’escalade (war of attrition)
Etudier le paradoxe de la chaîne de magasins (Selten)
Explorer les limites de la rationalite parfaite
Prerequis
Notebooks 7-8 : Jeux sous forme extensive et jeux combinatoires
Notions d’equilibre de Nash et de best response
Bases de la recursivite (pour comprendre l’algorithme)
Duree estimee : 55 minutes
Ancres savantes – Kuhn, H.W. (1953), Extensive Games and the Problem of Information, Contributions to the Theory of Games II, Annals of Mathematics Studies 28, Princeton University Press:193-216 (jeux sous forme extensive et induction arriere : representation en arbre de decision, information parfaite, resolution des sous-jeux — la méthode fondamentale enseignee dans ce notebook) ; Rosenthal, R.W. (1981), Games of Perfect Information, Predatory Pricing and the Chain-Store Paradox, Journal of Economic Theory 25(1):92-100 (jeu du mille-pattes / centipede, paradoxe section 2 : la rationalite de l’induction arriere contredit l’intuition) ; Selten, R. (1978), The Chain Store Paradox, Theory and Decision 9(2):127-159 (paradoxe de la chaîne de magasins, déjà nomme “(Selten)” section 4 : un monopoliste national ne punirait jamais rationnellement un entrant, contredit par l’observation empirique) ; Maynard Smith, J. (1974), The Theory of Games and the Evolution of Animal Conflicts, Journal of Theoretical Biology 47(1):209-221 (jeux d’escalade / war of attrition, section 3 : le conflit couteux comme jeu d’engagement progressif en théorie evolutionnaire).
# Configuration et importsimport numpy as npimport matplotlib.pyplot as pltfrom dataclasses import dataclass, fieldfrom typing import List, Dict, Optional, Tuple, Anyfrom collections import defaultdict# Style matplotlibplt.style.use('seaborn-v0_8-whitegrid')plt.rcParams['figure.figsize'] = (12, 6)print("Imports OK : numpy, matplotlib, dataclasses")
Imports OK : numpy, matplotlib, dataclasses
Classes de base pour les jeux sous forme extensive (reprises du notebook 7).
# Classes de base (reprises du notebook 7)@dataclassclass GameNode:"""Noeud dans un arbre de jeu.""" node_id: str player: int# -1 pour terminal, 0 pour nature actions: List[str] = field(default_factory=list) children: Dict[str, 'GameNode'] = field(default_factory=dict) payoffs: Optional[Tuple[float, ...]] =None infoset: Optional[str] =None chance_probs: Optional[Dict[str, float]] =Nonedef is_terminal(self) ->bool:returnself.player ==-1def is_chance(self) ->bool:returnself.player ==0class ExtensiveFormGame:"""Jeu sous forme extensive."""def__init__(self, name: str, num_players: int):self.name = nameself.num_players = num_playersself.root: Optional[GameNode] =Noneself.nodes: Dict[str, GameNode] = {}self.infosets: Dict[str, List[str]] = defaultdict(list)def add_node(self, node: GameNode):self.nodes[node.node_id] = nodeif node.infoset:self.infosets[node.infoset].append(node.node_id)def set_root(self, node: GameNode):self.root = nodeself.add_node(node)print("Classes definies : ExtensiveFormGame, Node (reprises notebook 7)")
Pour les jeux a information parfaite et finis, l’induction arriere est une méthode de resolution optimale :
Partir des feuilles : identifier les noeuds de decision juste avant les terminaux
Remonter : a chaque noeud, le joueur choisit l’action qui maximise son gain (sachant ce qui se passera ensuite)
Repeter jusqu’a la racine
1.2 Proprietes
Trouve un equilibre de Nash parfait en sous-jeux (SPE)
Unique dans les jeux generiques (sans indifferences)
Complexite lineaire en le nombre de noeuds
def backward_induction(game: ExtensiveFormGame) -> Dict[str, Tuple[str, Tuple[float, ...]]]:""" Resout un jeu a information parfaite par induction arriere. Returns: Dict {node_id: (optimal_action, equilibrium_payoffs)} """ solution = {}def solve(node: GameNode) -> Tuple[float, ...]:"""Retourne les gains a l'equilibre depuis ce noeud."""if node.is_terminal():return node.payoffsif node.is_chance():# Esperance sur les resultats de nature expected = np.zeros(game.num_players)for action, prob in node.chance_probs.items(): child_payoffs = solve(node.children[action]) expected += prob * np.array(child_payoffs)returntuple(expected)# Noeud de decision : le joueur maximise son gain player = node.player best_action =None best_payoffs =None best_value =float('-inf')for action in node.actions: child_payoffs = solve(node.children[action]) player_value = child_payoffs[player -1] # Indices 0-basedif player_value > best_value: best_value = player_value best_action = action best_payoffs = child_payoffs solution[node.node_id] = (best_action, best_payoffs)return best_payoffs equilibrium_payoffs = solve(game.root)return solution, equilibrium_payoffsdef display_backward_induction(game: ExtensiveFormGame, solution: Dict):"""Affiche la solution d'induction arriere."""print(f"\nSolution par induction arriere : {game.name}")print("="*60)for node_id, (action, payoffs) in solution.items(): node = game.nodes[node_id]print(f" Noeud {node_id} (J{node.player}): joue '{action}' -> {payoffs}")print('Fonction backward_induction definie')
Fonction backward_induction definie
Application de l’induction retrograde au jeu d’entree sur le marche.
# Exemple : Jeu d'entree sur le marchedef create_entry_game() -> ExtensiveFormGame:"""Jeu d'entree avec Entrant et Incumbant.""" game = ExtensiveFormGame("Entry Game", num_players=2) out_terminal = GameNode("out", -1, payoffs=(0, 2)) fight_terminal = GameNode("fight", -1, payoffs=(-1, -1)) accommodate_terminal = GameNode("accommodate", -1, payoffs=(1, 1)) incumbent_node = GameNode("incumbent", 2, ["Fight", "Accommodate"], infoset="I2") incumbent_node.children = {"Fight": fight_terminal, "Accommodate": accommodate_terminal} entrant_node = GameNode("entrant", 1, ["Enter", "Out"], infoset="I1") entrant_node.children = {"Enter": incumbent_node, "Out": out_terminal} game.set_root(entrant_node)for node in [incumbent_node, out_terminal, fight_terminal, accommodate_terminal]: game.add_node(node)return gameentry_game = create_entry_game()solution, eq_payoffs = backward_induction(entry_game)display_backward_induction(entry_game, solution)print(f"\nGains a l'equilibre: {eq_payoffs}")print("\nInterpretation:")print(" - Si l'Entrant entre, l'Incumbant prefere Accommoder (-1 < 1)")print(" - Sachant cela, l'Entrant prefere Entrer (1 > 0)")print(" -> La menace de 'Fight' n'est pas credible!")
Solution par induction arriere : Entry Game
============================================================
  Noeud incumbent (J2): joue 'Accommodate' -> (1, 1)
  Noeud entrant (J1): joue 'Enter' -> (1, 1)

Gains a l'equilibre: (1, 1)

Interpretation:
  - Si l'Entrant entre, l'Incumbant prefere Accommoder (-1 < 1)
  - Sachant cela, l'Entrant prefere Entrer (1 > 0)
  -> La menace de 'Fight' n'est pas credible!
Lecture chiffree — remonter l’arbre feuille par feuille. Trois terminaux definissent tout le jeu : out (0, 2), fight (-1, -1), accommodate (1, 1). L’induction arriere les lit depuis la fin : au noeud de l’Incumbant, accommoder (1) domine strictement se battre (-1) ; au noeud de l’Entrant, entrer en passant par accommodate (1) domine rester dehors (0). La sortie resume ce double tri — « Noeud incumbent (J2): joue ‘Accommodate’ -> (1, 1) » puis « Noeud entrant (J1): joue ‘Enter’ -> (1, 1) » — et l’equilibre vaut (1, 1). La menace Fight rapporterait (-1, -1) a celui qui l’execute : elle n’est pas credible, non parce qu’elle est impossible, mais parce qu’au moment de la jouer l’Incumbant prefere y renoncer. C’est l’exemple canonique de solution parfaite en sous-jeux, celui que le Mille-Pattes de la section suivante pousse jusqu’a la limite.
2. Le Jeu du Mille-Pattes (Centipede Game)
2.1 Description
Le jeu du mille-pattes est un paradoxe celebre de la théorie des jeux :
Deux joueurs alternent
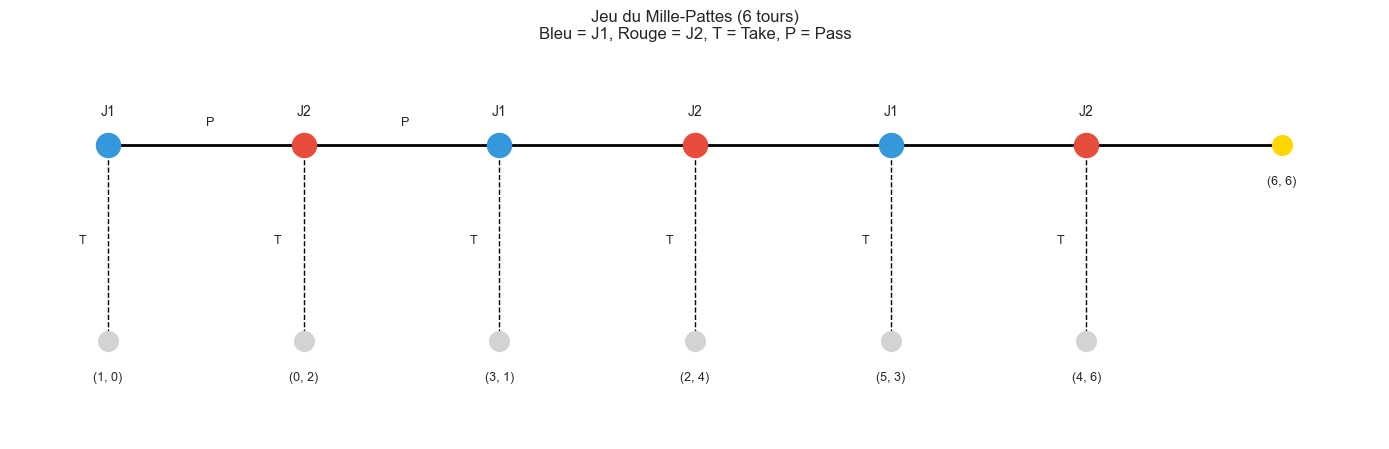
A chaque tour, le joueur actif peut prendre (T) le pot ou passer (P)
Si on passe, les gains augmentent
Le jeu s’arrete après n tours ou quand quelqu’un prend
J1    J2    J1    J2    ...
 o-----o-----o-----o-----o
 |     |     |     |     |
 T     T     T     T     T
 |     |     |     |     |
(1,0) (0,2) (3,1) (2,4) ...
def create_centipede_game(n_rounds: int=6) -> ExtensiveFormGame:""" Cree le jeu du mille-pattes. Gains pour "Take" au tour t: - Joueur qui prend: 1 + 2*(t//2) si t pair, 2*(t//2) si t impair - Autre joueur: le reste de la cagnotte Formule simplifiee: gains croissants """ game = ExtensiveFormGame("Centipede", num_players=2) nodes = []# Gains a chaque tour si "Take"def payoffs_at_round(t):# Les gains augmentent exponentiellement big_pile = t +1 small_pile =max(0, t -1)# Classic centipede: taker gets big pile, other gets small pile player =1if t %2==0else2if player ==1:return (big_pile, small_pile)else:return (small_pile, big_pile)# Creer les noeuds de la fin vers le debut# Dernier terminal (si tous passent)# Final payoffs if everyone passes final_payoffs = (n_rounds, n_rounds) last_pass = GameNode(f"end", -1, payoffs=final_payoffs) nodes.append(last_pass) next_node = last_passfor t inrange(n_rounds -1, -1, -1): player =1if t %2==0else2 payoffs = payoffs_at_round(t) take_terminal = GameNode(f"take_{t}", -1, payoffs=payoffs) nodes.append(take_terminal) decision = GameNode(f"node_{t}", player, ["Take", "Pass"], infoset=f"I{player}_{t}") decision.children = {"Take": take_terminal, "Pass": next_node} nodes.append(decision) next_node = decision game.set_root(next_node)for node in nodes[:-1]: # La racine est deja ajoutee game.add_node(node)return game# Creer et resoudre le jeucentipede = create_centipede_game(n_rounds=6)solution, eq_payoffs = backward_induction(centipede)print("Jeu du Mille-Pattes (6 tours)")print("="*60)print(f"\nGains a l'equilibre: {eq_payoffs}")print(f"\nStrategies optimales (induction arriere):")for node_id insorted(solution.keys(), key=lambda x: int(x.split('_')[1])): action, payoffs = solution[node_id]print(f" {node_id}: {action}")
Jeu du Mille-Pattes (6 tours)
============================================================

Gains a l'equilibre: (1, 0)

Strategies optimales (induction arriere):
  node_0: Take
  node_1: Take
  node_2: Take
  node_3: Take
  node_4: Take
  node_5: Take
Interpretation : La logique implacable de l’induction arriere
Les résultats ci-dessus sont remarquables et contre-intuitifs :
Metrique
Valeur
Signification
Gains equilibre
(1, 0)
J1 obtient 1, J2 n’obtient rien
Stratégie optimale
Take a chaque noeud
Peu importe le tour, le joueur actif devrait prendre
Tour d’arret
0
J1 prend des le premier tour
Deroulement du raisonnement (de la fin vers le debut) :
Tour 5 (J2) : Au dernier noeud, le joueur 2 (impair) obtient la grosse pile : Take rapporte (4, 6) (J2 = 6), Pass mene a (6, 6) (J2 = 6). J2 est donc indifferent entre Take et Pass ; l’induction arriere retient Take (cf. node_5: Take ci-dessus).
Induction : A chaque tour, le joueur actif prefere (ou est indifferent a) Take, car prendre lui assure la grosse pile desormais ; passer ne peut qu’offrir cette meme grosse pile a l’adversaire au tour suivant.
En fait, avec notre formulation, a chaque tour t, le joueur qui prend obtient t+1 (grosse pile), l’autre obtient max(0, t-1) (petite pile).
Par induction arriere, sachant ce que fera le joueur suivant, chaque joueur prefere prendre immediatement.
Le résultat paradoxal : Alors que passer a tous les tours donnerait (6, 6) = 12 de gains totaux, l’equilibre ne donne que 1 de gains totaux !
Note : Ce résultat illustre pourquoi le jeu du mille-pattes est considere comme un des plus grands paradoxes de la théorie des jeux classique.
def visualize_centipede(n_rounds: int=6, figsize=(14, 5)):"""Visualise le jeu du mille-pattes.""" fig, ax = plt.subplots(figsize=figsize)# Positions x_positions = np.arange(n_rounds +1) y_main =1 y_take =0# Calculer les gainsdef payoffs_at_round(t): big_pile = t +1 small_pile =max(0, t -1)# Classic centipede: taker gets big pile, other gets small pile player =1if t %2==0else2if player ==1:return (big_pile, small_pile)else:return (small_pile, big_pile)# Ligne principale (Pass) ax.plot(x_positions, [y_main] * (n_rounds +1), 'k-', linewidth=2)# Noeuds de decision colors = ['#3498db', '#e74c3c'] # Bleu J1, Rouge J2for t inrange(n_rounds): player =1if t %2==0else2 color = colors[player -1]# Noeud de decision ax.scatter(t, y_main, s=300, c=color, zorder=5) ax.annotate(f'J{player}', (t, y_main +0.15), ha='center', fontsize=10)# Branche Take ax.plot([t, t], [y_main, y_take], 'k--', linewidth=1) payoffs = payoffs_at_round(t) ax.scatter(t, y_take, s=200, c='lightgray', zorder=5) ax.annotate(f'{payoffs}', (t, y_take -0.2), ha='center', fontsize=9) ax.annotate('T', (t -0.15, (y_main + y_take) /2), fontsize=9)# Noeud final# Final payoffs if everyone passes final_payoffs = (n_rounds, n_rounds) ax.scatter(n_rounds, y_main, s=200, c='gold', zorder=5) ax.annotate(f'{final_payoffs}', (n_rounds, y_main -0.2), ha='center', fontsize=9)# Labels ax.annotate('P', (0.5, y_main +0.1), fontsize=9) ax.annotate('P', (1.5, y_main +0.1), fontsize=9) ax.set_xlim(-0.5, n_rounds +0.5) ax.set_ylim(-0.5, 1.5) ax.set_aspect('equal') ax.axis('off') ax.set_title(f'Jeu du Mille-Pattes ({n_rounds} tours)\n'f'Bleu = J1, Rouge = J2, T = Take, P = Pass', fontsize=12) plt.tight_layout() plt.show()visualize_centipede(6)
2.2 Le Paradoxe du Mille-Pattes
Prediction théorique : Par induction arriere, J1 devrait “Take” immediatement!
Raisonnement : 1. Au dernier tour, le joueur actif prefere Take 2. Donc l’avant-dernier joueur sait que s’il passe, l’autre prendra 3. Il prefere donc Take lui-même 4. Et ainsi de suite jusqu’au premier tour…
Observations experimentales : En pratique, les joueurs humains passent souvent plusieurs tours!
Explications possibles : - Rationalite limitee - Incertitude sur la rationalite de l’adversaire - Préférences sociales (altruisme, reciprocite) - Apprentissage et reputation
# Simulation: comparaison entre equilibre et comportement "naif"def simulate_centipede_behavior(n_rounds, take_prob_per_round=0.3, n_simulations=10000):""" Simule le jeu avec des joueurs qui prennent avec probabilite p a chaque tour. Modele simplifie : chaque joueur a une probabilite fixe de "Take" a son tour. Cela represente une rationalite limitee ou un comportement experimental typique. """ payoffs_j1 = [] payoffs_j2 = [] stop_rounds = []def payoffs_at_round(t, n_rounds):"""Gains si quelqu'un prend au tour t.""" big_pile = t +1 small_pile =max(0, t -1) player =1if t %2==0else2if player ==1:return (big_pile, small_pile)else:return (small_pile, big_pile)for _ inrange(n_simulations):for t inrange(n_rounds):if np.random.random() < take_prob_per_round: p1, p2 = payoffs_at_round(t, n_rounds) payoffs_j1.append(p1) payoffs_j2.append(p2) stop_rounds.append(t)breakelse:# Tous ont passe - gains finaux (partage egal du pot final) final_payoffs = (n_rounds, n_rounds) payoffs_j1.append(final_payoffs[0]) payoffs_j2.append(final_payoffs[1]) stop_rounds.append(n_rounds)return {'mean_j1': np.mean(payoffs_j1),'mean_j2': np.mean(payoffs_j2),'mean_round': np.mean(stop_rounds),'stop_distribution': np.bincount(stop_rounds, minlength=n_rounds+1) }# Comparer differentes strategiesn =6# Equilibre (Take immediat)centipede = create_centipede_game(n)_, eq_payoffs = backward_induction(centipede)print("Comparaison : Equilibre vs Comportement probabiliste")print("="*60)print(f"\nEquilibre (Take immediat): J1={eq_payoffs[0]}, J2={eq_payoffs[1]}")print(f"Tour d'arret: 0 (J1 prend immediatement)")print("\n--- Simulations avec differentes probabilites de Take ---")for p in [0.1, 0.2, 0.3, 0.5]: result = simulate_centipede_behavior(n, take_prob_per_round=p)print(f"\np={p}: J1={result['mean_j1']:.2f}, J2={result['mean_j2']:.2f}, "f"tour moyen d'arret={result['mean_round']:.2f}")
Comparaison : Equilibre vs Comportement probabiliste
============================================================

Equilibre (Take immediat): J1=1, J2=0
Tour d'arret: 0 (J1 prend immediatement)

--- Simulations avec differentes probabilites de Take ---

p=0.1: J1=4.23, J2=4.27, tour moyen d'arret=4.20

p=0.2: J1=3.02, J2=3.04, tour moyen d'arret=2.93

p=0.3: J1=2.19, J2=2.18, tour moyen d'arret=2.03

p=0.5: J1=1.33, J2=1.15, tour moyen d'arret=0.99
2.3 Interpretation des résultats de simulation
Les simulations ci-dessus revelent un phenomene fascinant :
Stratégie
Gains J1
Gains J2
Total
Interpretation
Equilibre Nash
1
0
1
Prediction théorique
p=0.1 (patient)
~4.2
~4.3
~8.5
Cooperation emergente
p=0.5 (balance)
~1.3
~1.2
~2.5
Compromis théorie/pratique
Le dilemme fondamental : La rationalite parfaite (prendre immediatement) donne un résultat très inferieur a ce que les joueurs pourraient obtenir en “cooperant” (passant plusieurs tours).
C’est exactement ce qu’on observe dans les expériences de laboratoire : les sujets humains passent souvent plusieurs tours, obtenant des gains superieurs a la prediction de l’induction arriere.
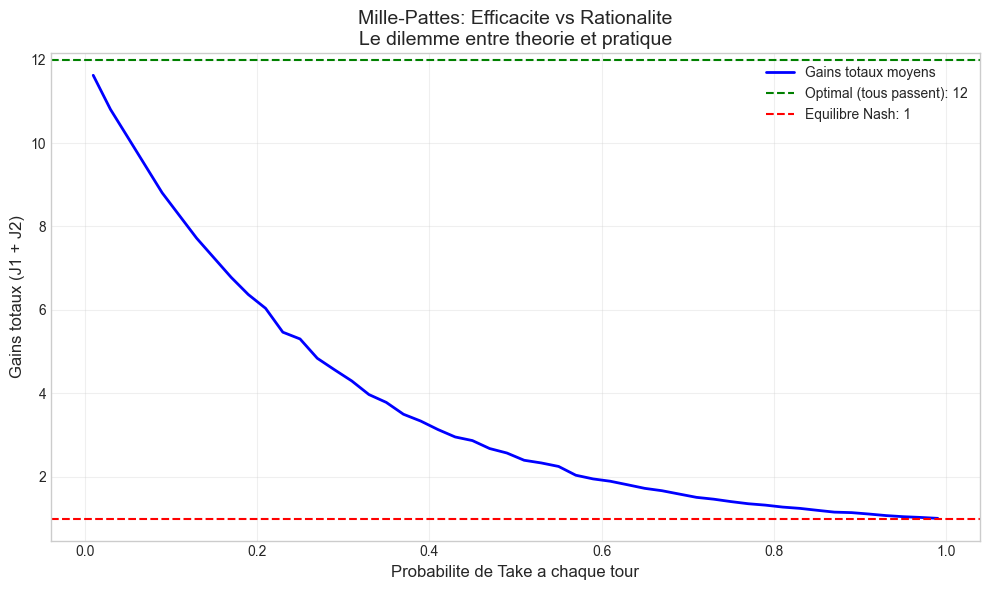
# Visualisation de l'efficacitedef efficiency_analysis(n_rounds=6):"""Analyse l'efficacite en fonction de la probabilite de Take.""" probs = np.linspace(0.01, 0.99, 50) mean_payoffs = []for p in probs: result = simulate_centipede_behavior(n_rounds, p, n_simulations=5000) mean_payoffs.append(result['mean_j1'] + result['mean_j2'])# Gains theoriques optimal =2* n_rounds # Si tous passent: (n_rounds, n_rounds) equilibrium =1# Take au tour 0: (1, 0), total = 1 fig, ax = plt.subplots(figsize=(10, 6)) ax.plot(probs, mean_payoffs, 'b-', linewidth=2, label='Gains totaux moyens') ax.axhline(optimal, color='g', linestyle='--', label=f'Optimal (tous passent): {optimal}') ax.axhline(equilibrium, color='r', linestyle='--', label=f'Equilibre Nash: {equilibrium}') ax.set_xlabel('Probabilite de Take a chaque tour', fontsize=12) ax.set_ylabel('Gains totaux (J1 + J2)', fontsize=12) ax.set_title('Mille-Pattes: Efficacite vs Rationalite\nLe dilemme entre theorie et pratique', fontsize=14) ax.legend() ax.grid(True, alpha=0.3) plt.tight_layout() plt.savefig('centipede_efficiency.png', dpi=150, bbox_inches='tight') plt.show()return mean_payoffsmean_payoffs = efficiency_analysis()
2.4 Le graphique d’efficacite : une lecon sur les limites de la théorie
Le graphique ci-dessus illustre parfaitement le paradoxe du mille-pattes :
Ligne rouge (equilibre Nash) : La théorie predit des gains totaux de seulement 1
Ligne verte (optimal social) : La cooperation parfaite donnerait 12
Courbe bleue (comportement mixte) : Des joueurs imparfaitement rationnels font souvent mieux !
Questions pour reflexion : 1. Pourquoi la théorie echoue-t-elle a predire le comportement reel ? 2. Est-ce que les sujets experimentaux sont “irrationnels” ou “plus intelligents” ? 3. Quel rôle jouent les croyances sur la rationalite de l’adversaire ?
Ces questions ont mene au développement de modèles plus riches : rationalite limitee, jeux de reputation, et apprentissage.
3. Jeux d’Escalade (War of Attrition)
3.1 Description
Deux joueurs s’affrontent pour un prix de valeur V. A chaque tour : - Chacun peut abandonner ou continuer - Continuer coute c par tour - Le dernier en lice gagne V - Si les deux abandonnent : personne ne gagne
3.2 Analyse des résultats : L’avantage du premier joueur
Les résultats de l’analyse montrent que dans ce jeu séquentiel :
J1 obtient toujours V - c (le prix moins le cout du premier tour)
J2 obtient toujours 0 (il abandonne immediatement)
C’est une consequence directe de l’induction arriere : J2 sait qu’il perdra la guerre d’usure car J1 peut toujours attendre un tour de plus. Sachant cela, J2 prefere abandonner tout de suite pour eviter les couts.
En pratique : Les vraies guerres d’usure (encheres, greves, conflits) durent souvent plus longtemps car : - L’horizon temporel est incertain - Les joueurs ont des croyances différentes sur leurs couts respectifs - Des considerations de reputation entrent en jeu
# Analyse de l'equilibre en fonction du ratio V/cdef analyze_war_of_attrition():"""Analyse comment l'equilibre change avec V et c.""" V_values = [5, 10, 15, 20] c_values = [1, 2, 3, 4] results = []for V in V_values:for c in c_values: woa = create_war_of_attrition(max_rounds=6, V=V, c=c) _, eq_payoffs = backward_induction(woa) total = eq_payoffs[0] + eq_payoffs[1] results.append({'V': V, 'c': c, 'ratio': V/c, 'J1': eq_payoffs[0], 'J2': eq_payoffs[1],'total': total})print("Analyse de l'equilibre: War of Attrition")print("="*60)print(f"{'V':>4}{'c':>4}{'V/c':>6}{'J1':>8}{'J2':>8}{'Total':>8}")print("-"*44)for r in results:print(f"{r['V']:>4}{r['c']:>4}{r['ratio']:>6.1f}{r['J1']:>8.1f}{r['J2']:>8.1f}{r['total']:>8.1f}")analyze_war_of_attrition()
Lecture chiffree — une regle, et un ratio qui ne dit rien. Le tableau balaie V dans 5, 10, 15, 20 et c dans 1, 2, 3, 4. Deux regularites le traversent de part en part : J1 vaut exactement V - c sur chaque ligne (5-1 = 4.0, 10-3 = 7.0, 20-4 = 16.0), et J2 vaut 0.0 partout — l’abandon immediat du second joueur, regle posee a la section precedente, verifiee ici combinaison par combinaison. La colonne V/c, elle, ne predit rien : les lignes V=5 c=1, V=10 c=2, V=15 c=3 et V=20 c=4 affichent toutes le ratio 5.0 avec des gains J1 de 4.0, 8.0, 12.0 et 16.0. C’est la difference V - c qui gouverne l’equilibre, pas le rapport — deux guerres d’usure au meme ratio peuvent valoir quatre fois plus.
4. Paradoxe de la Chaîne de Magasins (Selten)
4.1 Le Scénario
Un monopole (chaîne de magasins) fait face a N entrants potentiels sequentiellement : - Chaque entrant decide d’entrer ou non - Si entree, le monopole peut combattre (couteux pour les deux) ou accommoder - Combat : (-1, -1), Accommodate : (1, 1), Pas d’entree : (0, 2)
Question : Le monopole devrait-il combattre les premiers entrants pour dissuader les suivants ?
def create_chain_store_game(n_entrants: int=3) -> ExtensiveFormGame:""" Cree le jeu de la chaine de magasins. Le monopole (J2) fait face a n_entrants sequentiellement (J1_k). Pour simplifier, on considere que c'est toujours "J1" vs "J2". """ game = ExtensiveFormGame(f"Chain Store ({n_entrants} entrants)", num_players=2)# Gains cumules# J1: gains des entrants (simplifies: somme)# J2: gains du monopoledef create_market(market_num, monopoly_total):"""Cree les noeuds pour un marche."""if market_num >= n_entrants:# Fin: gains du monopolereturn GameNode(f"end", -1, payoffs=(0, monopoly_total))# Terminaux pour ce marche stay_out = create_market(market_num +1, monopoly_total +2)# Fight: -1 pour les deux sur ce marche fight_continue = create_market(market_num +1, monopoly_total -1) fight_terminal = GameNode(f"fight_{market_num}", -1, payoffs=(-1, -1))# Accommodate: +1 pour les deux sur ce marche acc_continue = create_market(market_num +1, monopoly_total +1)# Monopole decide monopole = GameNode(f"monopole_{market_num}", 2, ["Fight", "Accommodate"], infoset=f"I2_{market_num}") monopole.children = {"Fight": fight_continue, "Accommodate": acc_continue}# Entrant decide entrant = GameNode(f"entrant_{market_num}", 1, ["Enter", "Out"], infoset=f"I1_{market_num}") entrant.children = {"Enter": monopole, "Out": stay_out}return entrant root = create_market(0, 0)def add_all_nodes(node): game.add_node(node)ifhasattr(node, 'children') and node.children:for child in node.children.values():if child.node_id notin game.nodes: add_all_nodes(child) game.root = root add_all_nodes(root)return game# Version simplifiee pour l'analysedef analyze_chain_store():"""Analyse le paradoxe de la chaine."""print("Paradoxe de la Chaine de Magasins")print("="*60)print("\nMatrice de gains par interaction:")print(" Fight Accommodate")print(f" Enter (-1,-1) (1,1)")print(f" Out -- (0,2)")print("\n"+"="*60)print("\nAnalyse par induction arriere (pour chaque interaction):")print(" - Si l'entrant entre, le monopole prefere Accommodate (1 > -1)")print(" - Sachant cela, l'entrant prefere Enter (1 > 0)")print(" -> Equilibre: (Enter, Accommodate) avec gains (1, 1)")print("\n"+"="*60)print("\nParadoxe:")print(" - Intuition: Le monopole devrait combattre les premiers")print(" entrants pour batir une reputation et dissuader les suivants")print(" - Induction arriere: Cette menace n'est JAMAIS credible!")print(" (au dernier marche, il accommodera toujours)")print(" - Resolution: Besoin d'information incomplete ou")print(" de types 'irrationnels' (voir jeux de reputation)")analyze_chain_store()
Paradoxe de la Chaine de Magasins
============================================================

Matrice de gains par interaction:
                   Fight    Accommodate
  Enter           (-1,-1)     (1,1)
  Out              --        (0,2)

============================================================

Analyse par induction arriere (pour chaque interaction):
  - Si l'entrant entre, le monopole prefere Accommodate (1 > -1)
  - Sachant cela, l'entrant prefere Enter (1 > 0)
  -> Equilibre: (Enter, Accommodate) avec gains (1, 1)

============================================================

Paradoxe:
  - Intuition: Le monopole devrait combattre les premiers
    entrants pour batir une reputation et dissuader les suivants
  - Induction arriere: Cette menace n'est JAMAIS credible!
    (au dernier marche, il accommodera toujours)
  - Resolution: Besoin d'information incomplete ou
    de types 'irrationnels' (voir jeux de reputation)
5.2 Interpretation : L’irrationalite peut etre “rationnelle”
Le tableau ci-dessous revele un résultat contre-intuitif mais profond :
p_rational
Gains totaux
Interpretation
1.0 (tous rationnels)
1
Echec de coordination
0.5 (incertain)
~4
Cooperation emergente
0.0 (tous “irrationnels”)
12
Résultat optimal !
Lecon : Quand un joueur sait que l’autre pourrait etre irrationnel, il peut prendre des risques (passer un tour) qui s’averent benefiques. C’est le fondement des jeux de reputation (Notebook 12).
Application pratique : Dans la vie reelle, une reputation d’“irrationnel” (quelqu’un qui ne cede jamais) peut etre un avantage stratégique, même si le comportement semble sous-optimal localement.
5. Limites de l’Induction Arriere
5.1 Hypotheses fortes
L’induction arriere requiert :
Hypothese
Problème pratique
Rationalite
Les humains ne maximisent pas toujours
Connaissance commune
Tous doivent savoir que tous sont rationnels
Information parfaite
Ne s’applique pas aux jeux avec incertitude
5.2 Alternatives
Rationalite limitee : Les joueurs utilisent des heuristiques
Epsilon-equilibres : Tolerer de petites deviations
Jeux de reputation : Incertitude sur le type de l’adversaire
Apprentissage : Les stratégies evoluent dans le temps
# Simulation: effet de l'incertitude sur la rationalitedef simulate_bounded_rationality_centipede(n_rounds, p_rational=0.9, n_sims=10000):""" Simule le mille-pattes avec joueurs potentiellement 'irrationnels'. Modele: - Chaque joueur est rationnel avec probabilite p_rational - Un joueur rationnel applique l'induction arriere (Take immediat) - Un joueur irrationnel passe toujours (ne prend jamais) Ce modele simple illustre comment l'incertitude sur la rationalite de l'adversaire peut changer dramatiquement les predictions. """def payoffs_at_round(t, n_rounds): big_pile = t +1 small_pile =max(0, t -1) player =1if t %2==0else2if player ==1:return (big_pile, small_pile)else:return (small_pile, big_pile) results = []for _ inrange(n_sims): j1_rational = np.random.random() < p_rational j2_rational = np.random.random() < p_rational# Strategie rationnelle: Take immediat# Strategie irrationnelle: toujours Passif j1_rational:# J1 rationnel prend immediatement p1, p2 = payoffs_at_round(0, n_rounds)else:# J1 passe, c'est a J2if j2_rational: p1, p2 = payoffs_at_round(1, n_rounds)else:# Les deux passent - continuer jusqu'a la fin# Final payoffs if everyone passes p1, p2 = n_rounds, n_rounds results.append((p1, p2)) results = np.array(results)return {'mean_j1': results[:, 0].mean(),'mean_j2': results[:, 1].mean(),'mean_total': results.sum(axis=1).mean() }# Varier la probabilite de rationaliteprint("Effet de l'incertitude sur la rationalite (Mille-Pattes)")print("="*60)print(f"{'p_rational':>12}{'J1':>8}{'J2':>8}{'Total':>8}")print("-"*40)for p in [1.0, 0.95, 0.9, 0.8, 0.7, 0.5, 0.3, 0.0]: result = simulate_bounded_rationality_centipede(6, p_rational=p)print(f"{p:>12.2f}{result['mean_j1']:>8.2f}{result['mean_j2']:>8.2f}{result['mean_total']:>8.2f}")print("\nObservation: Une petite probabilite d'irrationalite")print("peut significativement ameliorer les gains!")
Effet de l'incertitude sur la rationalite (Mille-Pattes)
============================================================
  p_rational       J1       J2    Total
----------------------------------------
        1.00     1.00     0.00     1.00
        0.95     0.97     0.12     1.09
        0.90     0.95     0.23     1.19
        0.80     1.04     0.55     1.60
        0.70     1.25     0.97     2.22
        0.50     2.00     1.99     3.99
        0.30     3.25     3.37     6.62
        0.00     6.00     6.00    12.00

Observation: Une petite probabilite d'irrationalite
peut significativement ameliorer les gains!
Lecture chiffree — l’irrationalite paie, puis renverse l’avantage. A p_rational = 1.00, le tableau retrouve l’equilibre de la theorie : J1 1.00, J2 0.00, Total 1.00. Des que la probabilite d’irrationalite entre, le total monte — 1.09 a 0.95, 1.60 a 0.80, 3.99 a 0.50 — jusqu’a 12.00 a 0.00, ou les deux joueurs « irrationnels » poussent la cagnotte au bout (6.00 chacun). Deux details que la ligne « Observation » de la sortie ne dit pas : la repartition se symetrise en cours de route (2.00 contre 1.99 a p = 0.50), puis s’inverse carrement — a p_rational = 0.30, J2 a 3.37 depasse J1 a 3.25. L’avantage du premier joueur, systematique dans la version parfaitement rationnelle, n’est plus garanti des que la rationalite cesse d’etre commune — exactement l’hypothese que la section citait comme la limite de l’induction arriere.
6. Exercices
Exercice 1 : Ultimatum a 3 tours
Alternating offers bargaining : 1. J1 propose x (partage de 100) 2. J2 accepte ou refuse 3. Si refus, J2 propose y (partage de 90, le gateau retrecit!) 4. J1 accepte ou refuse 5. Si refus, J1 propose z (partage de 80) 6. J2 accepte ou refuse (si refus: (0, 0))
Trouvez l’equilibre par induction arriere.
Exercice 2 : Duel
Deux duellistes s’approchent l’un de l’autre. A chaque pas : - Probabilite de toucher augmente (distance decroit) - Chacun decide de tirer ou d’avancer - Premier qui tire: touche avec proba p(distance), rate sinon
Modelisez et analysez.
Exercice 3 : Stackelberg
Implementez le duopole de Stackelberg: - Leader choisit q1 - Follower observe q1 et choisit q2 - Prix: P = 100 - q1 - q2 - Cout: C(q) = 10q
Discretisez les quantites et appliquez l’induction arriere.
# Exercice 1: Bargainingdef create_bargaining_game():"""Cree le jeu de negociation a 3 tours."""# TODO etudiant : modeliser le jeu de negociationreturnNone# Exercice 2: Dueldef create_duel_game(max_distance=10):"""Cree le jeu de duel."""# TODO etudiant : modeliser le jeu de duelreturnNone# Exercice 3: Stackelbergdef create_stackelberg_duopoly(quantity_choices=[10, 20, 30, 40]):"""Cree le duopole de Stackelberg discretise."""# TODO etudiant : implementer le duopole de StackelbergreturnNoneprint("Exercices a completer : negociation, duel, Stackelberg")
Exercices a completer : negociation, duel, Stackelberg
Exercice 4 : Backward Induction sur un jeu séquentiel
Objectifs :
Appliquer l’algorithme de backward induction
Identifier l’equilibre parfait en sous-jeux (SPE)
Comparer avec l’equilibre de Nash standard
Contexte : Un jeu d’ultimatum modifie avec 3 tours. Le proposeur offre une fraction x, le repondeur accepte ou refuse. Si refus, le proposeur peut faire une nouvelle offre.
Questions :
Tracez l’arbre et appliquez backward induction
L’equilibre est-il unique ?
Comment le résultat change-t-il avec un horizon infini ?
# Exercice 4 : Backward Induction# TODO etudiant : definir le jeu d'ultimatum a 3 tours# Etats: (tour, offre_actuelle, reponse)# Actions: accepter/refuser, ajuster offre# class UltimatumGame:# def __init__(self, total_value=100, rounds=3):# ...## def get_subgame_perfect_equilibrium(self):# # Backward induction# ...# TODO etudiant : implementer backward induction# game = UltimatumGame(rounds=3)# spe = game.get_subgame_perfect_equilibrium()# TODO etudiant : analyser la sensibilite au nombre de tours# for rounds in [2, 3, 5, 10]:# game = UltimatumGame(rounds=rounds)# print(f"Rounds={rounds}: SPE = {game.get_subgame_perfect_equilibrium()}")print("Exercice a completer : backward induction sur jeu sequentiel")
Exercice a completer : backward induction sur jeu sequentiel
Exercice 5 : Jeu de Take-Away (variante de Nim)
Le jeu de Take-Away est un jeu séquentiel a information parfaite : \(n\) jetons sur la table, les joueurs alternent et prennent entre 1 et \(k\) jetons. Celui qui prend le dernier jeton perd. C’est un cas classique d’induction arriere sur un jeu fini.
Objectif : Implementer solve_takeaway_game qui resout le jeu par induction arriere et identifie les positions gagnantes.
Indice : La position 0 est perdante (le joueur qui vient de jouer a pris le dernier). Remontez depuis la fin.
Étape 1 : Initialiser un tableau positions[0..n] : position 0 = perdante
Étape 2 : Pour chaque position p de 1 a n, verifier si il existe une prise t (1..max_take) telle que p-t est perdante pour l’adversaire
Étape 3 : Construire le dictionnaire des prises optimales
# Exercice 5 : Jeu de Take-Away (Nim a 1 tas)def solve_takeaway_game(n_tokens: int, max_take: int=3) ->dict:""" Resout le jeu de Take-Away par induction arriere. Regles : n_tokens au depart. Deux joueurs alternent. A chaque tour, le joueur prend entre 1 et max_take jetons. Celui qui prend le DERNIER jeton perd. Retourne un dict : - "first_player_wins": bool (le premier joueur peut-il gagner ?) - "winning_positions": list[int] (positions gagnantes pour le joueur dont c'est le tour) - "optimal_take": dict[int, int] (pour chaque position, combien prendre) """# TODO etudiant : implementer la resolution par induction arrierereturn {"first_player_wins": False, "winning_positions": [], "optimal_take": {}} # TODO etudiant# Test avec 10 jetons, max 3 prisresult = solve_takeaway_game(10, max_take=3)print(f"Take-Away (n=10, max=3) :")print(f" Premier joueur gagne : {result['first_player_wins']}")print(f" Positions gagnantes : {result['winning_positions']}")print(f" Prise optimale position 10 : {result['optimal_take'].get(10, 'N/A')}")# Test avec 7 jetons, max 2 prisresult2 = solve_takeaway_game(7, max_take=2)print(f"\nTake-Away (n=7, max=2) :")print(f" Premier joueur gagne : {result2['first_player_wins']}")print(f" Positions gagnantes : {result2['winning_positions']}")
Take-Away (n=10, max=3) :
  Premier joueur gagne : False
  Positions gagnantes : []
  Prise optimale position 10 : N/A

Take-Away (n=7, max=2) :
  Premier joueur gagne : False
  Positions gagnantes : []
Lire la sortie d’un exercice non rempli. Deux blocs s’affichent — « Take-Away (n=10, max=3) » puis « Take-Away (n=7, max=2) » — et chacun porte les lignes du contrat : « Premier joueur gagne : False », « Positions gagnantes : [] », « Prise optimale position 10 : N/A ». Les listes vides et le N/A ne sont pas des resultats : c’est l’etat du stub tant que la fonction n’est pas ecrite. Le False de la premiere ligne se lit avec la meme prudence — c’est la valeur par defaut du drapeau, pas un verdict. L’indice de l’enonce donne la marche : position 0 perdante, puis remonter de p en p en cherchant si un coup mene l’adversaire dans une position perdante ; la reponse vraie pour n=10 et n=7 viendra remplir ces lignes.
7. Resume
Concept
Description
Induction arriere
Resoudre des feuilles vers la racine
SPE
Equilibre de Nash parfait en sous-jeux
Mille-pattes
Paradoxe: equilibre vs gains
War of Attrition
Jeu d’escalade couteux
Chain Store
Paradoxe de la reputation
Points cles
L’induction arriere trouve l’equilibre unique (generique)
Les menaces non credibles sont eliminees
Paradoxes : prediction vs comportement observe
La rationalite limitee explique les deviations
Prochaine étape
Notebook 10 : Induction Avant et SPE - Raffinements des equilibres, menaces credibles, et jeux de signaling.
Lien avec la formalisation Lean : L’exercice 5 (Take-Away) est une variante du jeu de Nim, dont les positions gagnantes sont determinees par le theoreme de Sprague-Grundy. Ce theoreme est formellement prouve dans le module Conway/Nim.lean, qui définit la fonction Grundy et demontre que les positions de Nim sont caracterisees par le XOR des tas. Les definitions formelles des jeux combinatoires se trouvent dans lean_game_defs/Combinatorial.lean. Le notebook compagnon GT-8b-Lean-CombinatorialGames explore ces preuves en Lean 4 interactif.
Resume et perspectives
Ce notebook a explore l’induction arriere comme méthode fondamentale de resolution des jeux séquentiels a information parfaite, en l’illustrant a travers trois paradoxes classiques de la théorie des jeux. Le jeu du mille-pattes a revele l’ecart le plus frappant entre prediction théorique (prendre immediatement, gains totaux de 1) et comportement observe (les joueurs cooperent sur plusieurs tours, gains totaux bien superieurs), mettant en lumiere les limites de l’hypothese de rationalite parfaite. Le jeu d’escalade (war of attrition) a montre comment l’avantage du premier joueur est systematiquement renforce par l’induction arriere, l’adversaire abandonnant des le premier tour. Enfin, le paradoxe de la chaîne de magasins de Selten a illustre pourquoi la reputation – une menace de combat repetee – ne peut etre soutenable sous information complete, menant a la necessite de modeliser l’incertitude sur les types d’adversaires.
Les simulations de rationalite limitee ont constitue un résultat marquant : une faible probabilite d’irrationalite suffit a transformer radicalement les résultats, suggerant que la connaissance commune de la rationalite est une hypothese forte dont la relaxation enrichit considerablement le modèle predictif.
Kuhn, H.W. (1953). Extensive Games and the Problem of Information. Contributions to the Theory of Games II, Annals of Mathematics Studies 28, Princeton University Press:193-216.
Rosenthal, R.W. (1981). Games of Perfect Information, Predatory Pricing and the Chain-Store Paradox. Journal of Economic Theory 25(1):92-100.
Selten, R. (1978). The Chain Store Paradox. Theory and Decision 9(2):127-159.
Maynard Smith, J. (1974). The Theory of Games and the Evolution of Animal Conflicts. Journal of Theoretical Biology 47(1):209-221.